
成本、计费与运维
成本、计费与运维 的最新文章。
H100 GPU 价格:定价、成本驱动因素与购买指南
H100 GPU 价格指南:比较 32,200 美元的 PCIe 挂牌价、云端租用价格快照、不同形态,以及本地部署报价背后的总拥有成本(TCO)。

GPU 服务器:架构、性能与云部署指南
通过以工作负载为先的架构、性能测试和生产就绪框架,选择并部署云 GPU 服务器。
免费 LLM API:限制、成本与生产环境权衡
实用指南:了解免费 LLM API 套餐、额度、速率限制、隐性运营成本,以及在用户依赖某条路由前应加入的生产环境控制措施。
云端 GPU 上的 ComfyUI:设置、存储与成本指南
实用指南:了解如何在云端 GPU 上部署 ComfyUI,配置持久化存储、私有访问、按工作负载选择 GPU 以及成本控制。

2026 年最便宜的 LLM API:按工作负载比较价格,而非炒作
一份经来源核查的指南,按工作负载比较低成本 LLM API,涵盖输入、输出、缓存、批处理、工具调用、重试和修复成本。

主权 AI 基础设施:模型、数据驻留与算力控制(2026 年指南)
2026 年主权 AI 基础设施实用指南:涵盖算力、数据、模型、运维四个层面,相关法规、五个主权等级、开放权重模型的推理服务部署,以及 70B 模型在境内 GPU 上运行的成本示例。
H200 vs H100(2026):规格、实际性能、每小时价格与租用建议
2026年 NVIDIA H200 与 H100 对比:官方规格、141GB 显存对 70B 推理的意义、Flatkey Compute、RunPod 和 Lambda 的实际小时租价、Blackwell 替代方案,以及各类工作负载的选型建议。

Anthropic API Key(2026):获取方法、密钥类型、Claude Code 配置与报错修复
2026 年 Anthropic API Key 分步指南:Console 设置、个人密钥与服务账号密钥、过期规则、首个请求代码、Claude Code 配置、费用与报错修复。

Grok API 价格(2026):全部模型、工具费用与计费倍率
xAI Grok API 最新价格:各文本、图像、视频和语音模型单价,长上下文、优先级、美国区域、Batch 和工具五大倍率,成本计算示例,以及与 GPT、Claude、Gemini、Qwen 的价格对比。
Mistral API 价格(2026):全部模型、批量折扣与费用示例
Mistral API 全模型价格表(2026 年 10 月官方数据)、免费额度、批量与缓存折扣、费用计算器、与 GPT/Claude/Gemini/Qwen 的价格对比及接入代码。
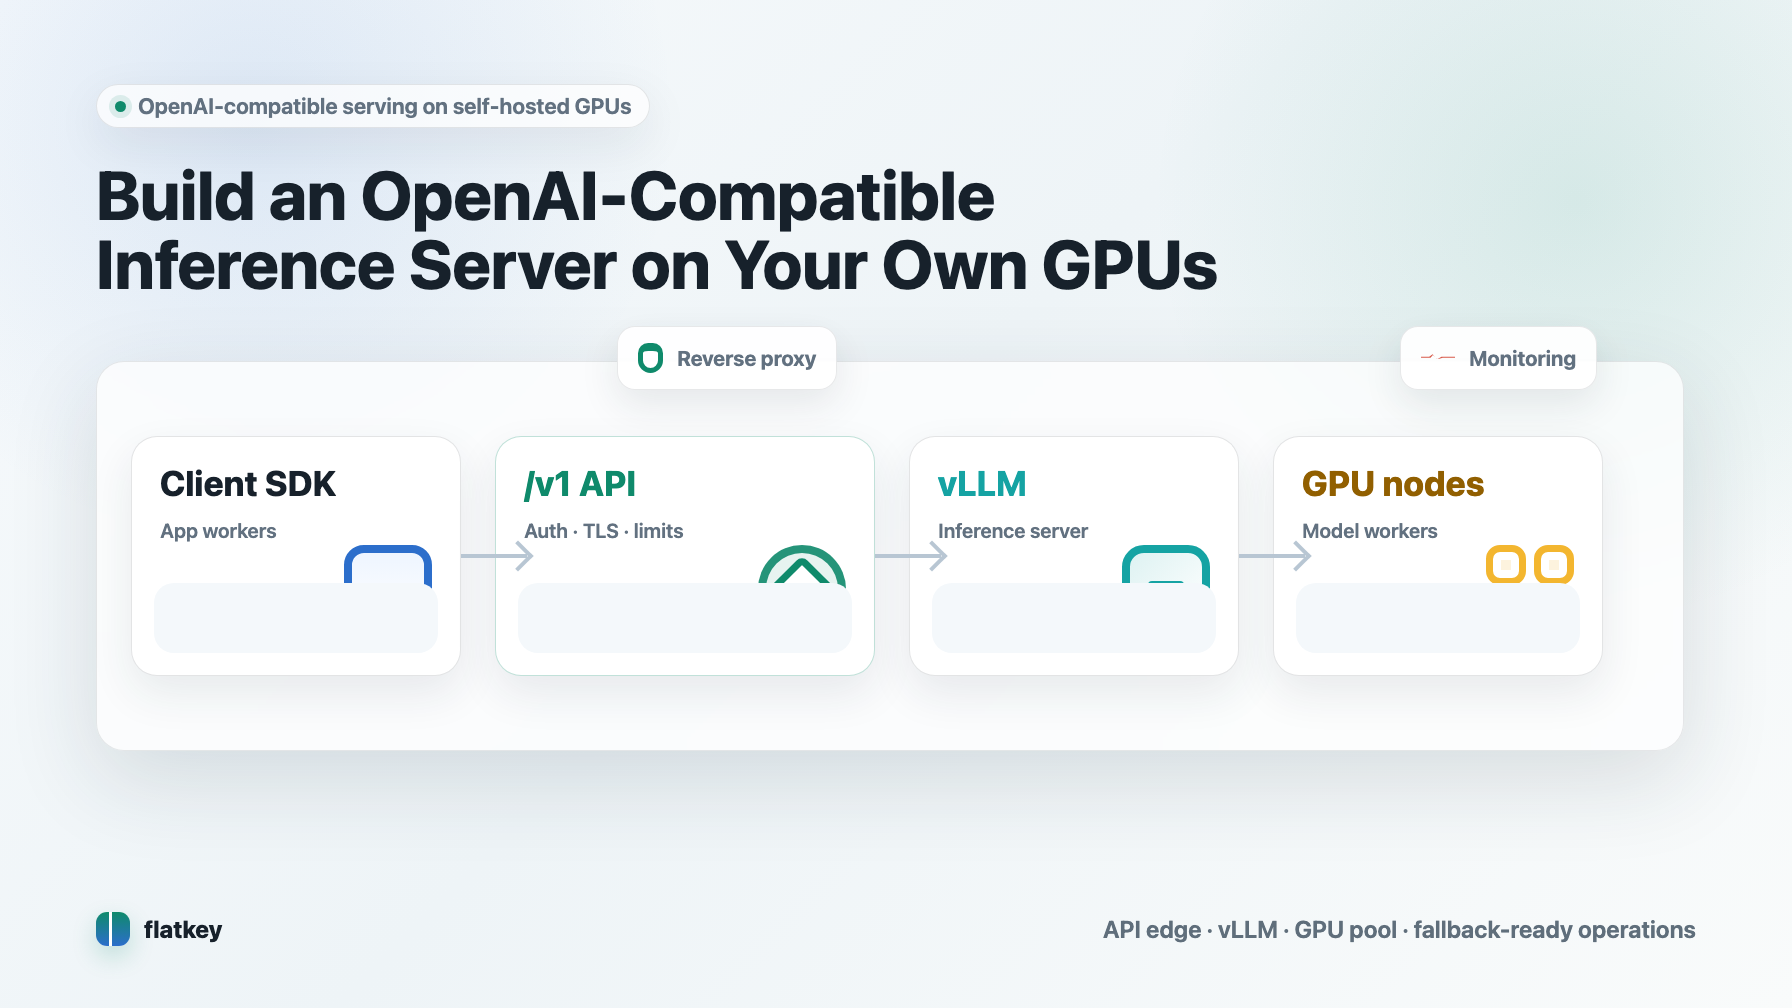
LLM 自托管指南(2026):何时划算、需要什么硬件,以及如何提供推理服务
LLM 自托管是在你掌控的 GPU 上运行开放权重模型。本文结合 2026 年 10 月的 GPU 价格,介绍何时比按 token 计费的 API 更划算、如何估算 GPU 显存、选择推理服务工具,以及如何部署兼容 OpenAI 的 vLLM 服务并配置备用方案。
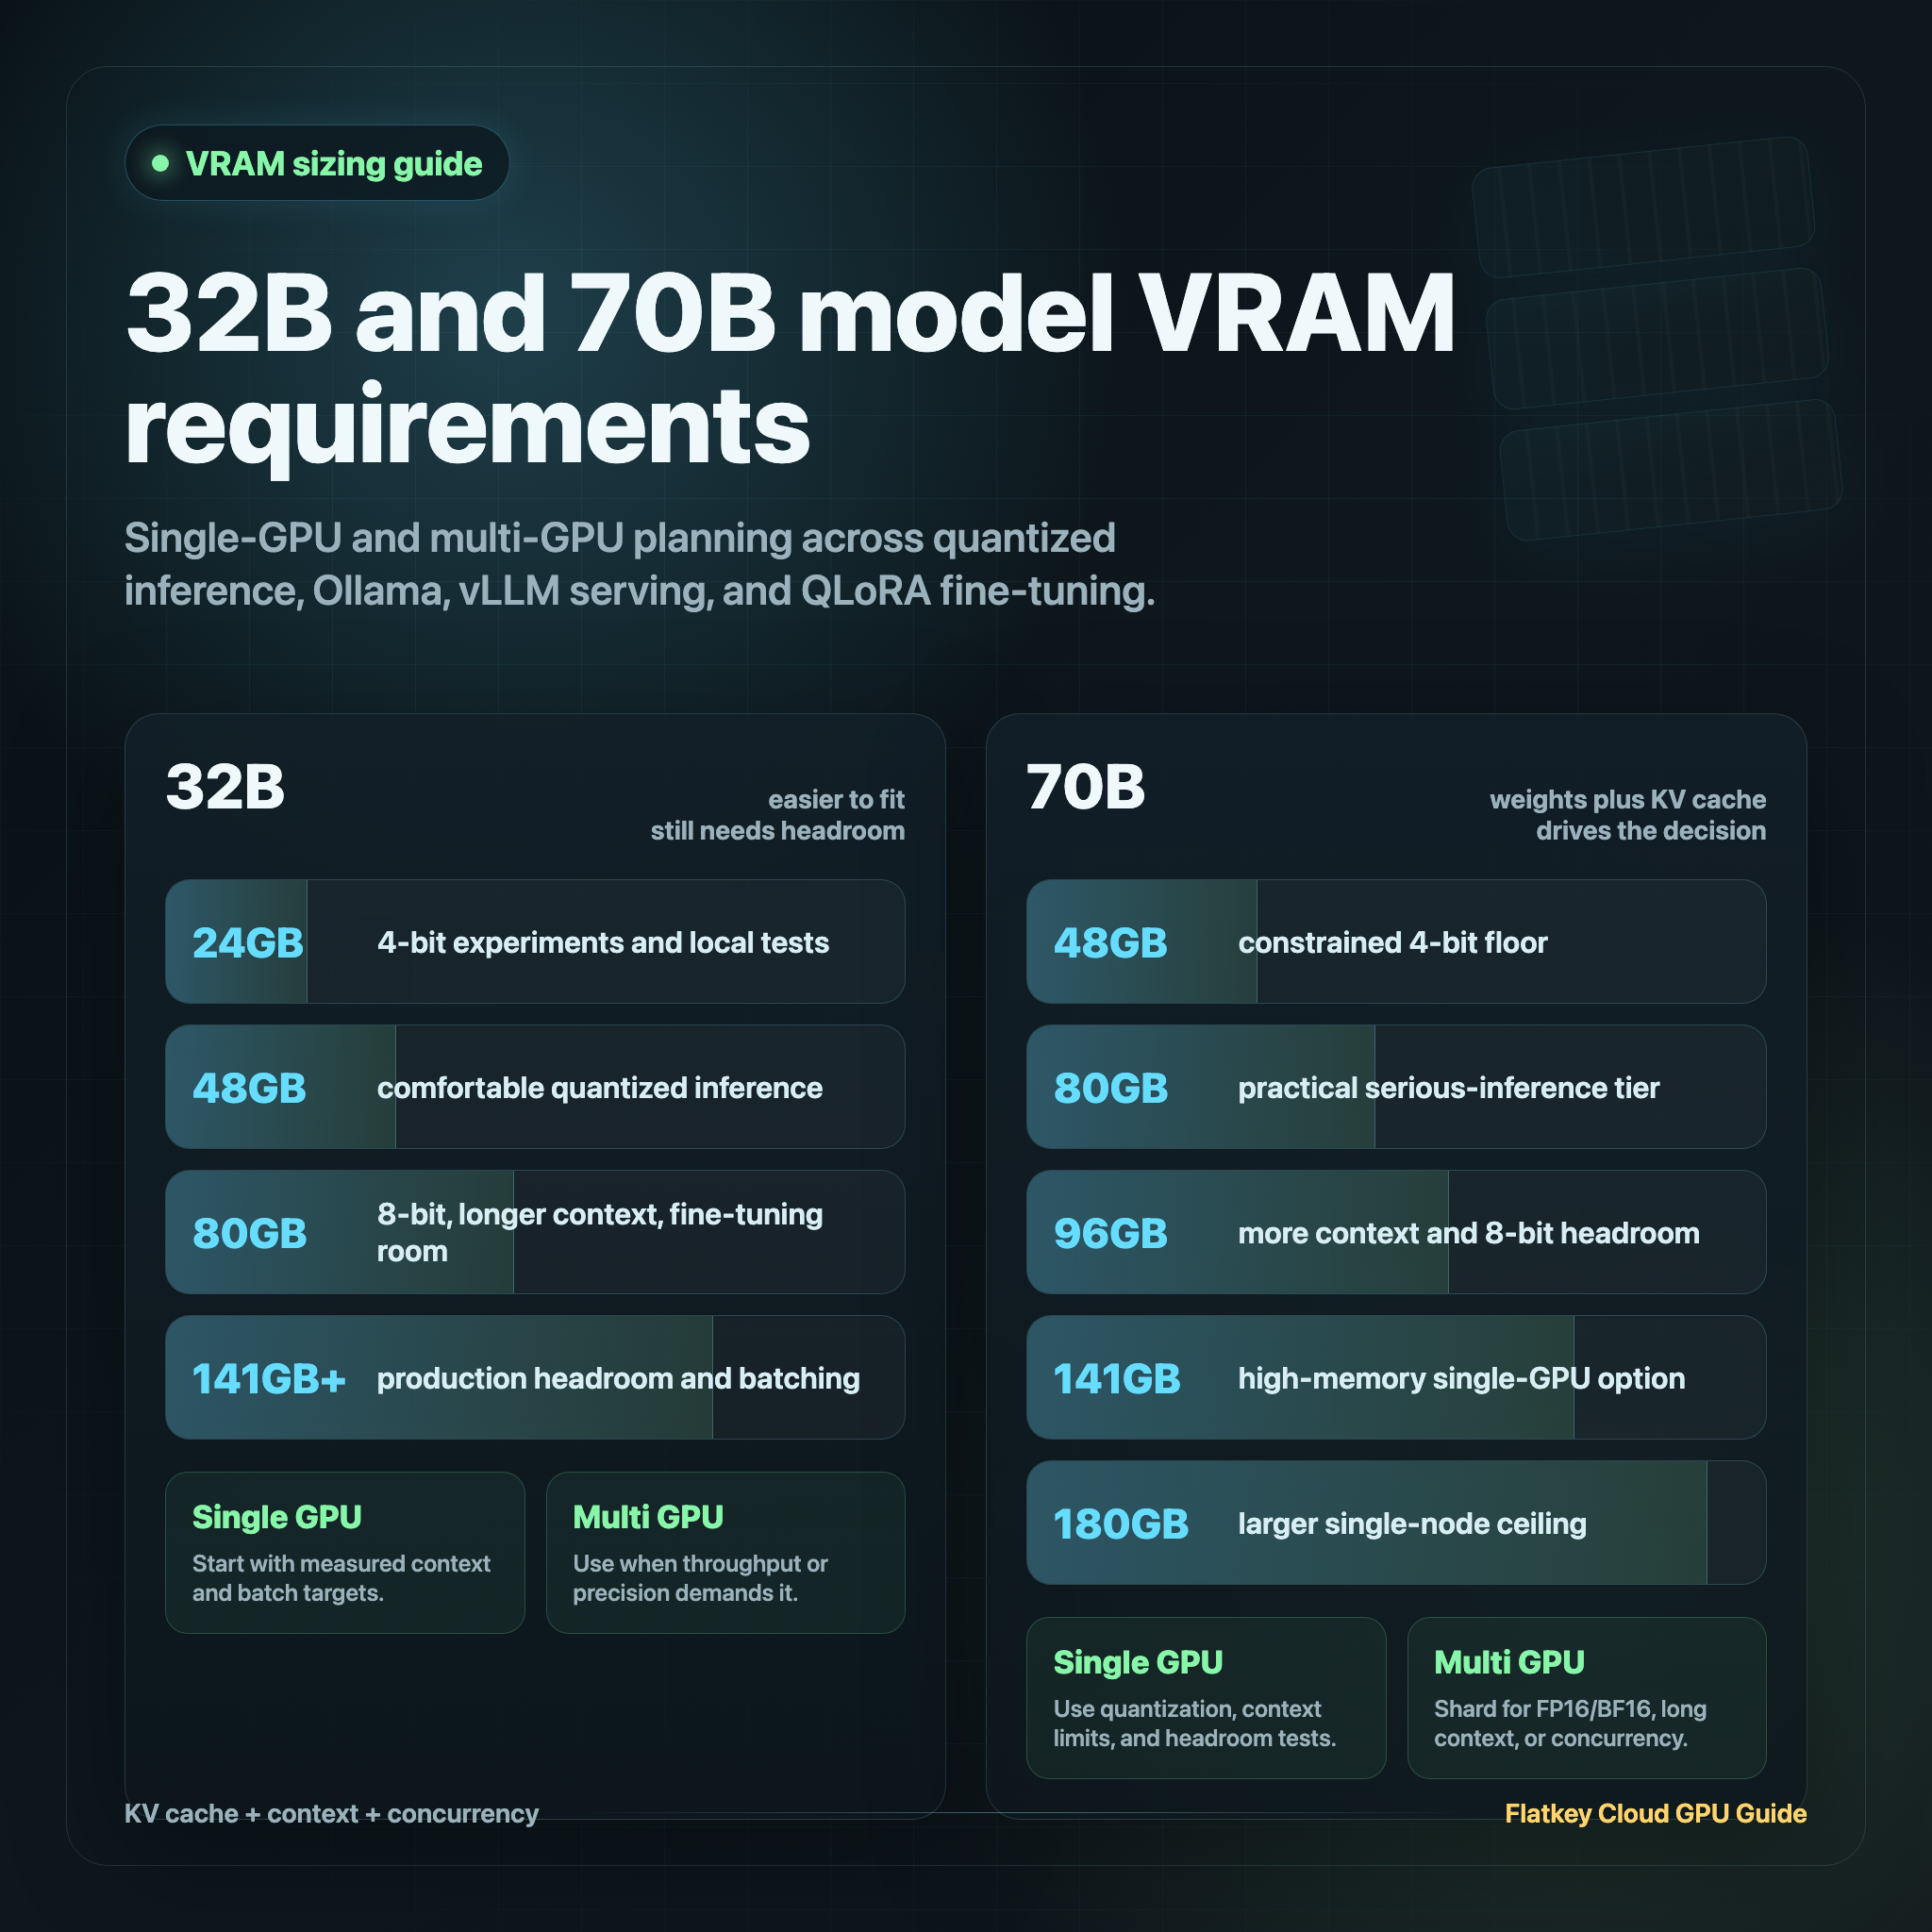
32B 和 70B 模型 VRAM 指南:单 GPU 与多 GPU 方案
了解 32B 和 70B 模型在 4-bit、8-bit、FP16/BF16 推理、Ollama、QLoRA 微调以及多 GPU 方案中的实用 VRAM 需求。
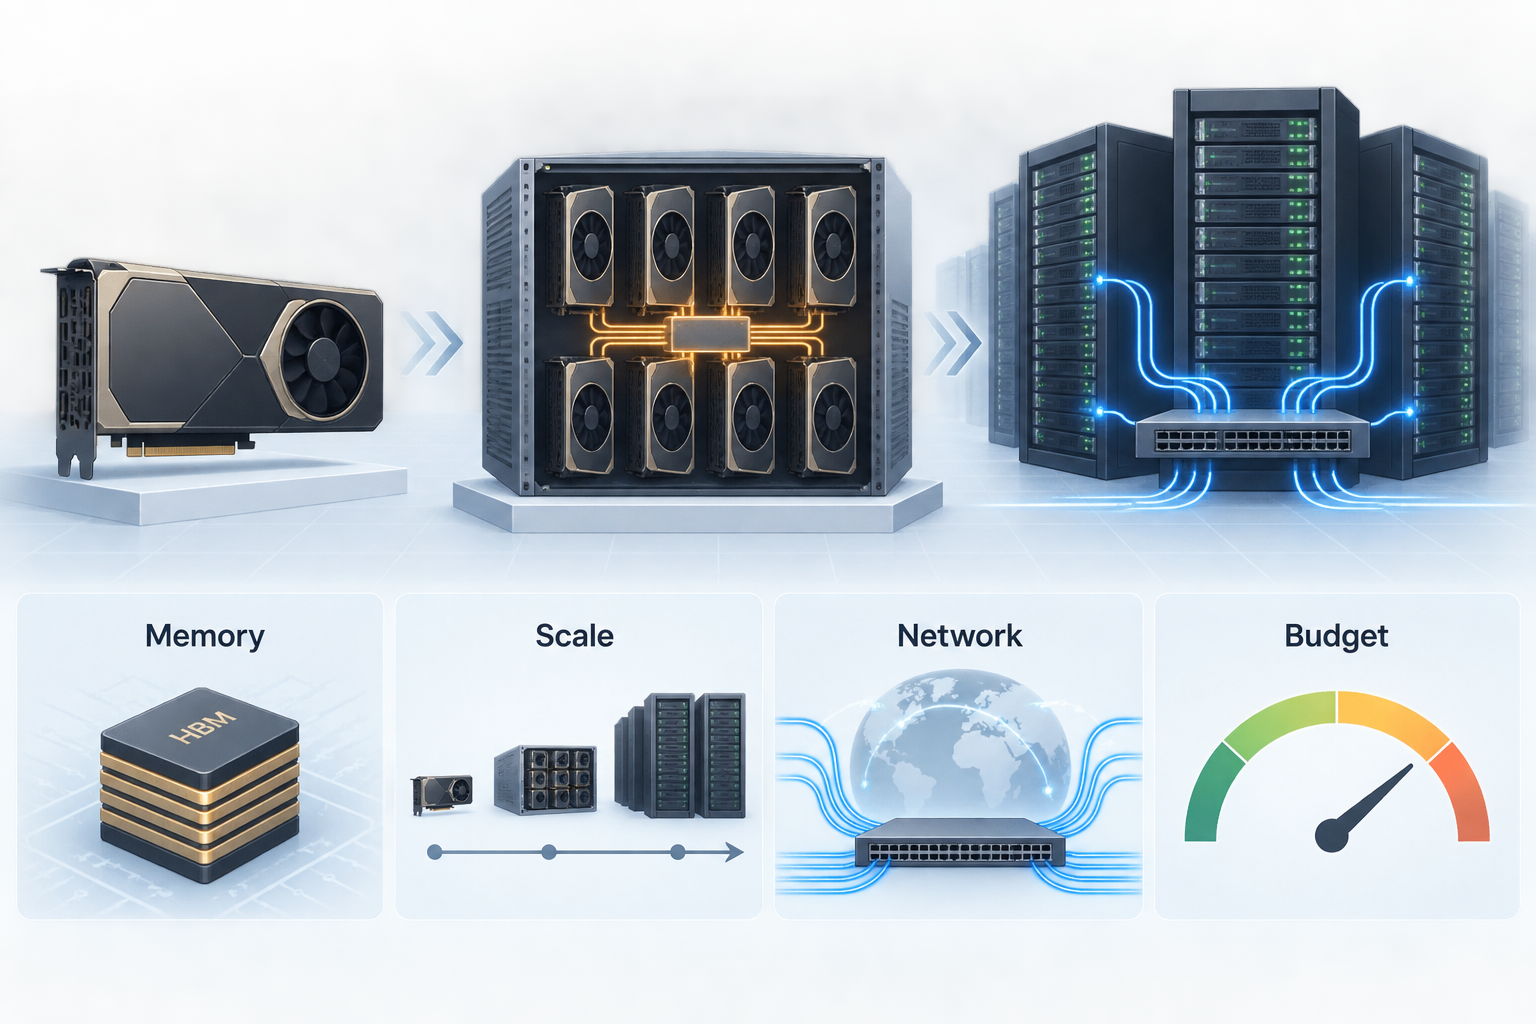
用于 LLM 训练的最佳 GPU:规模、显存、网络与预算
一份实用的 2026 选购指南,帮助你从规模、显存、网络、服务商适配性以及单个完成检查点成本等维度选择用于 LLM 训练的最佳 GPU。
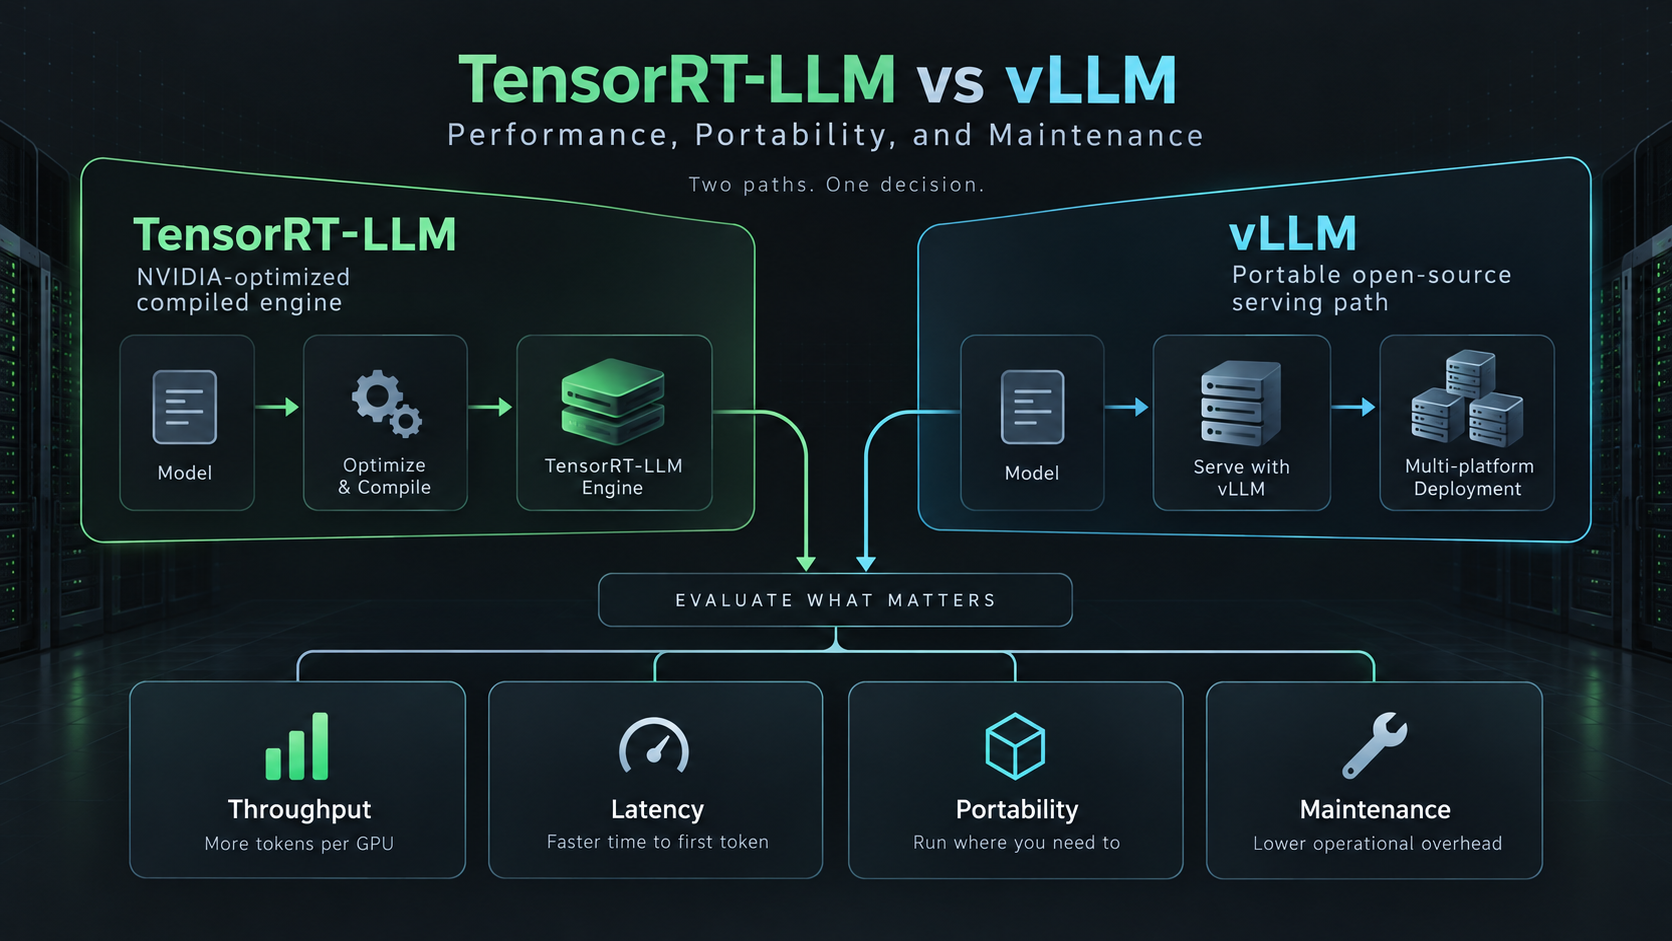
TensorRT-LLM vs vLLM:性能、可移植性与维护
面向 AI 基础设施团队的 TensorRT-LLM 与 vLLM 实用对比,帮助在 LLM 服务引擎选择中权衡性能、可移植性、维护成本和基准测试设计。
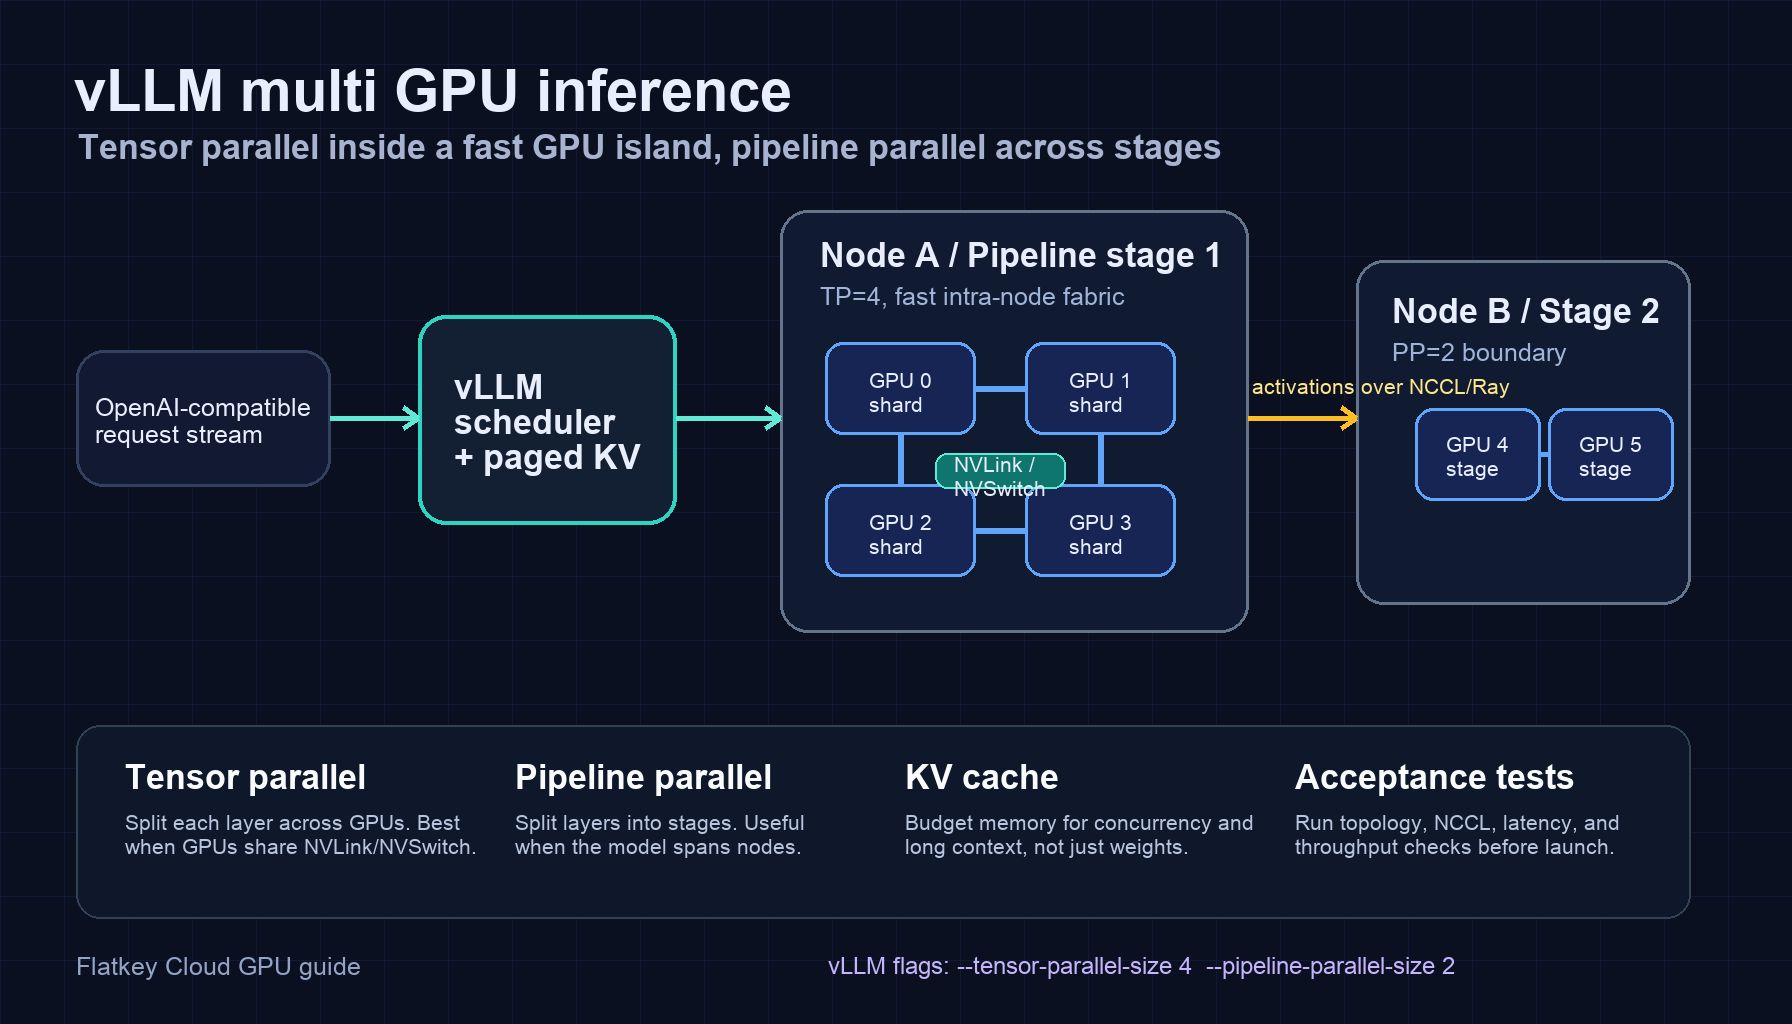
vLLM 多 GPU 推理:张量并行与流水线并行配置
使用张量并行、流水线并行、Ray、拓扑检查、示例和生产测试来配置 vLLM 多 GPU 推理。
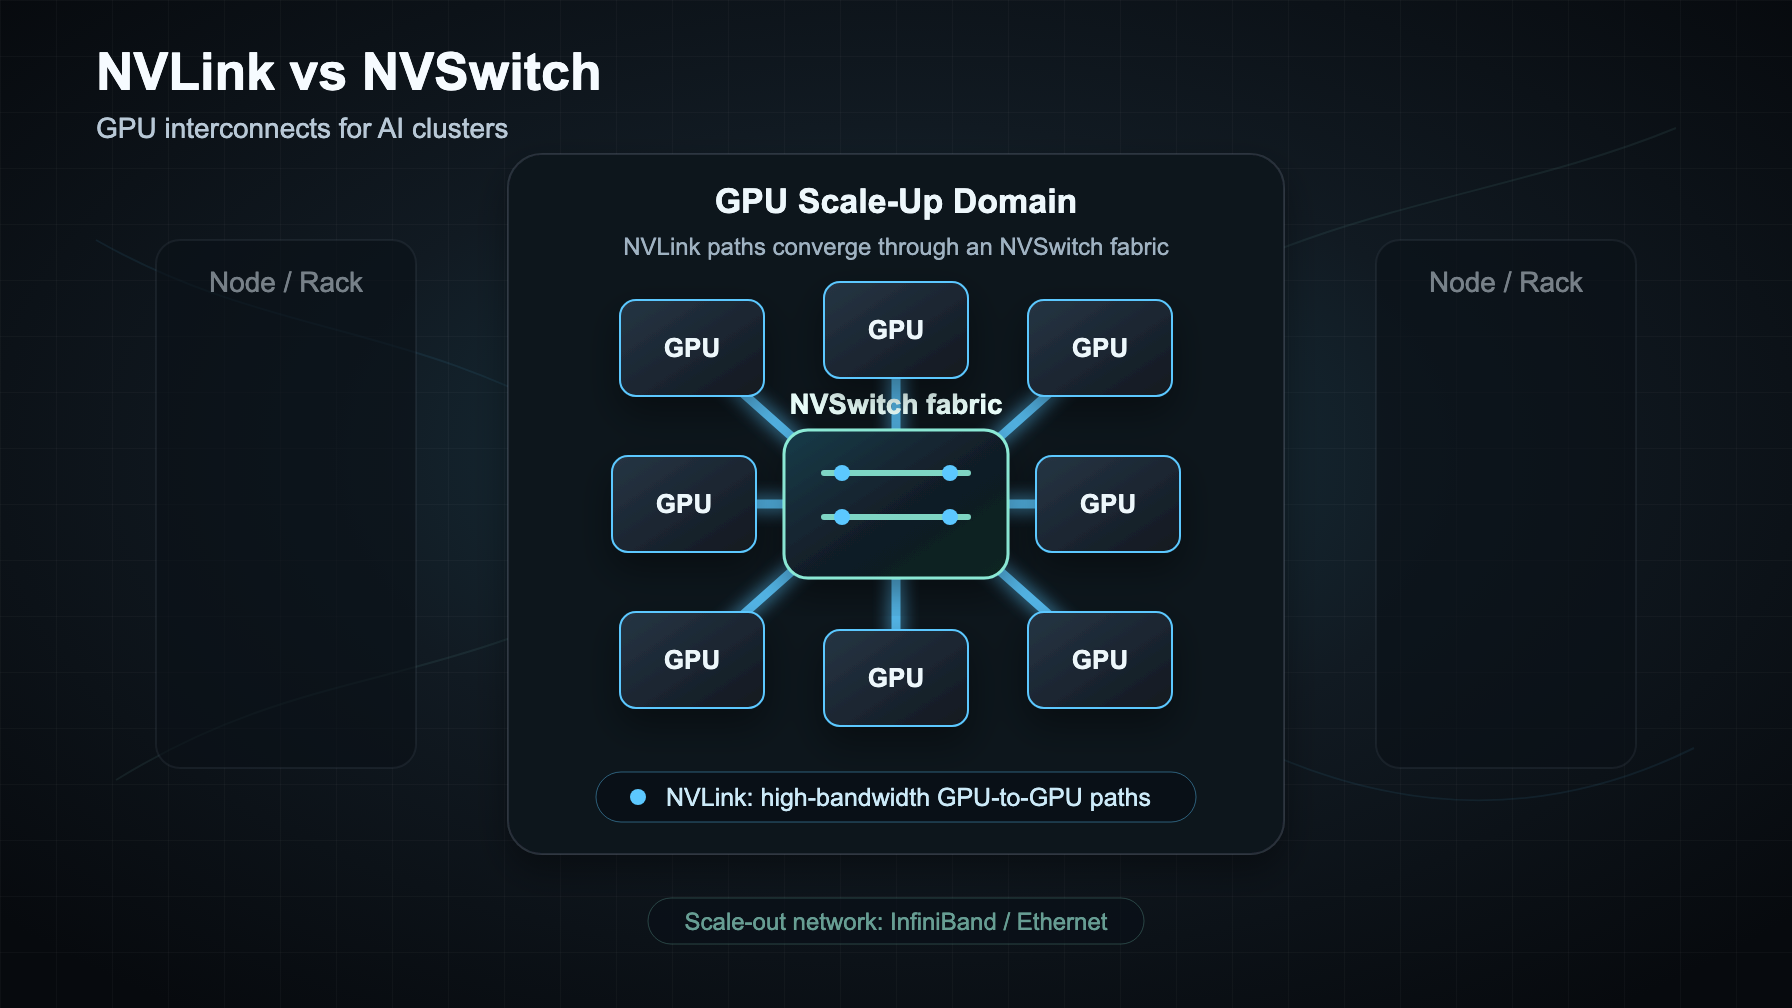
NVLink vs NVSwitch:面向 AI 集群的 GPU 互连解析
NVLink 是 GPU 之间的连接,NVSwitch 是互连交换结构,而 InfiniBand 或以太网则是横向扩展网络。以下介绍如何为 AI 集群做出选择。
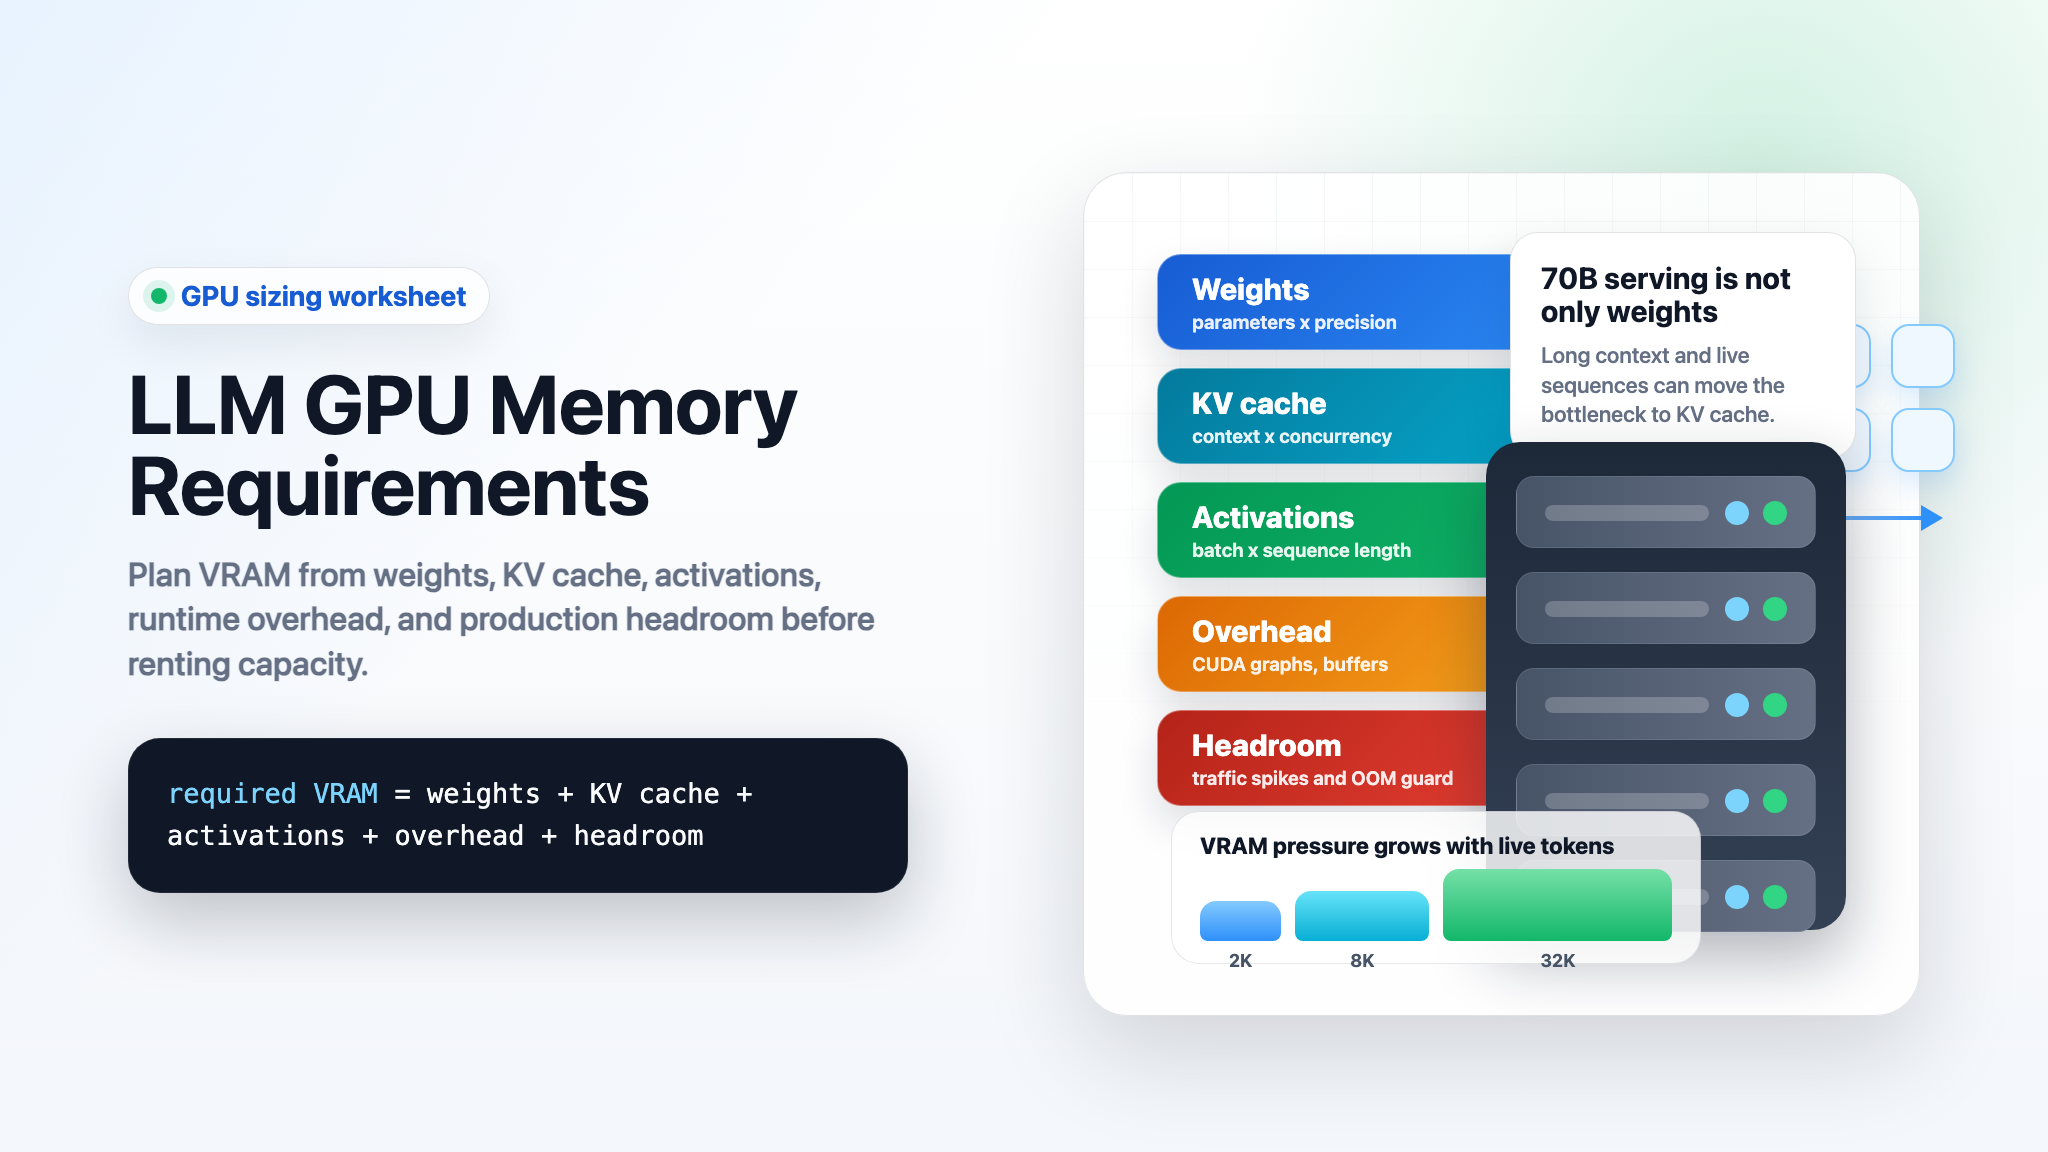
LLM GPU 内存需求:权重、KV Cache、激活值与开销
一份实用工作表,用于估算 LLM 的 GPU 内存需求,涵盖权重、KV cache、激活值、服务开销、vLLM 70B 规划、微调和训练。
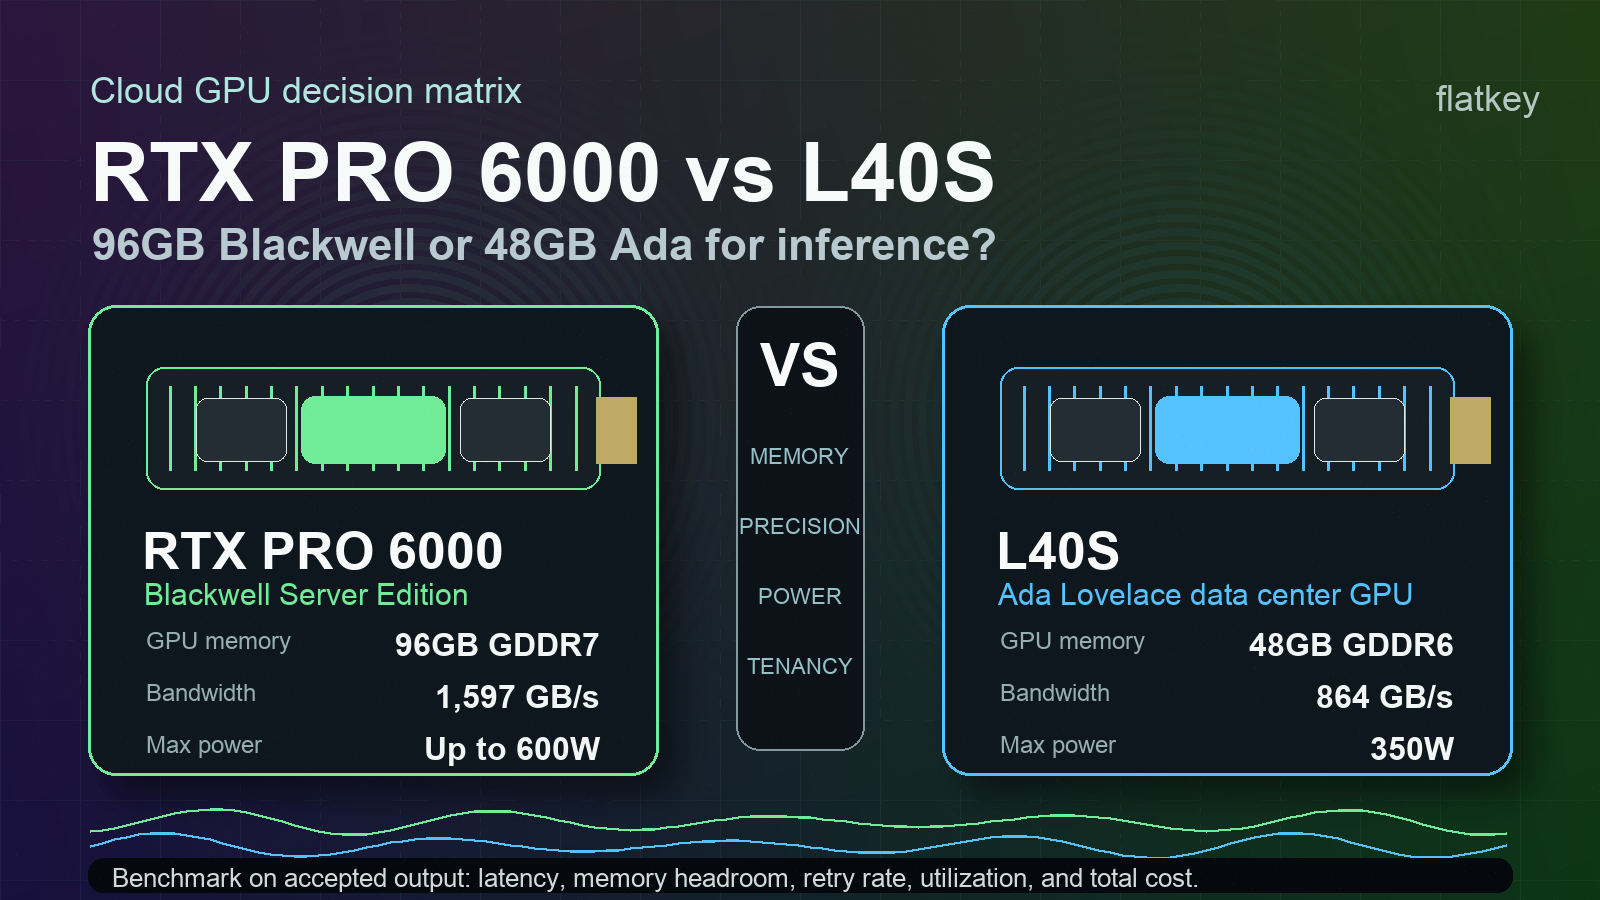
RTX PRO 6000 对比 L40S:96GB Blackwell 还是 Ada 推理 GPU?
对比 NVIDIA L40S 与 RTX PRO 6000 Blackwell Server Edition,在 LLM 推理、多模态工作负载、显存适配、功耗以及单位输出成本方面的表现。
用一个 AI 网关更快上线。
使用 flatkey.ai 在一个 API 平台中管理模型、密钥、计费和可观测性。
开始使用