
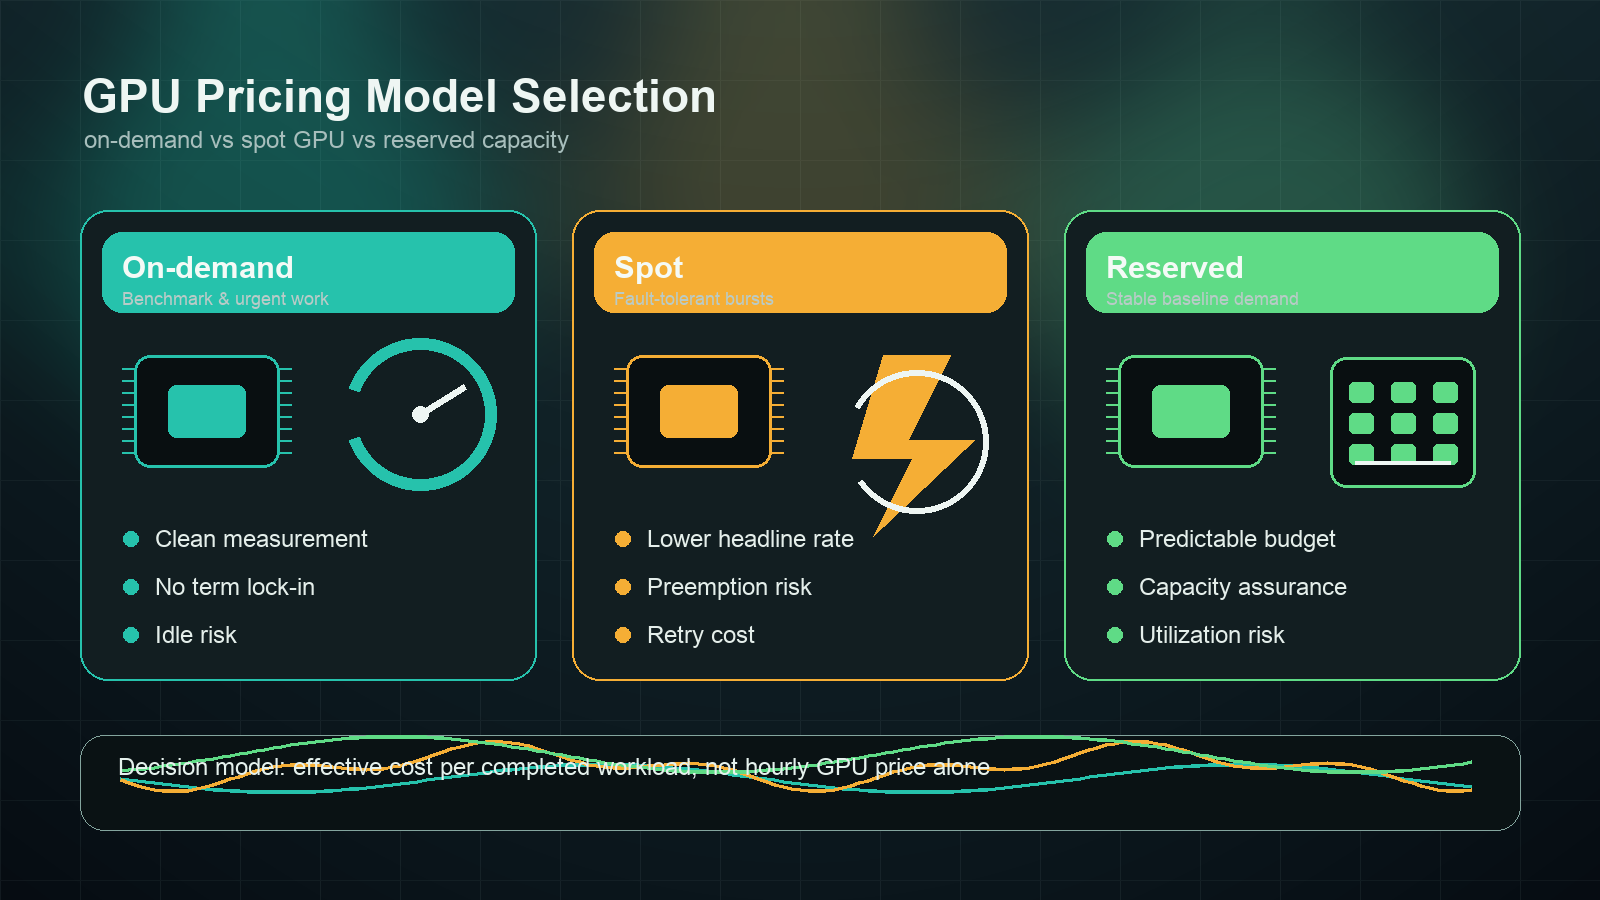
Elegir entre capacidad de GPU bajo demanda y spot no es solo un ejercicio de comparar tarifas. El precio horario más barato puede perder si los trabajos se reinician, los puntos de control son débiles, los datos tienen que recargarse o los ingenieros pasan días manteniendo vivas máquinas interrumpibles. La capacidad de GPU reservada también puede parecer más barata hasta que la demanda del modelo cambia y el equipo queda atado a hardware infrautilizado.
Esta guía compara los precios de GPU bajo demanda, spot y reservadas para compradores de infraestructura de IA, equipos de FinOps e ingenieros de plataforma que necesitan un modelo práctico de decisión por carga de trabajo. La respuesta corta: usa GPU bajo demanda para las primeras mediciones y el trabajo urgente, GPU spot para cargas batch tolerantes a fallos, y capacidad de GPU reservada solo después de poder demostrar una utilización base.
Si todavía estás decidiendo si deberías alquilar GPU en absoluto, empieza con las guías más amplias de precios de alquiler de GPU y GPU en la nube vs API de modelo. Este artículo se centra en la elección del modelo de precios después de que ya sabes que la capacidad de GPU forma parte del plan.
La respuesta rápida: GPU bajo demanda vs GPU spot vs reservada
Para la mayoría de los equipos, el primer análisis debería verse así:
| Modelo de precios | Mejor ajuste | Riesgo principal | Métrica a vigilar |
|---|---|---|---|
| GPU bajo demanda | Benchmarks, experimentos urgentes, demos, producción temprana, utilización desconocida | Tiempo inactivo y mayor tarifa horaria visible | Minutos útiles de GPU activa / minutos facturables |
| GPU spot | Inferencia batch, evaluaciones offline, entrenamiento con puntos de control, colas de medios, trabajadores reintentables | Expulsión, retraso en la cola, desperdicio por reinicio, trabajo duplicado | Trabajos completados tras el coste de interrupción |
| GPU reservada | Inferencia en producción estable, entrenamiento programado, ventanas de lanzamiento, clústeres dedicados | Infrautilización, bloqueo de hardware, desajuste contractual | Utilización base frente al punto de equilibrio del compromiso |
La regla duradera para las decisiones entre GPU bajo demanda y spot es simple: compara el coste efectivo por carga de trabajo completada, no la hora de GPU anunciada.
coste efectivo por carga de trabajo completada =
  (cómputo + almacenamiento + ancho de banda + tiempo inactivo + desperdicio por reinicio + soporte + sobrecarga de ingeniería)
  / trabajos aceptados, tokens entrenados, tokens de inferencia, imágenes, clips o ejecuciones de benchmark
Esa fórmula importa porque cada modelo traslada el riesgo a un lugar distinto. Bajo demanda pone el riesgo en el tiempo inactivo. Spot pone el riesgo en las interrupciones y la orquestación. La capacidad reservada pone el riesgo en la precisión de las previsiones.
Qué significa el precio de GPU bajo demanda
El precio de GPU bajo demanda es la referencia más limpia. Pagas mientras la instancia, el pod o el servidor está en ejecución, sin compromiso a largo plazo. AWS describe las instancias On-Demand como capacidad de pago por uso sin compromisos a largo plazo. Los proveedores especializados de nube de GPU usan un lenguaje similar para pods, instancias o servidores GPU por hora, aunque la unidad de facturación y el almacenamiento incluido varíen.
Usa bajo demanda primero cuando la carga de trabajo aún es desconocida:
| Caso de uso | Por qué encaja bajo demanda |
|---|---|
| Primer benchmark de un modelo o stack de serving | Necesitas tiempos limpios sin variables de interrupción. |
| Validación de driver, CUDA, contenedor o framework | La depuración no debería mezclarse con el riesgo de expulsión spot. |
| Demo para clientes o entorno de QA | La previsibilidad importa más que la tarifa más baja. |
| Punto final de producción temprano | Necesitas disponibilidad antes de tener datos estables de utilización. |
| Ejecución breve y urgente de entrenamiento o fine-tuning | El retraso en la cola puede costar más que el ahorro horario. |
La trampa es el tiempo inactivo. Si un notebook, pod o servidor de inferencia se ejecuta durante 100 horas facturables pero la GPU está activa solo 28 horas útiles, el coste real no es el precio horario publicado por el proveedor. La tarifa real se infla por el desperdicio inactivo.
tarifa horaria efectiva bajo demanda =
  tarifa horaria listada bajo demanda / proporción de utilización útil
Si la utilización es del 35%, una GPU de $4/hora se comporta como un recurso de $11.43/hora útil antes de almacenamiento, ancho de banda u sobrecarga de ingeniería. Para decisiones entre GPU bajo demanda y spot, corrige primero los apagados por inactividad y el empaquetado de colas antes de negociar una mejor tarifa por hora.
Qué significa el precio de GPU spot
El precio de GPU spot utiliza capacidad sobrante o interrumpible. AWS dice que las instancias EC2 Spot usan capacidad EC2 sobrante y pueden ofrecer descuentos de hasta el 90% en comparación con los precios On-Demand. Las VMs Spot de Google Cloud y las Virtual Machines Spot de Azure siguen el mismo patrón general: capacidad a menor precio que puede ser preemptada o expulsada cuando la nube la necesita de vuelta.
Las GPU spot son atractivas para cargas de trabajo de IA porque el entrenamiento, la evaluación, la generación de imágenes y la inferencia batch suelen tener grandes bloques reintentables. Pero "reintentable" no es automático. Necesitas puntos de control, trabajos idempotentes, localización de datos, monitorización y un programador que pueda reiniciarse sin corromper los resultados.
Spot suele ser un candidato fuerte cuando:
- Los trabajos de entrenamiento guardan puntos de control con frecuencia y se reanudan limpiamente.
- La inferencia batch puede reintentarse sin fallo visible para el usuario.
- Las evaluaciones offline pueden ejecutarse en muchos trabajadores.
- Los trabajos de generación de medios están detrás de una cola.
- Un trabajador que falla no invalida el trabajo multinodo completo.
- El equipo ya tiene orquestación para expulsiones y prevención de duplicados.
Spot suele ser un candidato débil cuando:
- Una sola ejecución de entrenamiento de varios días se reinicia desde un checkpoint antiguo.
- El tiempo de arranque está dominado por la descarga de modelos, imágenes o datasets.
- La latencia orientada al cliente depende de que la máquina siga activa.
- El entrenamiento multinodo falla cuando desaparece un worker.
- Los ingenieros tienen que supervisar manualmente los reinicios.
Para los pros y contras de las instancias GPU spot frente a bajo demanda, el cálculo debe incluir el desperdicio por interrupciones:
tasa horaria efectiva spot =
  tasa horaria spot / (1 - proporción de desperdicio por interrupciones)
Si spot es un 60% más barato, pero las interrupciones, las recargas de datos, los pasos fallidos y el retraso en la cola desperdician el 35% del trabajo transcurrido, el descuento real es mucho menor que la tarifa indicada. Si el desperdicio por reinicios alcanza un orden de magnitud similar al descuento, la capacidad bajo demanda suele ser más limpia.
Qué significa el precio reservado de GPU
El precio reservado de GPU es un modelo de compromiso. Puede presentarse como instancias reservadas, Savings Plans, descuentos por uso comprometido, clústeres reservados, capacidad privada, bloques de capacidad o contratos de GPU dedicadas. Los nombres difieren según el proveedor, pero la compensación es la misma: intercambias flexibilidad por capacidad predecible o una tasa efectiva más baja.
La capacidad reservada de GPU tiene sentido cuando:
| Señal | Qué significa |
|---|---|
| Tráfico base estable de inferencia | Puedes mantener las GPUs ocupadas durante la mayor parte de las horas del mes. |
| Calendario de entrenamiento repetido | Sabes cuándo se necesita capacidad y durante cuánto tiempo. |
| Requisito de capacidad para el lanzamiento | No puedes depender de la disponibilidad best-effort de spot. |
| Requisito de topología multinodo | La colocación de red, el fabric y la localidad del almacenamiento importan. |
| Compras necesita gasto fijo | Un compromiso mensual conocido es más fácil de aprobar que un uso volátil. |
La cuestión central de la capacidad reservada es el punto de equilibrio de utilización:
utilización de equilibrio reservada =
  compromiso mensual reservado
  / (tasa horaria bajo demanda * horas en el mes)
Si el compromiso reservado alcanza el punto de equilibrio con una utilización del 62% y tu base real es del 25%, la capacidad reservada no es un descuento. Es una suscripción a capacidad ociosa. Para clústeres de GPU, combina esto con el modelo de TCO de clúster de GPU para incluir red, almacenamiento, soporte, hands remotas y operaciones.
Matriz de decisión por carga de trabajo
El mejor modelo de precios depende más de la tolerancia a fallos y la utilización que del tamaño del modelo por sí solo.
| Carga de trabajo | Mejor punto de partida | Por qué |
|---|---|---|
| Primer benchmark de modelo | GPU bajo demanda | Necesitas una línea base limpia de rendimiento, latencia, memoria y modos de fallo. |
| Evaluación de una nueva pila de serving | GPU bajo demanda | Valida vLLM, SGLang, TensorRT-LLM, drivers, imágenes y carga del modelo antes de optimizar el precio. |
| Suite de evaluación offline | GPU spot | Los resultados se pueden reintentar, dividir y comprobar en busca de trabajo duplicado. |
| Embedding por lotes o inferencia por lotes | GPU spot, con fallback bajo demanda | Los trabajos pueden ponerse en cola si existen controles de idempotencia y reintento. |
| Línea base de inferencia orientada al cliente | Reservado más burst bajo demanda | La demanda estable puede justificar el compromiso; el burst sigue siendo flexible. |
| Lanzamiento puntual o campaña corta | Bajo demanda o bloque de capacidad | La garantía de capacidad puede importar más que el descuento a largo plazo. |
| Entrenamiento distribuido multinodo | Reservado o clúster dedicado | La colocación, el fabric de red y los dominios de fallo dominan el precio por hora. |
| Función de producto de IA de bajo volumen | API de modelo o gateway | La capacidad GPU ociosa puede costar más que la inferencia gestionada basada en uso. |
Para la selección del modelo de GPU dentro de cualquier fila, combina este artículo con la guía de selección de GPU para IA, la mejor GPU para inferencia LLM y la guía de despliegue de vLLM.
Economía de GPU bajo demanda vs spot: un ejemplo simple
Supongamos que un lote de inferencia puede ejecutarse en la misma clase de GPU en modo bajo demanda o spot.
| Campo | Bajo demanda | Spot |
|---|---|---|
| Tarifa horaria publicada | $4.00 |
$1.80 |
| Utilización útil | 70% |
70% |
| Desperdicio por reinicios y expulsiones | 0% |
22% |
| Coste efectivo por hora útil | $5.71 |
$3.30 |
Spot sigue ganando en este ejemplo porque el descuento es mayor que el desperdicio. Ahora cambia el desperdicio por reinicios al 55% porque el trabajo recarga repetidamente los pesos y pierde lotes parciales.
| Campo | Bajo demanda | Spot |
|---|---|---|
| Tarifa horaria publicada | $4.00 |
$1.80 |
| Utilización útil | 70% |
70% |
| Desperdicio por reinicios y expulsiones | 0% |
55% |
| Coste efectivo por hora útil | $5.71 |
$5.71 |
En ese punto, el aparente descuento spot desaparece. Por eso una comparación de GPU bajo demanda vs spot debe incluir el desperdicio operativo, no solo el porcentaje spot del proveedor.
Economía de las GPU reservadas: la prueba de utilización
La capacidad reservada necesita una prueba diferente. Supongamos que una GPU bajo demanda cuesta $4/hour, y que un compromiso mensual reservado para una capacidad equivalente cuesta $1,900/month.
monthly on-demand cost at 100% utilization =
  $4 * 730 hours = $2,920

reserved break-even utilization =
  $1,900 / $2,920 = 65%
Esa reserva solo es atractiva si la carga de trabajo puede mantener la GPU ocupada durante más de aproximadamente dos tercios del mes. Si tu endpoint de producción usa la GPU intensamente durante el horario laboral, pero permanece inactivo por la noche y los fines de semana, la base real puede estar por debajo del punto de equilibrio.
La versión para compras de la pregunta es:
- ¿Cuál es la base medida, no el pico previsto?
- ¿Qué cargas de trabajo tienen permitido llenar la capacidad reservada ociosa?
- ¿Qué ocurre si el modelo pasa de H100 a H200, B200, L40S o a una API gestionada?
- ¿El almacenamiento, soporte, red y egress están dentro o fuera del compromiso?
- ¿Puede el contrato reducirse, convertir el tipo de GPU o cambiar de región?
No reserves basándote en la esperanza. Reserva basándote en la utilización medida.
Lista de verificación de fuentes del proveedor
Las páginas de precios de GPU cambian con frecuencia, y los precios del marketplace pueden cambiar más rápido que un ciclo de compras. Usa esto como una lista de verificación de fuentes, no como una tarifa congelada. Vuelve a comprobarla el día que apruebes el gasto.
| Categoria del proveedor | Fuente oficial a consultar | Qué registrar |
|---|---|---|
| AWS | Precios de Amazon EC2, EC2 Spot Instances, EC2 Capacity Blocks for ML | Región, familia de instancia GPU, On-Demand, Spot, Savings Plans o Reserved Instances, programación de capacity block, EBS, transferencia de datos, soporte. |
| Google Cloud | Precios de GPU de Compute Engine, Spot VMs, Descuentos por uso comprometido | Tipo de GPU, familia de máquina, región, estado de Spot VM, plazo del compromiso, necesidades de reserva, disco persistente, salida de red. |
| Microsoft Azure | Azure Spot Virtual Machines, Reserved VM Instances | SKU de VM GPU, región, política de expulsión, configuración de precio máximo, plazo de reserva, disco administrado, ancho de banda, soporte. |
| RunPod | Precios de RunPod y documentación del producto | Secure Cloud frente a Community Cloud, precios de pod, precios serverless, almacenamiento persistente, volumen de red, comportamiento de cold start. |
| Vast.ai | Precios de Vast.ai y documentación de Vast.ai | Fiabilidad del host, estado de centro de datos/comunidad, marca interruptible, disco, ancho de banda, host verificado, necesidades de IP pública. |
| Lambda | Precios de Lambda Cloud GPU | Tipo de instancia, cantidad de GPU, región, disponibilidad bajo demanda, términos de cotización de clúster reservado, supuestos de almacenamiento y red. |
Añade una fila con la fecha de verificación a tu hoja de cálculo. Para este artículo, la lista de verificación de fuentes se revisó el 13 de octubre de 2026.
Preguntas de compras antes de elegir
Antes de elegir capacidad GPU bajo demanda vs spot o de firmar un contrato de GPU reservada, haz estas preguntas:
| Pregunta | Por qué importa |
|---|---|
| ¿El trabajo puede hacer checkpoint y reanudarse sin reparación manual? | Determina si el riesgo de interrupción spot es aceptable. |
| ¿Cuánto tarda en arrancar antes de que comience el trabajo útil en GPU? | Las cargas prolongadas de modelo y datos reducen los ahorros spot y perjudican la eficiencia bajo demanda. |
| ¿Cuál es la tasa de inactividad medida? | El tiempo ocioso es la principal fuga de costes bajo demanda. |
| ¿Cuál es la base, no el pico? | Los precios reservados solo funcionan cuando la demanda base es real. |
| ¿La carga de trabajo necesita una región o tejido de red específicos? | Una topología escasa puede hacer irrelevantes las tarifas genéricas spot/bajo demanda. |
| ¿Se incluyen almacenamiento, snapshots, ancho de banda y soporte? | Las horas de GPU son solo una línea en la factura real. |
| ¿Cuál es la vía de salida si cambia la elección del modelo? | El bloqueo de hardware es costoso cuando cambia la arquitectura del modelo. |
| ¿Puede una API de modelo gestionada cumplir el requisito en su lugar? | Las cargas de trabajo con poca utilización o multimodelo pueden no justificar las operaciones de GPU. |
Para decisiones de capacidad privada y de varios nodos, compáralo con alquiler de clúster GPU y nube GPU privada.
Cuando una API de modelo supera a los tres modelos de precios de GPU
Las GPU bajo demanda, spot y reservadas asumen todas que alquilar y operar hardware es la capa correcta de abstracción. Eso no siempre es cierto.
Una API de modelo gestionada puede ser el mejor punto de partida económico cuando:
- La utilización es baja, variable o desconocida.
- El producto necesita muchos modelos en lugar de un solo modelo autoalojado.
- La fiabilidad, las actualizaciones y el escalado distraerían de la hoja de ruta del producto.
- El equipo necesita registros de uso, presupuestos y facturas más que control del hardware.
- La carga de trabajo es inferencia en producción en lugar de entrenamiento de modelos o investigación de serving personalizado.
Flatkey se sitúa en ese lado de la decisión basado en API. Ofrece a los equipos de IA una clave API, un saldo, una factura, visibilidad del uso y acceso a rutas oficiales de modelos entre proveedores. Si la hoja de cálculo de GPU bajo demanda vs spot muestra que la utilización del hardware aún no es lo suficientemente alta, compara el coste de una API gestionada por resultado aceptado antes de comprar o reservar capacidad de GPU. El siguiente paso son las guías de comparación de precios de modelos de IA y precios de gateway de IA.
Recomendación final
Usa esta secuencia:
- Empieza con capacidad de GPU bajo demanda hasta que los datos de benchmark y utilización sean fiables.
- Mueve los trabajos reintentables a GPUs spot solo después de comprobar que el checkpointing, la idempotencia y la automatización de reinicio funcionan correctamente.
- Reserva capacidad de GPU solo para la demanda base medida, ventanas de lanzamiento comprometidas o clústeres sensibles a la topología.
- Mantén abierta una ruta de API de modelo cuando la utilización sea baja, la elección del modelo cambie con frecuencia o finanzas necesite una atribución de uso más clara.
La mejor decisión entre GPU bajo demanda vs spot no es la que tiene la tarifa horaria publicada más baja. Es la decisión entre GPU bajo demanda vs spot que minimiza el coste por carga de trabajo completada mientras mantiene el riesgo de fiabilidad donde tu equipo realmente puede gestionarlo.


