
Выбор между on-demand и spot GPU capacity — это не просто вопрос тарифов. Более низкая почасовая цена может оказаться проигрышной, если задания перезапускаются, контрольные точки настроены слабо, данные приходится загружать заново или инженеры тратят дни на поддержание живучести прерываемых машин. Резервируемая GPU capacity тоже может выглядеть дешевле, пока спрос на модель не сместится и команда не окажется привязана к недоиспользуемому оборудованию.
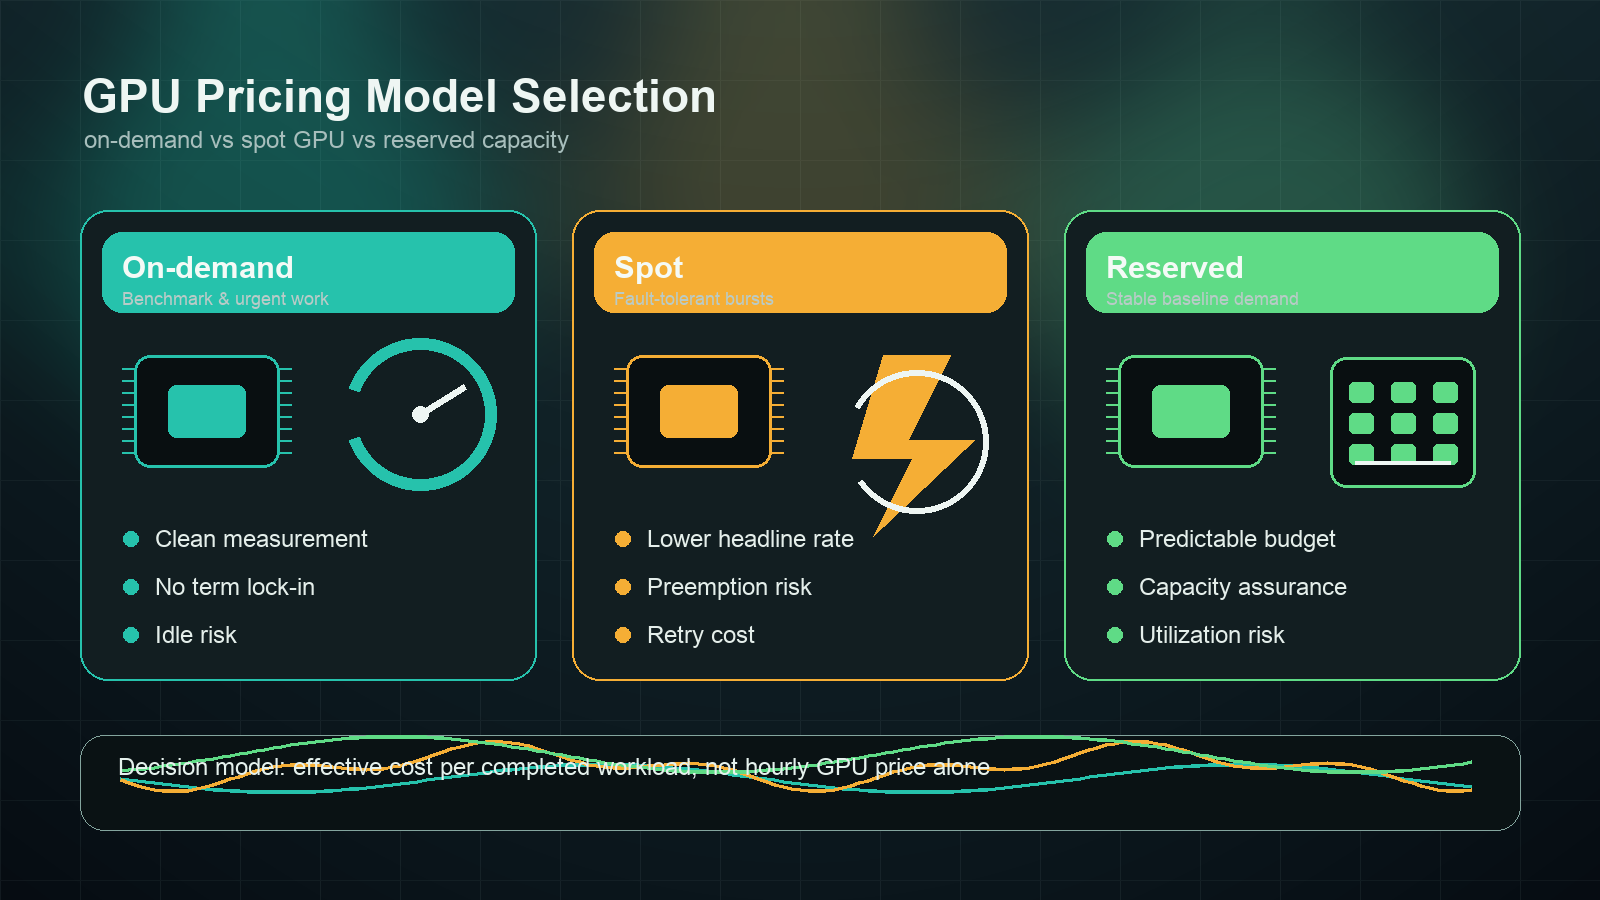
Это руководство сравнивает on-demand, spot и reserved GPU pricing для покупателей AI infrastructure, команд FinOps и platform engineers, которым нужна практическая модель выбора под рабочую нагрузку. Краткий ответ: используйте on-demand GPUs для первых измерений и срочных задач, spot GPUs — для отказоустойчивых batch workloads, а reserved GPU capacity — только после того, как вы сможете доказать базовую загрузку.
Если вы все еще решаете, стоит ли вообще арендовать GPU, начните с более общих руководств по ценам на аренду GPU и GPU cloud vs model API. Эта статья сосредоточена на выборе модели ценообразования после того, как вы уже поняли, что GPU capacity должна быть в плане.
Краткий ответ: on-demand vs spot GPU vs reserved
Для большинства команд первый проход должен выглядеть так:
| Модель ценообразования | Лучше всего подходит | Основной риск | Метрика для отслеживания |
|---|---|---|---|
| On-demand GPU | Бенчмарки, срочные эксперименты, демо, ранняя production-среда, неизвестная загрузка | Простой и более высокая заявленная почасовая ставка | Полезные активные минуты GPU / оплачиваемые минуты |
| Spot GPU | Batch inference, офлайн-оценки, обучение с контрольными точками, очереди медиа, worker'ы с возможностью повторного запуска | Вытеснение, задержка в очереди, потери на перезапуске, дублирование работы | Завершенные задания с учетом стоимости прерывания |
| Reserved GPU | Стабильный production inference, плановое обучение, окна запуска, выделенные кластеры | Недоиспользование, привязка к оборудованию, несоответствие контракту | Базовая загрузка по сравнению с порогом окупаемости обязательства |
Надежное правило для решений on-demand vs spot GPU простое: сравнивайте эффективную стоимость за завершенную рабочую нагрузку, а не рекламируемую цену за GPU-час.
эффективная стоимость за завершенную рабочую нагрузку =
  (вычисления + хранение + пропускная способность + простой + потери на перезапусках + поддержка + накладные расходы инженеров)
  / принятые задания, обученные токены, токены инференса, изображения, клипы или запуски бенчмарков
Эта формула важна, потому что каждая модель переносит риск в другое место. On-demand переносит риск в простой. Spot переносит риск в прерывания и оркестрацию. Reserved capacity переносит риск в точность прогноза.
Что означает on-demand GPU pricing
On-demand GPU pricing — это самый чистый базовый вариант. Вы платите, пока инстанс, pod или сервер работает, без долгосрочных обязательств. AWS описывает On-Demand Instances как pay-as-you-go capacity без долгосрочных обязательств. Специализированные GPU cloud используют похожую формулировку для pod'ов, инстансов или почасовых GPU-серверов, даже если единица биллинга и включенное хранилище отличаются.
Сначала используйте on-demand, когда рабочая нагрузка еще неизвестна:
| Сценарий | Почему подходит on-demand |
|---|---|
| Первый бенчмарк модели или serving stack | Вам нужны чистые измерения времени без переменных, связанных с прерываниями. |
| Проверка драйвера, CUDA, контейнера или фреймворка | Отладку не следует смешивать с риском spot-выключения. |
| Демо для клиента или QA-среда | Предсказуемость важнее самой низкой ставки. |
| Ранний production endpoint | Вам нужна доступность до того, как появятся стабильные данные о загрузке. |
| Короткий срочный запуск обучения или fine-tuning | Задержка в очереди может стоить дороже, чем экономия на часах. |
Проблема — простой. Если notebook, pod или inference server работает 100 оплачиваемых часов, а GPU активен только 28 полезных часов, реальная стоимость — это не заявленная почасовая цена провайдера. Реальная ставка завышается из-за потерь на простое.
эффективная почасовая ставка on-demand =
  заявленная почасовая ставка on-demand / доля полезной загрузки
Если загрузка составляет 35%, GPU за $4/hour ведет себя как ресурс за $11.43/useful-hour еще до учета хранения, пропускной способности или инженерных накладных расходов. Для решений on-demand vs spot GPU сначала устраните лишнее отключение простоя и уплотнение очередей, прежде чем вести переговоры о лучшей почасовой ставке.
Что означает spot GPU pricing
Spot GPU pricing использует избыточную или прерываемую capacity. AWS говорит, что EC2 Spot Instances используют свободную EC2 capacity и могут давать скидки до 90% по сравнению с On-Demand ценами. Google Cloud Spot VMs и Azure Spot Virtual Machines следуют той же общей схеме: более дешевая capacity, которую могут вытеснить или изъять, когда она снова нужна облаку.
Spot GPUs привлекательны для AI workloads, потому что обучение, оценка, генерация изображений и batch inference часто содержат большие части, которые можно повторить. Но "можно повторить" — это не автоматически. Нужны контрольные точки, идемпотентные задания, локальность данных, мониторинг и scheduler, который может перезапускаться без повреждения результатов.
Spot обычно является сильным кандидатом, когда:
- Задания обучения часто сохраняют контрольные точки и корректно возобновляются.
- Batch inference можно повторить без видимой для пользователя ошибки.
- Офлайн-оценки могут выполняться на множестве worker'ов.
- Задания по генерации медиа стоят в очереди.
- Сбой одного worker'а не делает недействительным все многонодовое задание.
- У команды уже есть оркестрация для вытеснений и предотвращения дублей.
Spot обычно является слабым кандидатом, когда:
- Один многодневный запуск обучения перезапускается со старой контрольной точки.
- Время запуска в основном уходит на загрузку моделей, образов или наборов данных.
- Задержка для клиентских запросов зависит от того, остаётся ли машина в работе.
- Многоузловое обучение срывается, когда один рабочий узел пропадает.
- Инженерам приходится вручную следить за перезапусками.
Для анализа плюсов и минусов spot- и on-demand GPU-инстансов в расчёт следует включать потери на прерывания:
spot effective hourly rate =
  spot hourly rate / (1 - interruption waste share)
Если spot на 60% дешевле, но прерывания, повторная загрузка данных, неудачные шаги и задержки в очереди съедают 35% затраченного времени, реальная скидка намного меньше заявленной ставки. Если потери на перезапуск достигают того же порядка, что и скидка, on-demand ёмкость часто оказывается проще и надёжнее.
Что означает резервируемое ценообразование GPU
Резервируемое ценообразование GPU — это модель обязательств. Она может называться reserved instances, Savings Plans, committed use discounts, reserved clusters, private capacity, capacity blocks или dedicated GPU contracts. Названия отличаются у разных поставщиков, но суть компромисса одна: вы меняете гибкость на предсказуемую ёмкость или более низкую эффективную ставку.
Резервируемая GPU-ёмкость имеет смысл, когда:
| Сигнал | Что это означает |
|---|---|
| Стабильный базовый поток инференса | Вы можете загружать GPU большую часть часов месяца. |
| Повторяющийся график обучения | Вы знаете, когда нужна ёмкость и на какой срок. |
| Требование к стартовой ёмкости | Вы не можете полагаться на best-effort доступность spot. |
| Требование многоузловой топологии | Имеют значение размещение в сети, fabric и локальность хранилища. |
| Закупкам нужен фиксированный расход | Известное ежемесячное обязательство проще согласовать, чем изменчивое потребление. |
Ключевой вопрос для резервируемой ёмкости — точка безубыточности по использованию:
reserved break-even utilization =
  reserved monthly commitment
  / (on-demand hourly rate * hours in month)
Если резервное обязательство окупается при 62% загрузки, а ваша реальная базовая нагрузка — 25%, резервируемая ёмкость — это не скидка. Это подписка на простаивающую мощность. Для GPU-кластеров объединяйте это с моделью TCO GPU-кластера, чтобы были учтены сеть, хранилище, поддержка, remote hands и эксплуатация.
Матрица принятия решений по типу нагрузки
Лучший модель ценообразования зависит от допустимости сбоев и уровня загрузки сильнее, чем от одного лишь размера модели.
| Нагрузка | Лучший стартовый вариант | Почему |
|---|---|---|
| Первый бенчмарк модели | On-demand GPU | Нужна чистая базовая линия для пропускной способности, задержки, памяти и режимов отказа. |
| Оценка нового стека сервинга | On-demand GPU | Проверьте vLLM, SGLang, TensorRT-LLM, драйверы, образы и загрузку модели до оптимизации цены. |
| Набор офлайн-оценки | Spot GPU | Результаты можно повторять, разбивать на части и проверять на дублирование работы. |
| Пакетное эмбеддингирование или пакетный инференс | Spot GPU, с резервным on-demand | Задачи можно ставить в очередь, если есть идемпотентность и механизмы повторных попыток. |
| Базовая инференс-нагрузка для клиентов | Reserved плюс on-demand для всплесков | Стабильный спрос может оправдать обязательство; всплески остаются гибкими. |
| Разовый запуск или короткая кампания | On-demand или capacity block | Гарантия доступности может быть важнее долгосрочной скидки. |
| Многоузловое распределённое обучение | Reserved или выделенный кластер | Размещение, сетевой fabric и домены отказа важнее почасовой цены. |
| AI-функция продукта с низким объёмом | Model API или gateway | Простаивающая GPU-ёмкость может стоить дороже, чем управляемый инференс с оплатой по использованию. |
Для выбора GPU-модели в любом из сценариев сочетайте эту статью с руководством по выбору AI GPU, лучшей GPU для LLM-инференса и руководством по развёртыванию vLLM.
Экономика on-demand против spot GPU: простой пример
Предположим, что пакет инференса может выполняться на одном и том же классе GPU либо в on-demand, либо в spot-режиме.
| Параметр | On-demand | Spot |
|---|---|---|
| Указанная почасовая ставка | $4.00 |
$1.80 |
| Полезная загрузка | 70% |
70% |
| Потери на перезапуски и выселение | 0% |
22% |
| Эффективная стоимость полезного часа | $5.71 |
$3.30 |
Spot всё ещё выигрывает в этом примере, потому что скидка больше потерь. Теперь изменим потери на перезапуск до 55%, потому что задача снова и снова загружает веса и теряет частичные батчи.
| Параметр | On-demand | Spot |
|---|---|---|
| Указанная почасовая ставка | $4.00 |
$1.80 |
| Полезная загрузка | 70% |
70% |
| Потери на перезапуски и выселение | 0% |
55% |
| Эффективная стоимость полезного часа | $5.71 |
$5.71 |
К этому моменту кажущаяся скидка спота исчезает. Именно поэтому сравнение GPU по запросу и спот должно включать операционные потери, а не только процент спотовой скидки у провайдера.
Экономика зарезервированных GPU: тест на загрузку
Зарезервированная мощность требует другого теста. Допустим, GPU по запросу стоит $4/hour, а ежемесячное резервирование эквивалентной мощности — $1,900/month.
monthly on-demand cost at 100% utilization =
  $4 * 730 hours = $2,920

reserved break-even utilization =
  $1,900 / $2,920 = 65%
Такое резервирование выгодно только если нагрузка может загружать GPU более чем примерно на две трети месяца. Если ваш production endpoint активно использует GPU в рабочие часы, но простаивает ночью и по выходным, реальная базовая загрузка может оказаться ниже точки безубыточности.
В терминах закупок этот вопрос звучит так:
- Какова измеренная базовая загрузка, а не прогнозируемый пик?
- Какие нагрузки могут заполнять простаивающую зарезервированную мощность?
- Что произойдет, если модель перейдет с H100 на H200, B200, L40S или managed API?
- Включены ли хранилище, поддержка, сеть и исходящий трафик в обязательство или нет?
- Можно ли по контракту уменьшить объем, сменить тип GPU или регион?
Не резервируйте в расчете на надежду. Резервируйте на основе измеренной загрузки.
Чек-лист источников провайдера
Страницы с ценами на GPU часто меняются, а цены на маркетплейсах могут меняться быстрее, чем цикл закупок. Используйте это как чек-лист источников, а не как фиксированный прайс-лист. Проверьте его еще раз в день согласования расходов.
| Категория провайдера | Официальный источник для проверки | Что зафиксировать |
|---|---|---|
| AWS | Amazon EC2 pricing, EC2 Spot Instances, EC2 Capacity Blocks for ML | Регион, семейство GPU-инстансов, On-Demand, Spot, Savings Plans или Reserved Instances, сроки capacity block, EBS, передача данных, support. |
| Google Cloud | Compute Engine GPU pricing, Spot VMs, Committed use discounts | Тип GPU, семейство машин, регион, статус Spot VM, срок обязательства, потребность в reservation, persistent disk, сетевой egress. |
| Microsoft Azure | Azure Spot Virtual Machines, Reserved VM Instances | SKU GPU VM, регион, политика eviction, настройка max price, срок reservation, managed disk, bandwidth, support. |
| RunPod | RunPod pricing и product docs | Secure Cloud vs Community Cloud, тарифы pod, тарифы serverless, persistent storage, network volume, поведение cold start. |
| Vast.ai | Vast.ai pricing и Vast.ai docs | Надежность хоста, статус datacenter/community, флаг interruptible, диск, bandwidth, verified host, необходимость public IP. |
| Lambda | Lambda Cloud GPU pricing | Тип инстанса, количество GPU, регион, доступность on-demand, условия котировки reserved cluster, допущения по storage и networking. |
Добавьте в таблицу строку с датой проверки. Для этой статьи чек-лист источников был проверен 13 октября 2026 года.
Вопросы для закупок перед выбором
Прежде чем выбирать GPU capacity по запросу или спот, либо подписывать контракт на зарезервированную GPU, задайте эти вопросы:
| Вопрос | Почему это важно |
|---|---|
| Может ли задача сохранять состояние и возобновляться без ручного восстановления? | Определяет, приемлем ли риск прерывания спота. |
| Сколько времени проходит до начала полезной работы GPU? | Долгая загрузка модели и данных снижает экономию на споте и ухудшает эффективность on-demand. |
| Каков измеренный процент простоя? | Простой — главный источник потерь по on-demand. |
| Какова базовая нагрузка, а не пик? | Резервное ценообразование работает только тогда, когда базовый спрос реален. |
| Нужен ли нагрузке конкретный регион или сетевой fabric? | Дефицитная топология может сделать общие ставки spot/on-demand несущественными. |
| Включены ли хранилище, snapshots, bandwidth и support? | Часы работы GPU — это только одна строка в реальном счете. |
| Каков путь выхода, если выбор модели изменится? | Привязка к оборудованию дорога, когда меняется архитектура модели. |
| Может ли вместо этого подойти managed model API? | Низкозагруженные или многомодельные нагрузки могут не оправдывать эксплуатацию GPU. |
Для решений по multi-node и private capacity сравните это с арендой GPU-кластера и частным GPU cloud.
Когда API модели превосходит все три модели ценообразования GPU
On-demand, spot и reserved GPU предполагают, что аренда и эксплуатация оборудования — правильный уровень абстракции. Но это не всегда так.
Управляемый API модели может быть лучшей экономической отправной точкой, когда:
- Утилизация низкая, скачкообразная или неизвестная.
- Продукту нужно много моделей, а не одна самохостед-модель.
- Надёжность, обновления и масштабирование будут отвлекать от дорожной карты продукта.
- Команде нужны журналы использования, бюджеты и счета, а не контроль над железом.
- Нагрузка — это production inference, а не обучение модели или исследование custom serving.
Flatkey находится на этой API-стороне решения. Он даёт AI-командам один API-ключ, один баланс, один счёт, видимость использования и доступ к официальным маршрутам моделей у разных провайдеров. Если таблица для выбора между on-demand и spot GPU показывает, что утилизация железа пока недостаточно высока, сравните стоимость managed API на один принятый результат, прежде чем покупать или резервировать GPU-мощность. Следующий шаг — руководства сравнение цен на AI-модели и ценообразование AI-шлюза.
Итоговая рекомендация
Используйте такую последовательность:
- Начните с on-demand GPU-мощности, пока бенчмарк и показатели утилизации не станут надёжными.
- Переводите задачи, допускающие повтор, на spot GPU только после того, как будут подтверждены checkpointing, идемпотентность и автоматизация перезапуска.
- Резервируйте GPU-мощность только для измеренного базового спроса, согласованных окон запуска или кластеров, чувствительных к топологии.
- Оставляйте путь через API модели открытым, когда утилизация низкая, выбор модели часто меняется или финансам нужна более чистая атрибуция использования.
Лучшее решение между on-demand и spot GPU — не то, у которого самая низкая указанная почасовая ставка. Это такое решение между on-demand и spot GPU, которое минимизирует стоимость одного завершённого рабочего процесса, сохраняя риск для надёжности там, где ваша команда действительно может им управлять.


