
Blog da flatkey.ai
Insights, notas de produto e guias de implementação para equipes que criam com APIs de IA.
Arquitetura de gateways de IA
Artigos mais recentes em Arquitetura de gateways de IA.
Ler maisMigração de URL base e SDK
Artigos mais recentes em Migração de URL base e SDK.
Ler maisCustos, cobrança e operações
Artigos mais recentes em Custos, cobrança e operações.
Ler maisControles empresariais e confiança
Artigos mais recentes em Controles empresariais e confiança.
Ler maisComparações de gateways
Artigos mais recentes em Comparações de gateways.
Ler maisGuias de modelos e modalidades
Artigos mais recentes em Guias de modelos e modalidades.
Ler maisConfiabilidade e roteamento
Artigos mais recentes em Confiabilidade e roteamento.
Ler maisIntegrações de ferramentas
Artigos mais recentes em Integrações de ferramentas.
Ler mais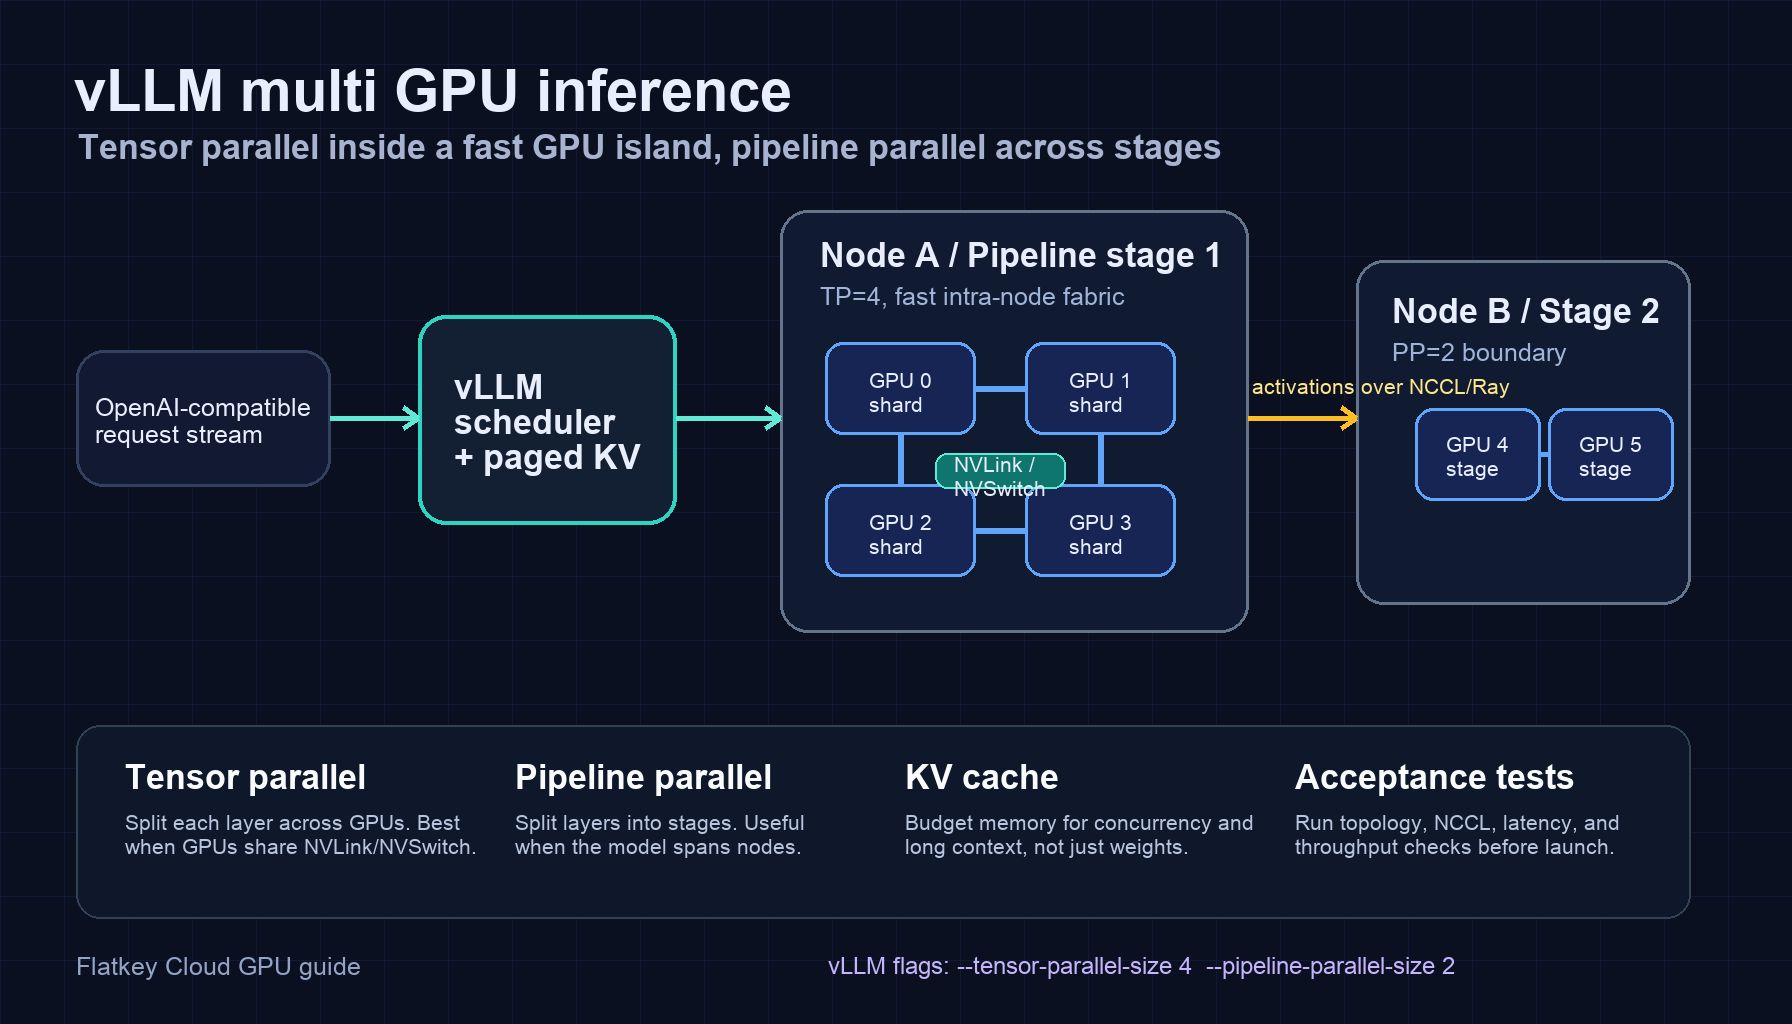
Inferência Multi-GPU com vLLM: Configuração de Paralelismo Tensorial e de Pipeline
Configure a inferência multi-GPU com vLLM usando paralelismo tensorial, paralelismo de pipeline, Ray, verificações de topologia, exemplos e testes em produção.
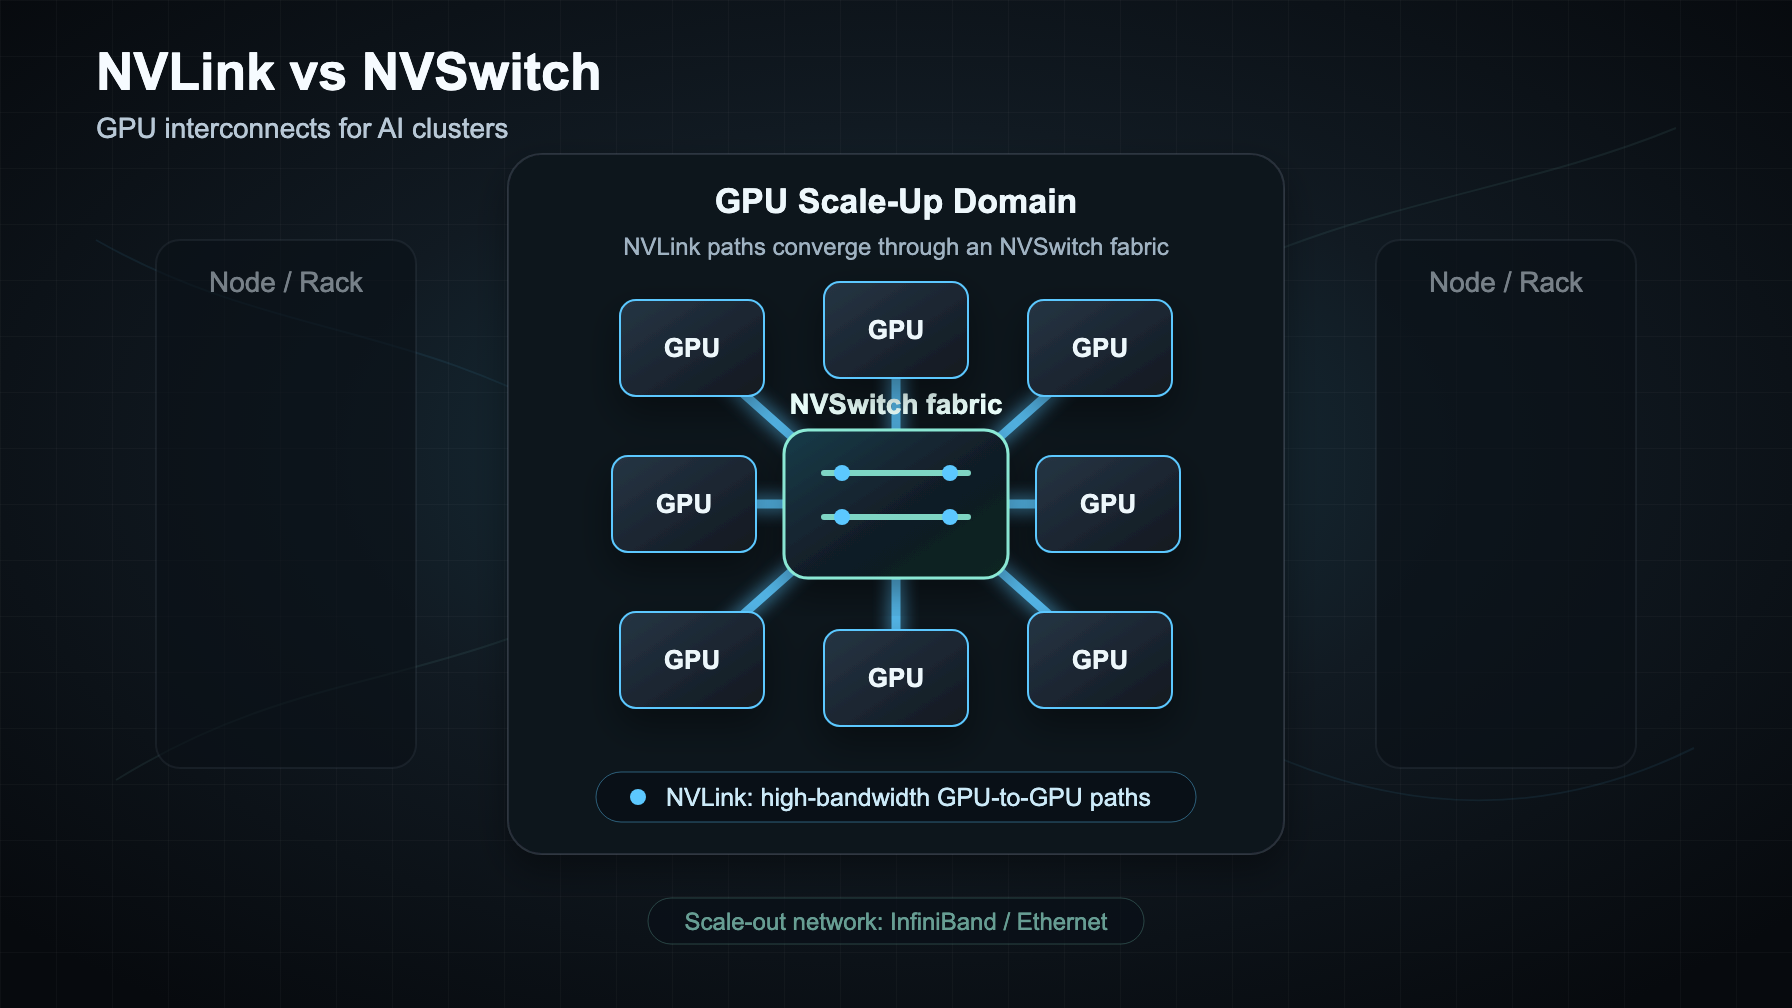
NVLink vs NVSwitch: Explicação das interconexões de GPU para clusters de IA
NVLink é a ligação GPU a GPU, NVSwitch é a malha, e InfiniBand ou Ethernet é a rede de escala horizontal. Veja como escolher para clusters de IA.
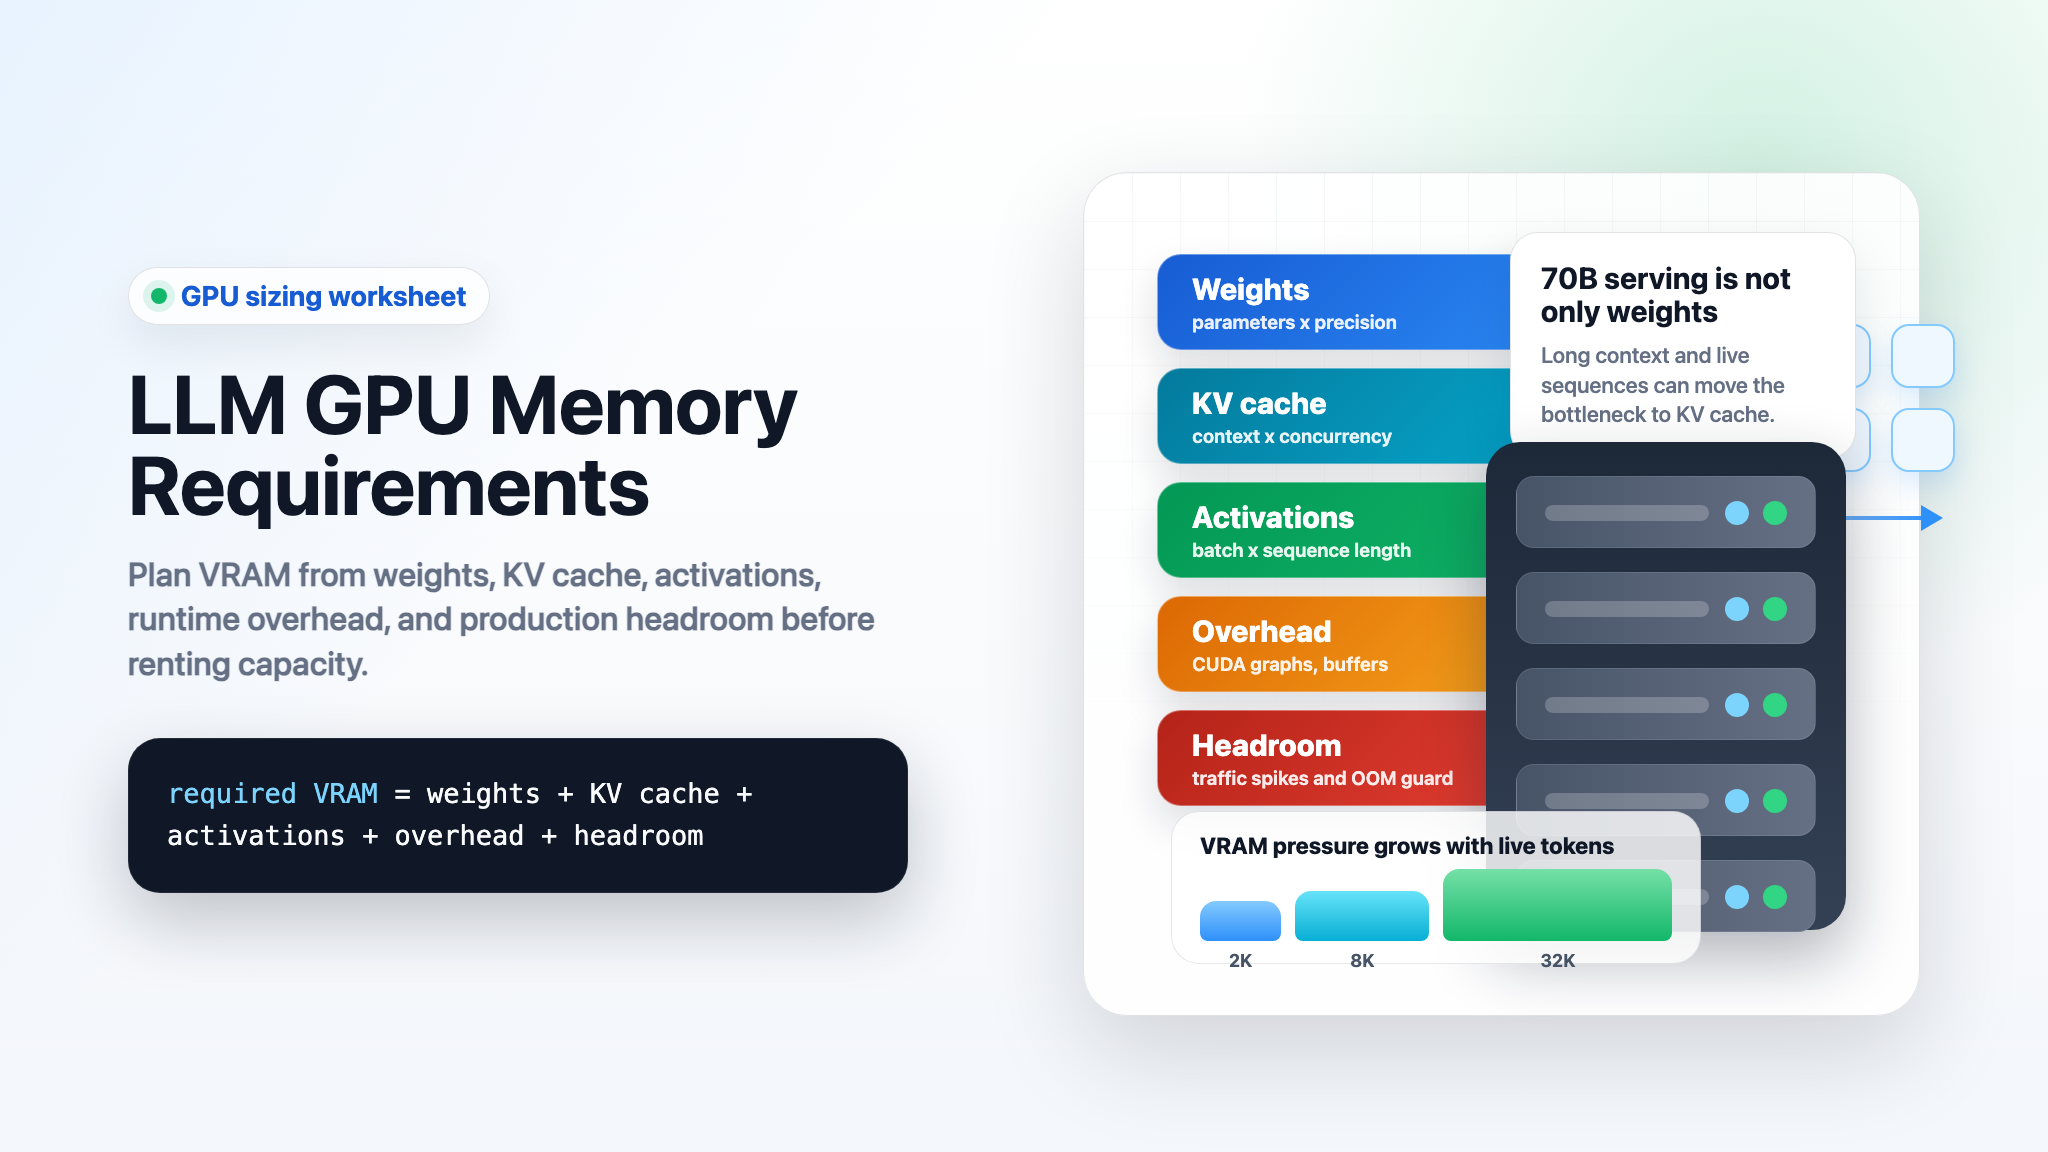
Requisitos de Memória GPU para LLM: Pesos, KV Cache, Ativações e Overhead
Uma planilha prática para estimar os requisitos de memória GPU de LLMs em pesos, KV cache, ativações, overhead de serving, planejamento de vLLM 70B, fine-tuning e treinamento.
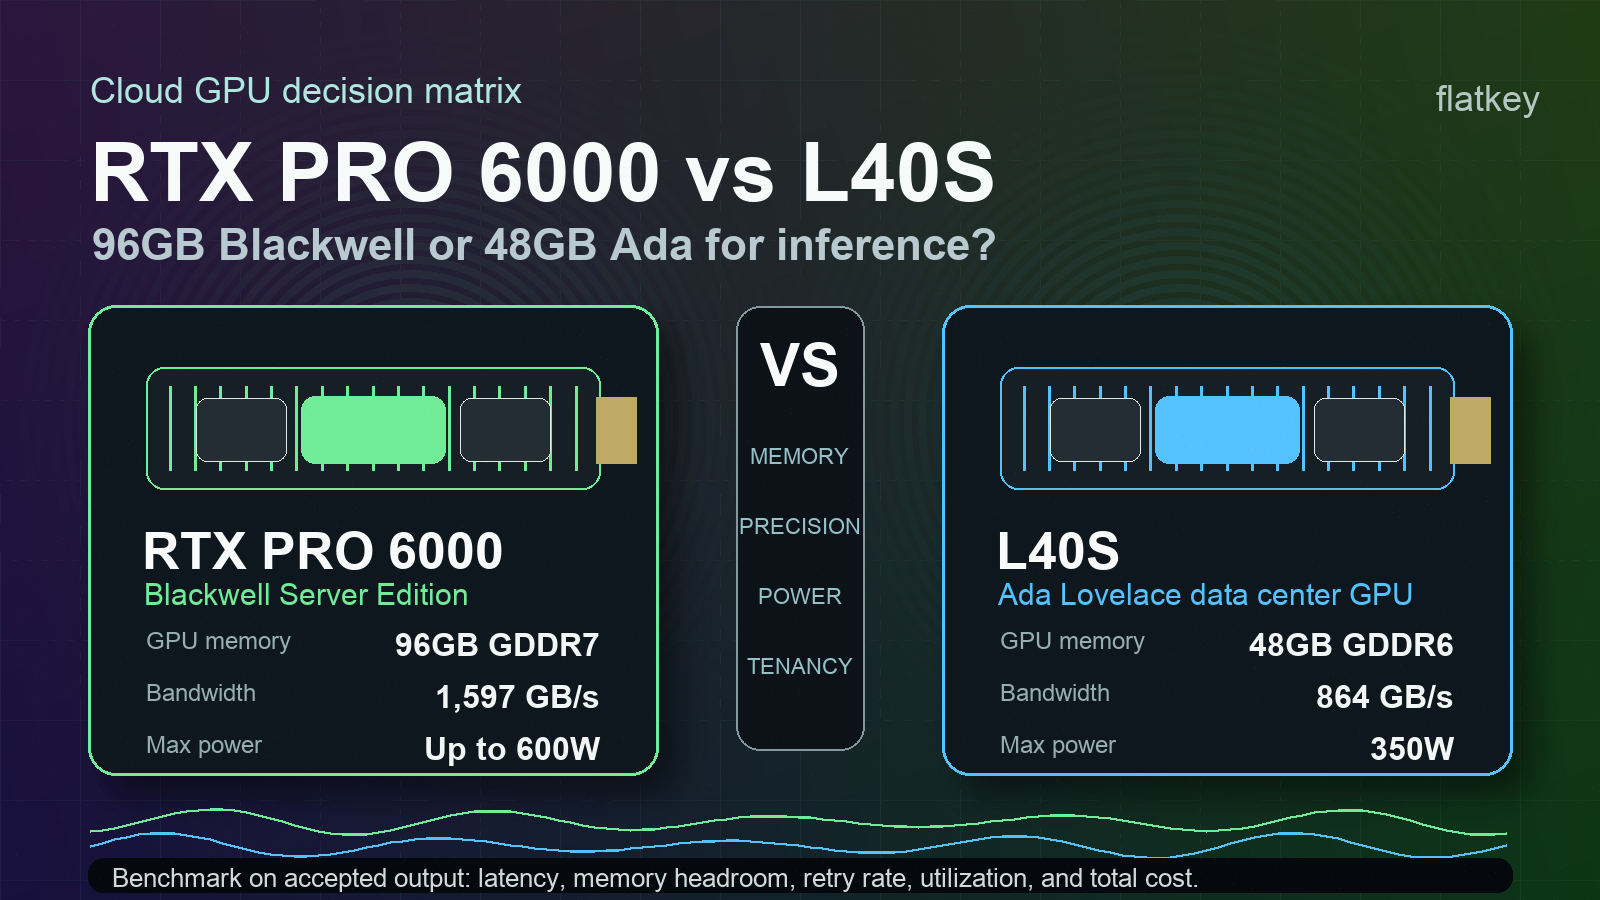
RTX PRO 6000 vs L40S: GPU de inferência Blackwell de 96 GB ou Ada?
Compare o NVIDIA L40S com o RTX PRO 6000 Blackwell Server Edition para inferência de LLM, workloads multimodais, adequação de memória, consumo de energia e custo por saída aceita.
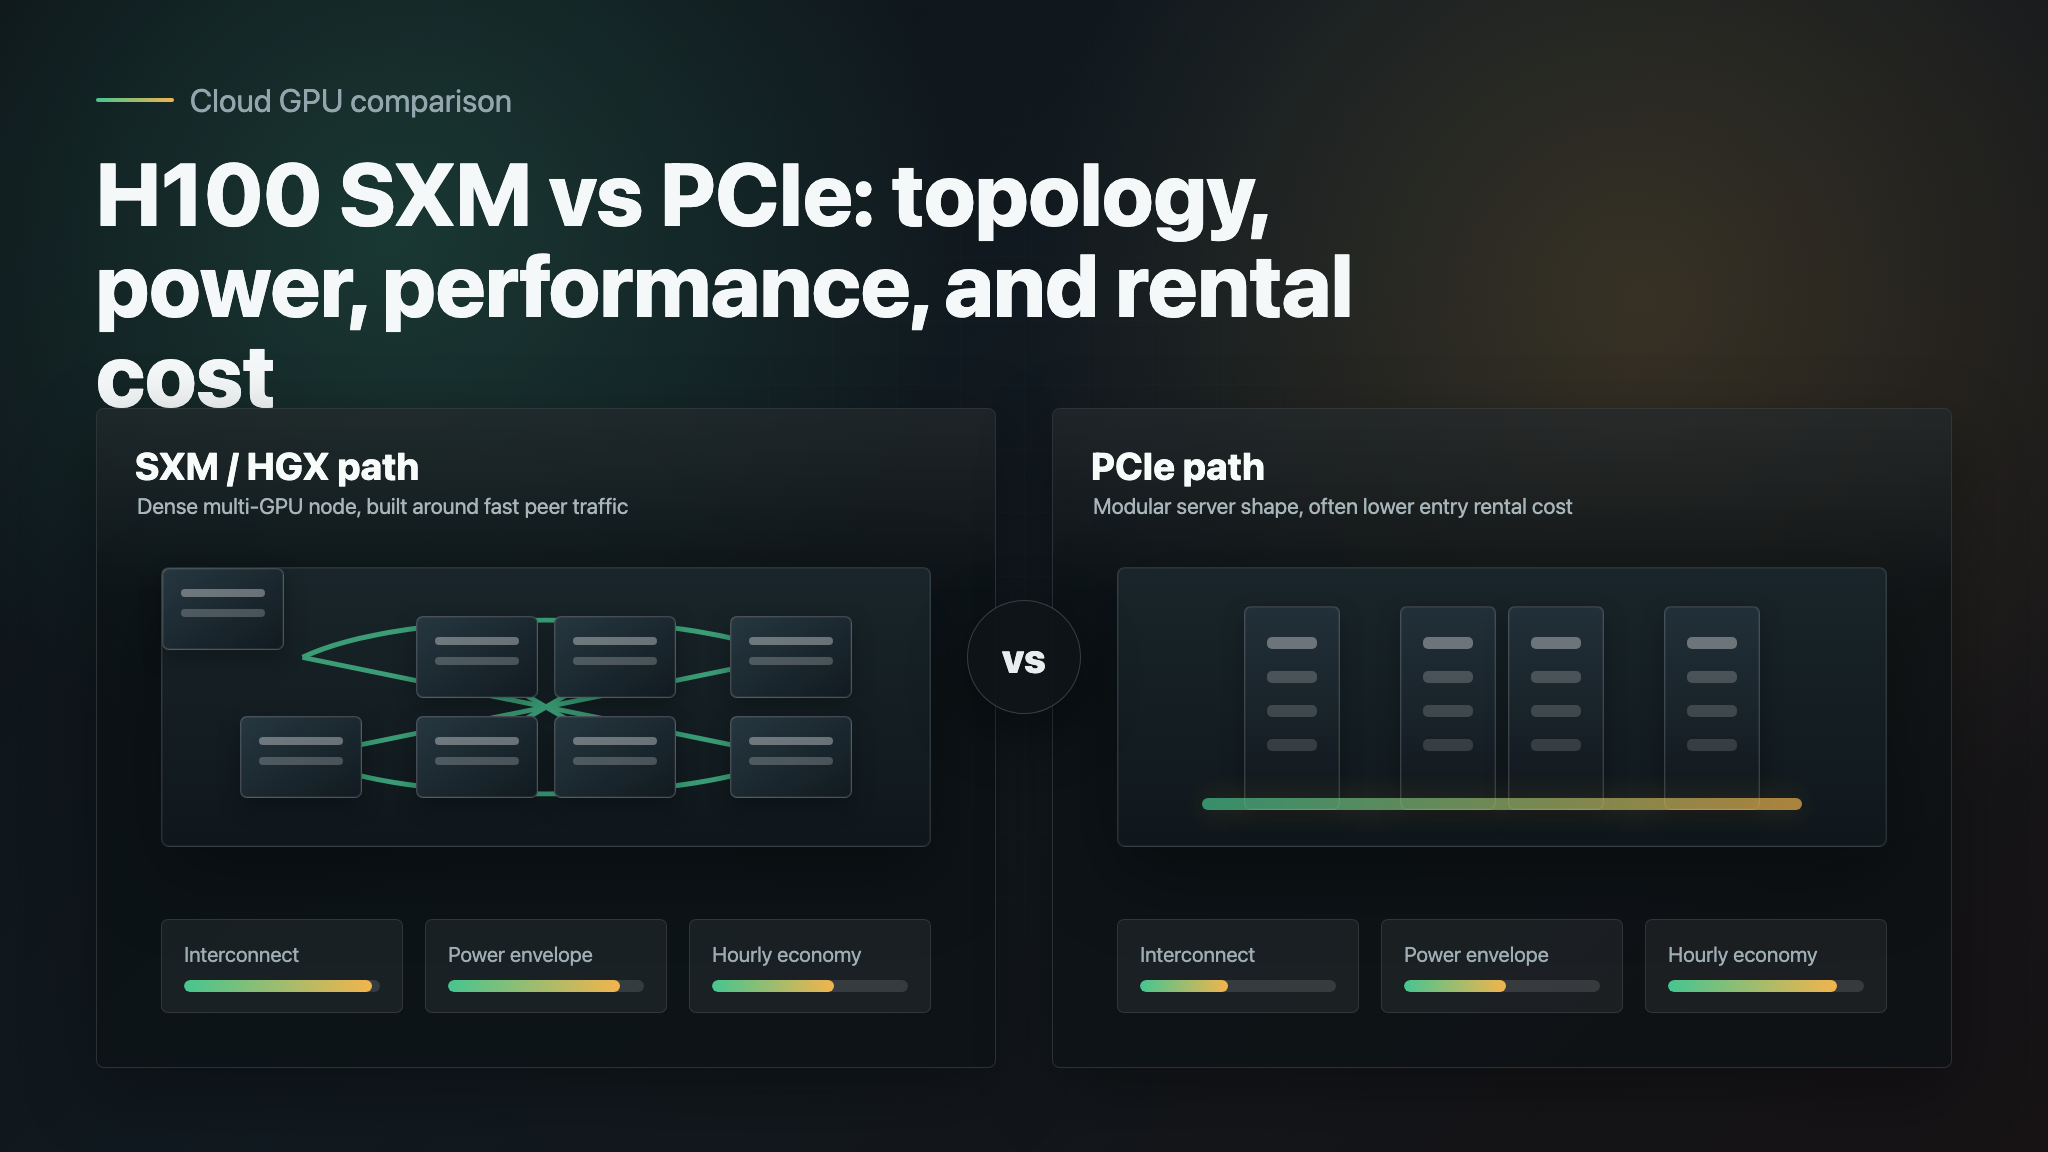
H100 SXM vs PCIe: NVLink, Energia, Desempenho e Custo de Aluguel
Compare o H100 PCIe vs SXM em NVLink, consumo de energia, desempenho em workloads e custo de aluguel antes de alugar GPUs na nuvem.
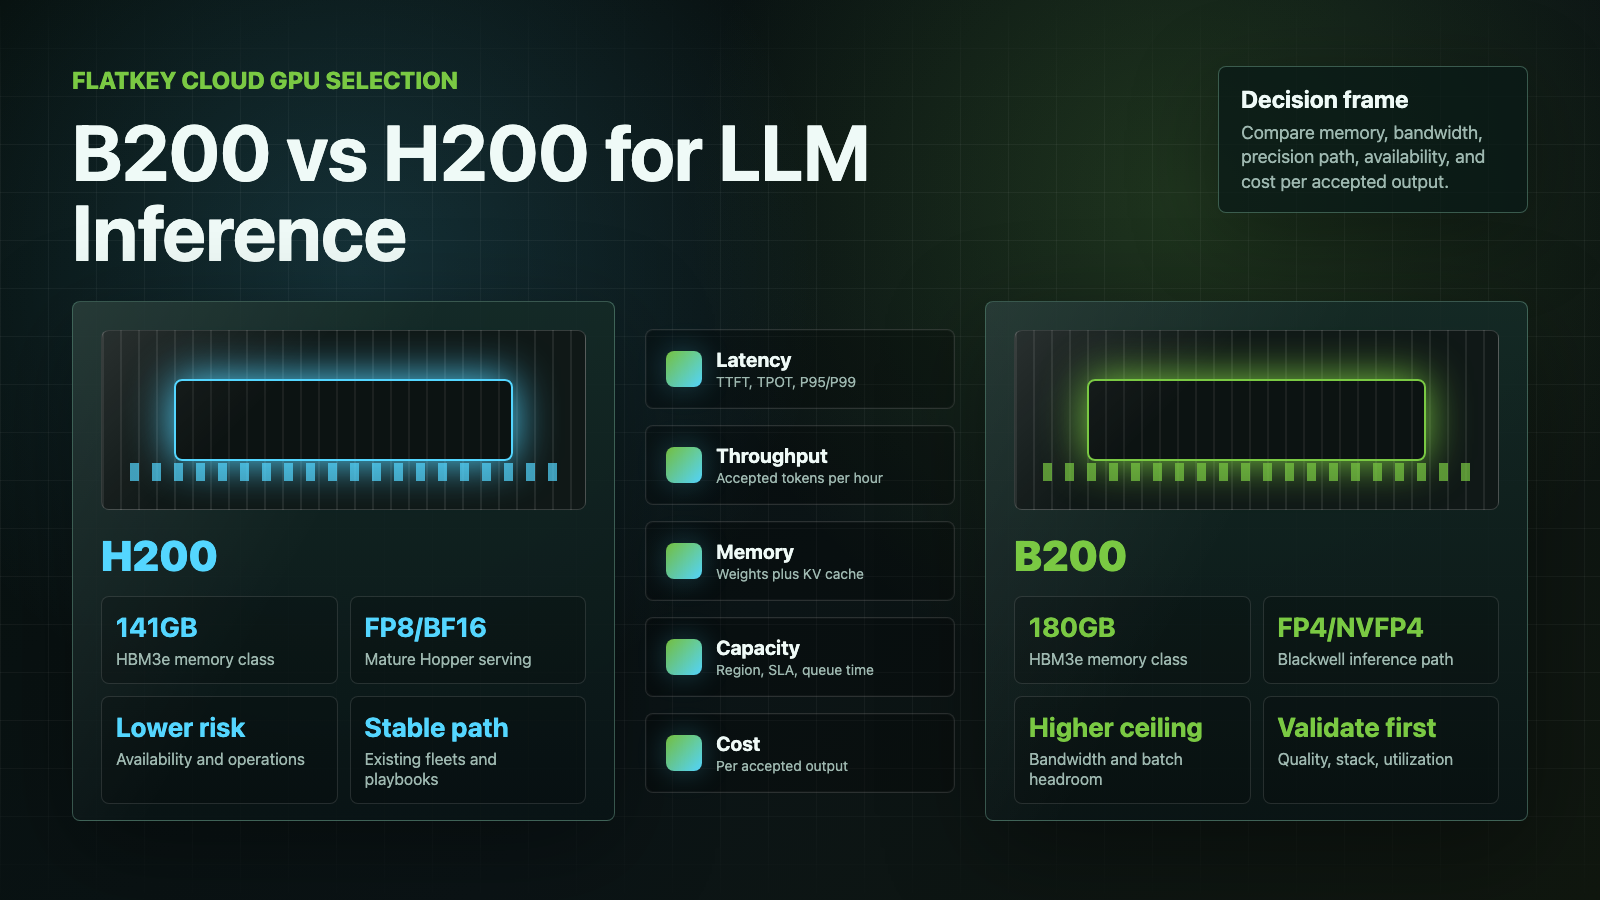
NVIDIA B200 vs H200: Qual GPU é melhor para inferência de LLM?
Compare o NVIDIA B200 vs H200 para inferência de LLM por memória, largura de banda, suporte a precisão, sistemas DGX, disponibilidade de GPUs na nuvem e custo por saída aceita.
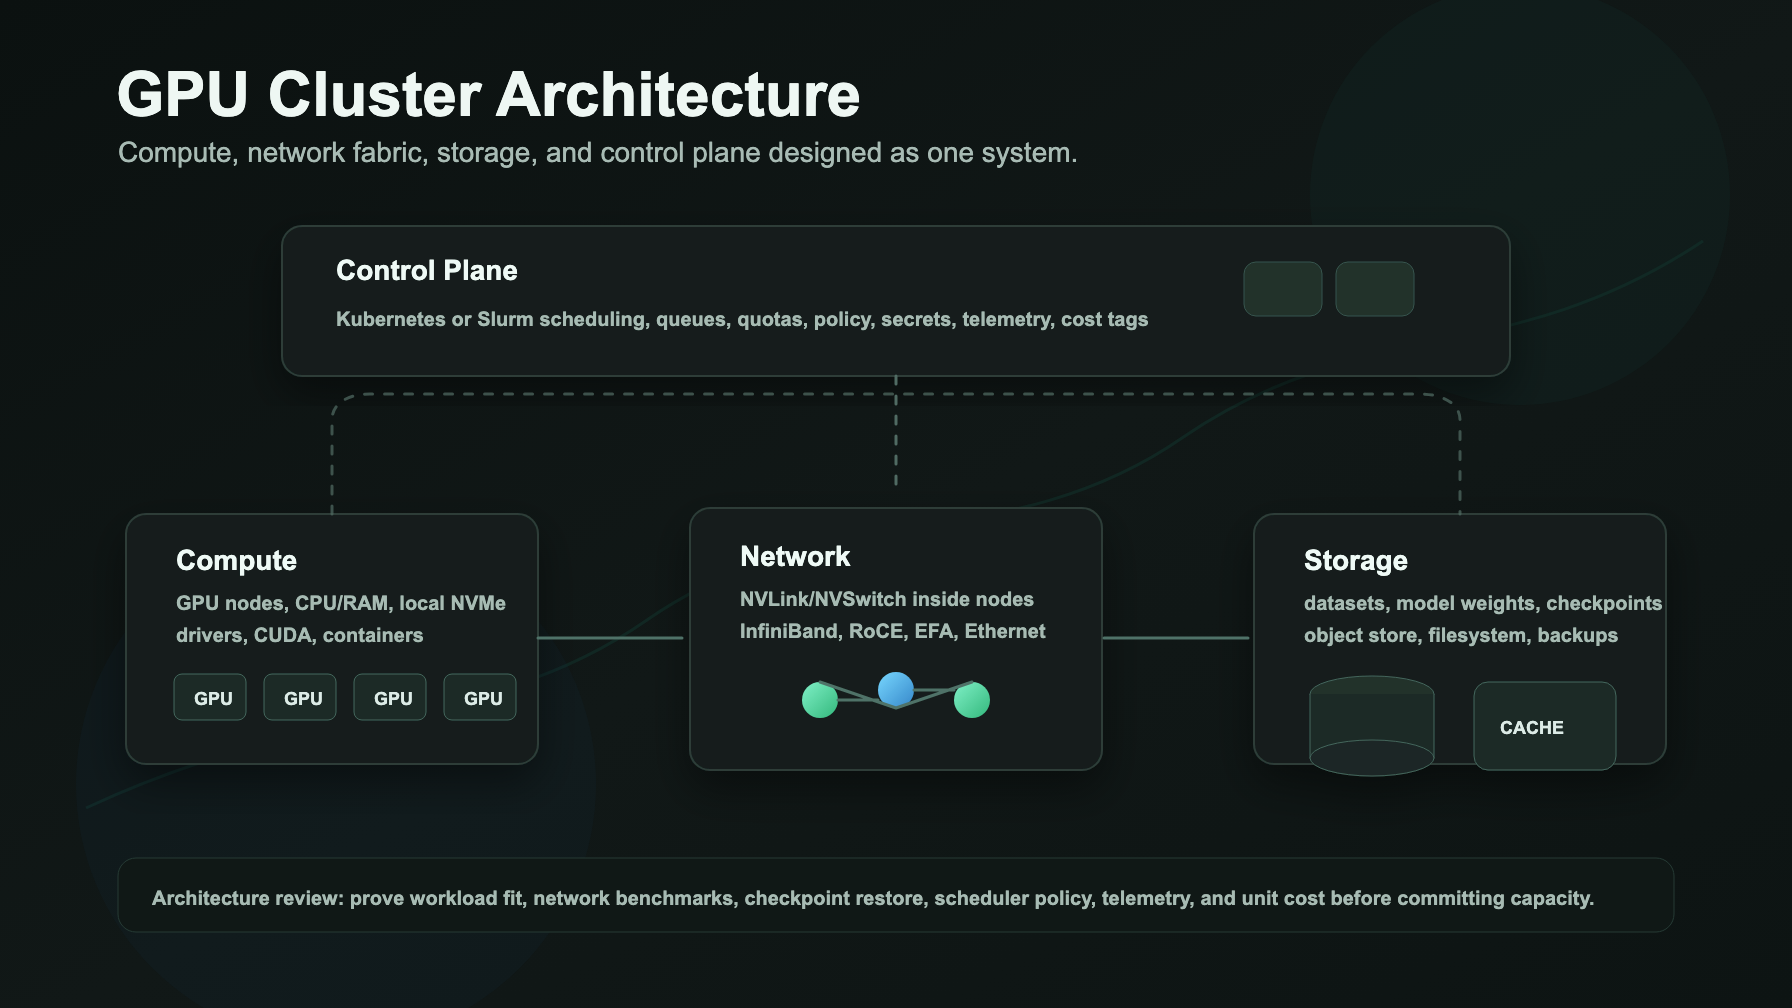
Arquitetura de Cluster GPU: Computação, Rede, Armazenamento e Plano de Controle
Um guia prático de arquitetura de cluster GPU para nós de computação, malha de rede, armazenamento, plano de controle Kubernetes ou Slurm, observabilidade e testes de aceitação.
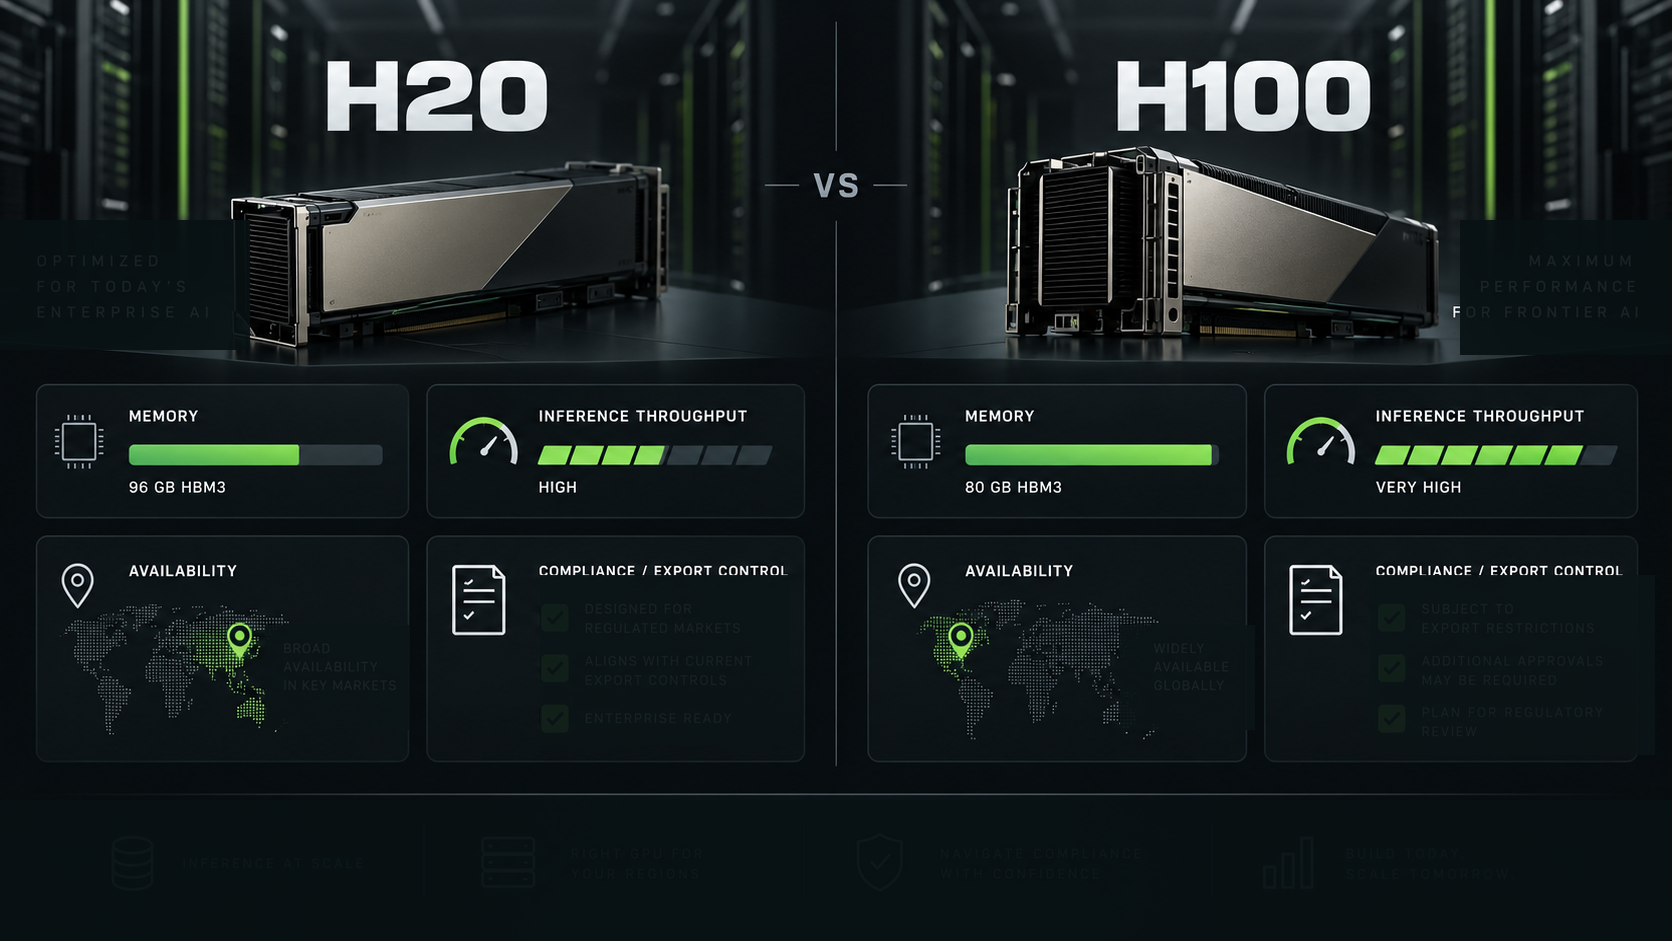
NVIDIA H20 vs H100: Inferência, Memória, Disponibilidade e Conformidade
Uma comparação prática entre H20 e H100 para equipas de IA empresarial, abrangendo inferência, memória, disponibilidade, risco de controlo de exportação e quando H200 ou APIs de modelos são melhores referências.
Melhores Plataformas de Aluguel de GPU na Nuvem em 2026: Preço, Capacidade, Rede e Suporte
Uma seleção prática de 2026 de plataformas de GPU na nuvem para equipes de IA, comparando preço, capacidade, rede, suporte e quando uma API de modelo é a melhor base.
NVIDIA Blackwell Ultra B300: O que mudou em relação ao B200?
Um guia prático do NVIDIA B300 Blackwell Ultra para equipas de infraestrutura de IA, comparando especificações do B300, estado de lançamento, alertas sobre preço e adequação de carga de trabalho face ao B200.
AMD MI455X e Helios: Rastreador de Arquitetura, Memória e Disponibilidade
Um rastreador voltado para compradores sobre o AMD MI455X e Helios, cobrindo arquitetura, memória HBM4, largura de banda, disponibilidade, prontidão para vLLM, dúvidas com provedores e estratégia de fallback de modelos/API.
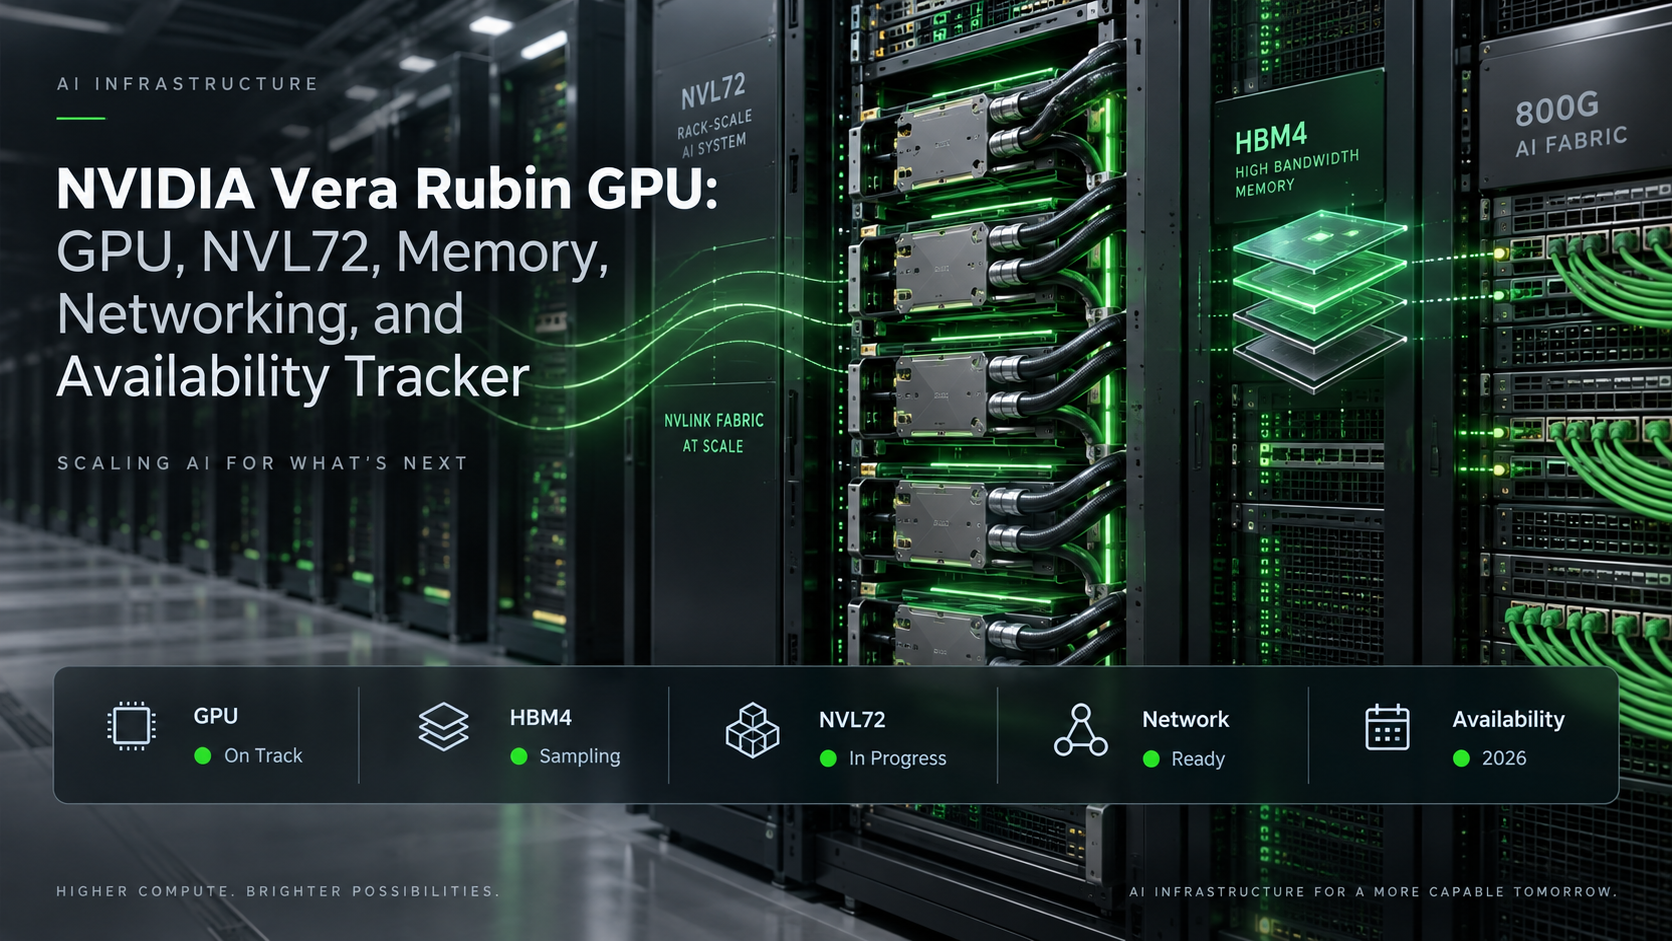
GPU NVIDIA Vera Rubin: GPU, NVL72, Memória, Rede e Rastreador de Disponibilidade
Um rastreador atualizado das especificações da GPU NVIDIA Vera Rubin, DGX Vera Rubin NVL72, memória HBM4, rede e marcos de disponibilidade para compradores de GPUs em nuvem.
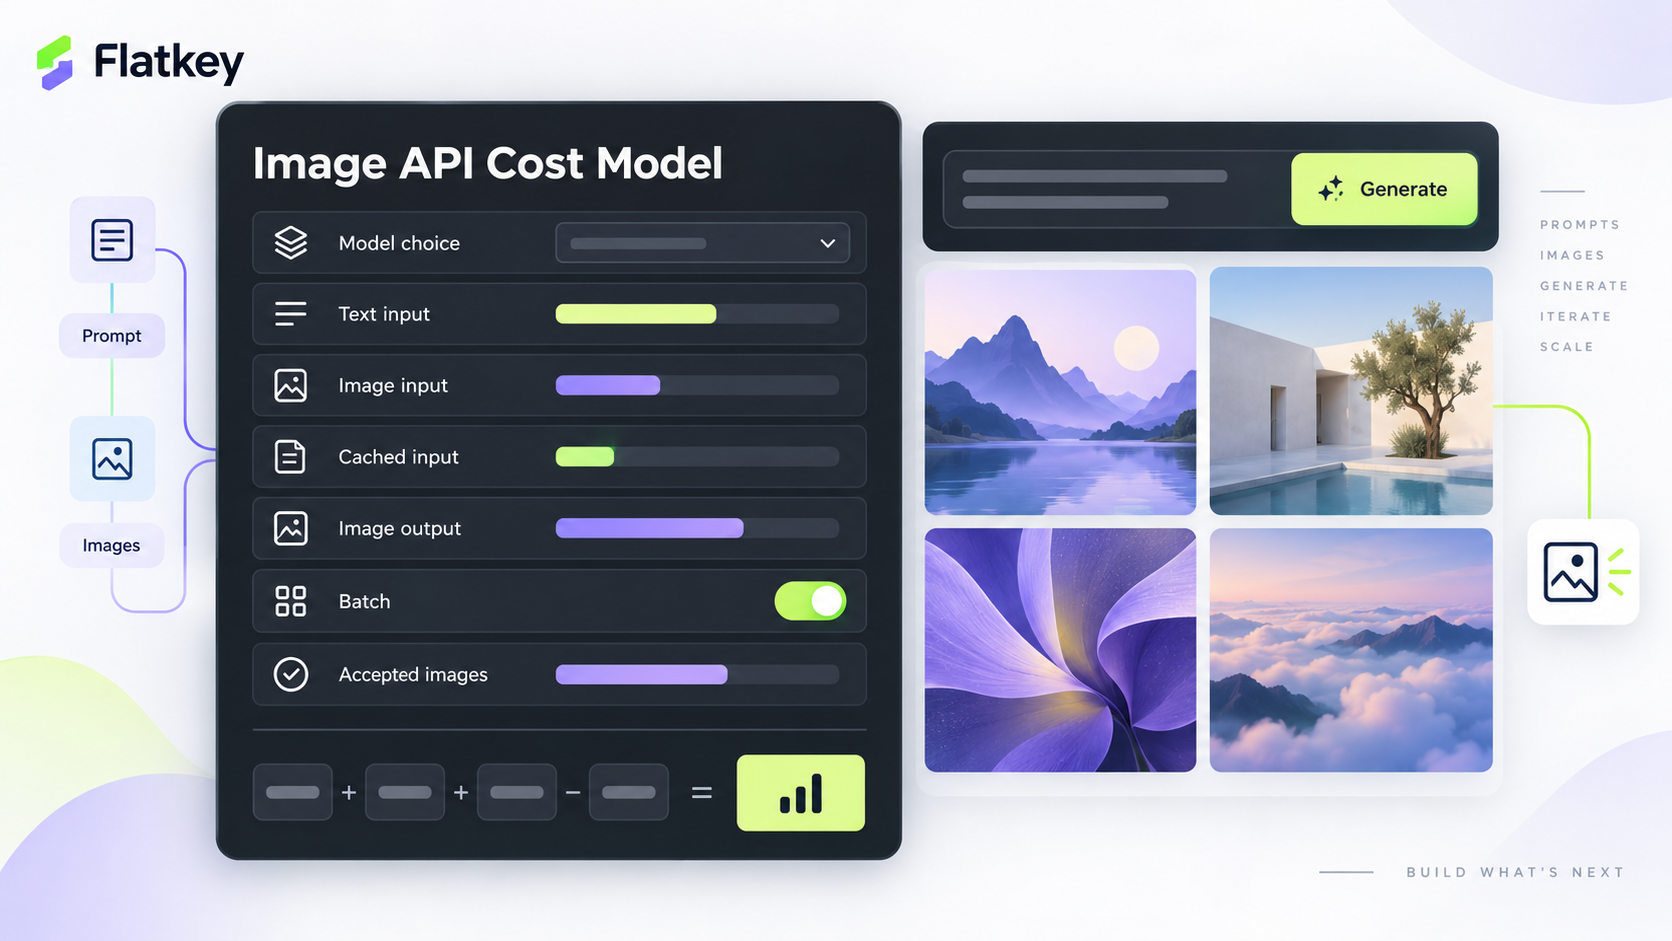
Preços da API de Imagem da OpenAI: taxas do GPT Image 2.5, fórmula de custo e controles de orçamento
Saiba como funciona o preço da API de imagem da OpenAI para o GPT Image 2.5, incluindo taxas por token, regras de entrada em cache, imagens parciais, Batch e custo por imagem aceita.
GB200 vs B200: Superchip Grace Blackwell ou HGX x86?
Compare GB200 vs B200 para aquisição de infraestrutura de IA: sistemas Grace Blackwell em escala de rack NVL72, nós B200 HGX/x86, benchmarks e análises de TCO.
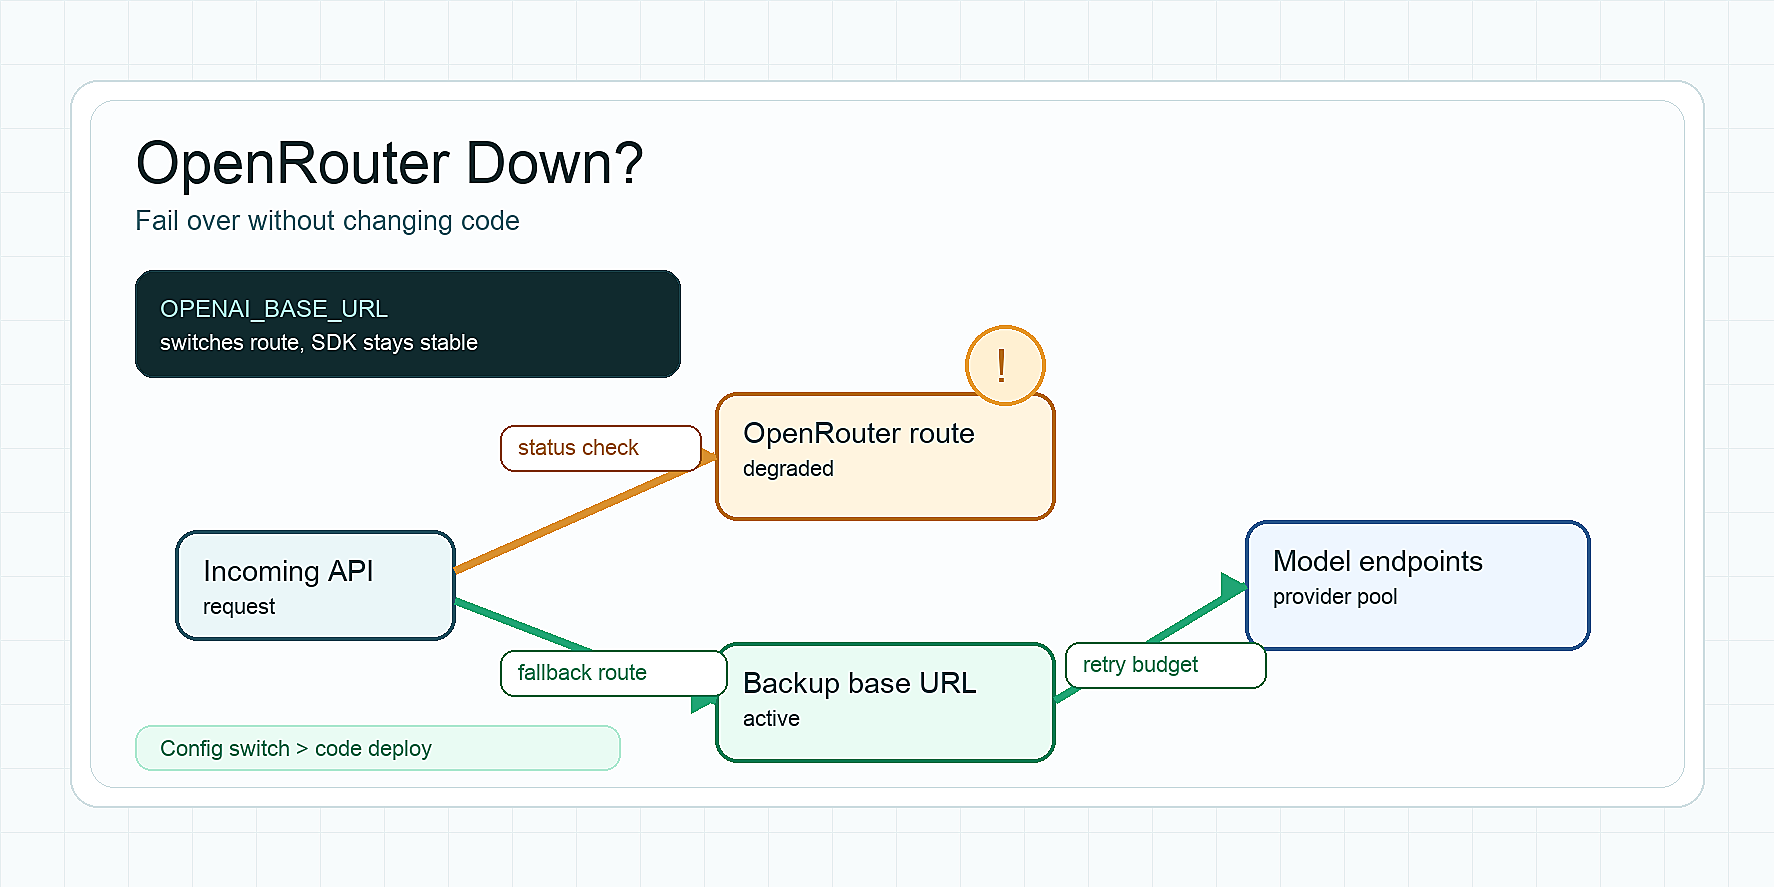
OpenRouter está fora do ar? Como fazer failover sem mudar o código
Verifique se o OpenRouter está fora do ar, diferencie erros do provedor de incidentes da plataforma e faça failover com base_url, retries, fallback de provedor e fallback de modelo.
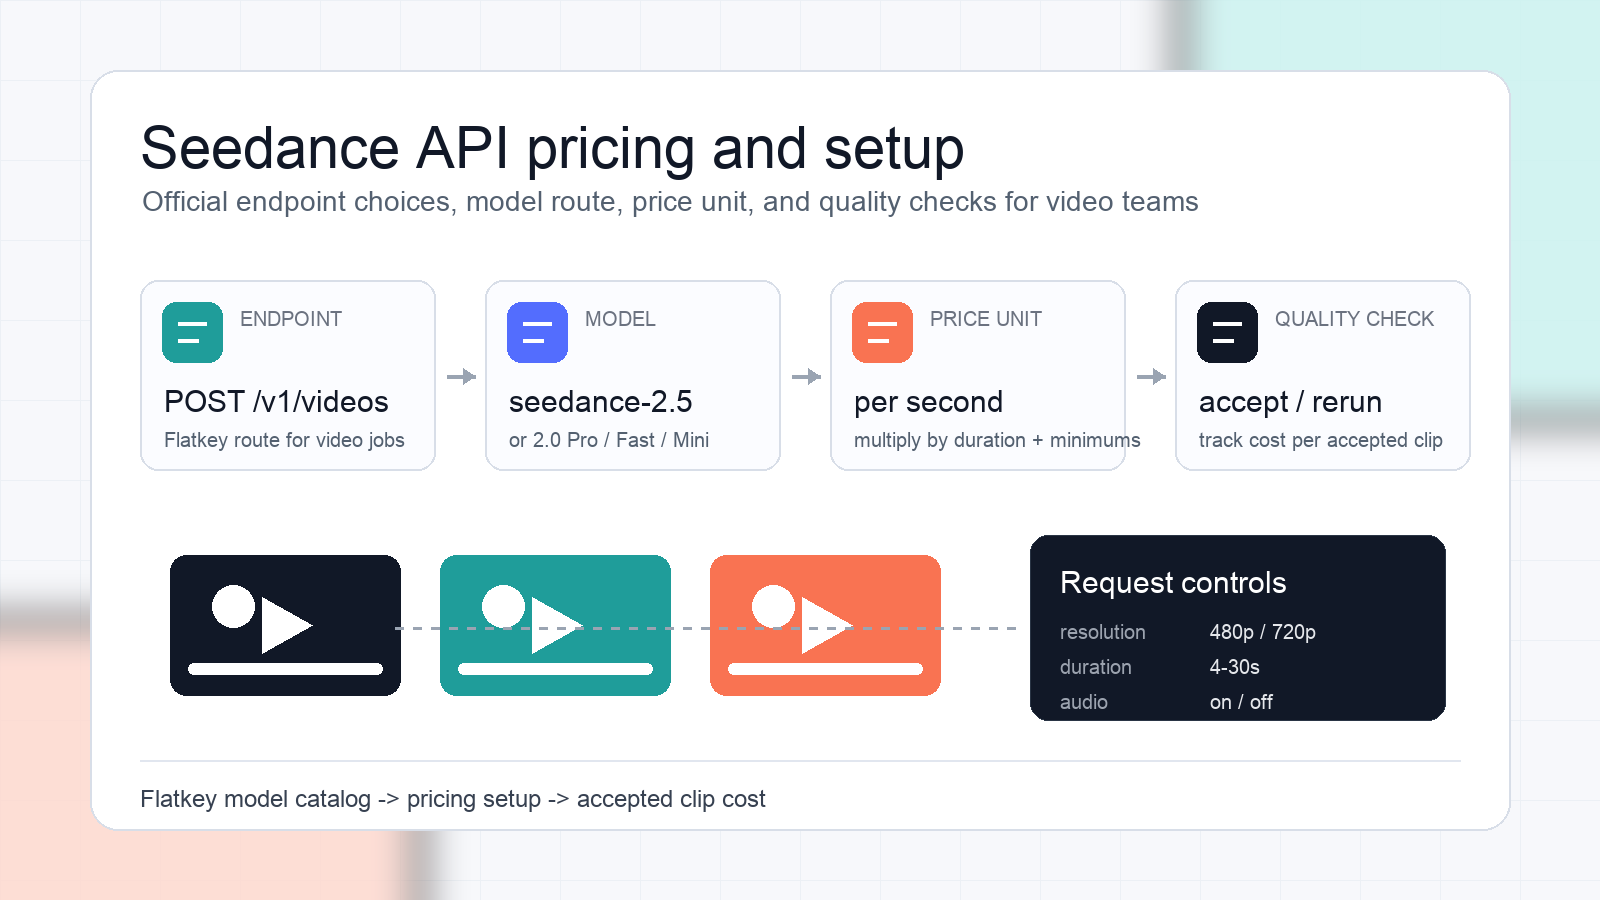
Seedance API: Preços, Qualidade e Configuração para Endpoints Oficiais
Compare as opções oficiais de endpoints da Seedance API, os preços por segundo da Flatkey, os passos de configuração e as verificações de qualidade para equipes de geração de vídeo.
O que é uma AI Factory? Clusters de GPU, Dados, Modelos e Operações
Saiba o que é uma AI factory, como clusters de GPU, pipelines de dados, modelos, inferência, governança e operações trabalham juntos, e quando APIs de modelos podem substituir a posse direta de GPUs.
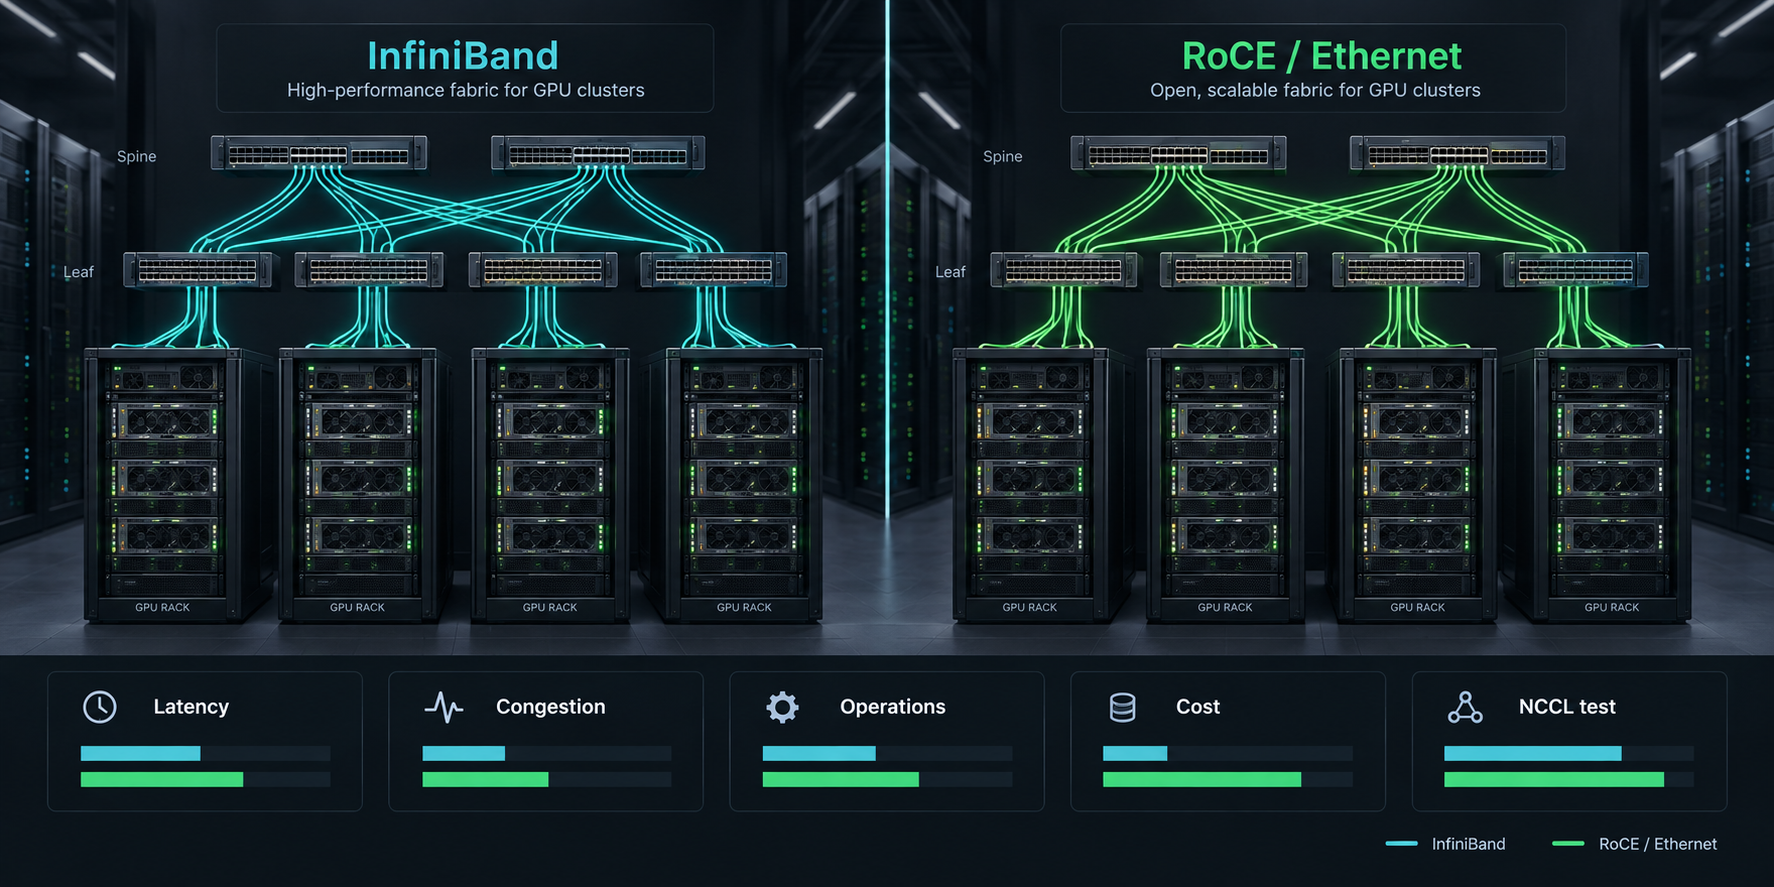
RoCE vs InfiniBand para Clusters de GPU: Latência, Operações e Custo
Compare RoCE e InfiniBand para clusters de GPU multi-nó com uma matriz prática de decisão, teste de aceitação NCCL, modelo de custos e checklist de aquisição.
Crie mais rápido com um único gateway de IA.
Use a flatkey.ai para gerenciar modelos, chaves, cobrança e observabilidade em uma plataforma de API.
Começar