
Blog da flatkey.ai
Insights, notas de produto e guias de implementação para equipes que criam com APIs de IA.
Arquitetura de gateways de IA
Artigos mais recentes em Arquitetura de gateways de IA.
Ler maisMigração de URL base e SDK
Artigos mais recentes em Migração de URL base e SDK.
Ler maisCustos, cobrança e operações
Artigos mais recentes em Custos, cobrança e operações.
Ler maisControles empresariais e confiança
Artigos mais recentes em Controles empresariais e confiança.
Ler maisComparações de gateways
Artigos mais recentes em Comparações de gateways.
Ler maisGuias de modelos e modalidades
Artigos mais recentes em Guias de modelos e modalidades.
Ler maisConfiabilidade e roteamento
Artigos mais recentes em Confiabilidade e roteamento.
Ler maisIntegrações de ferramentas
Artigos mais recentes em Integrações de ferramentas.
Ler mais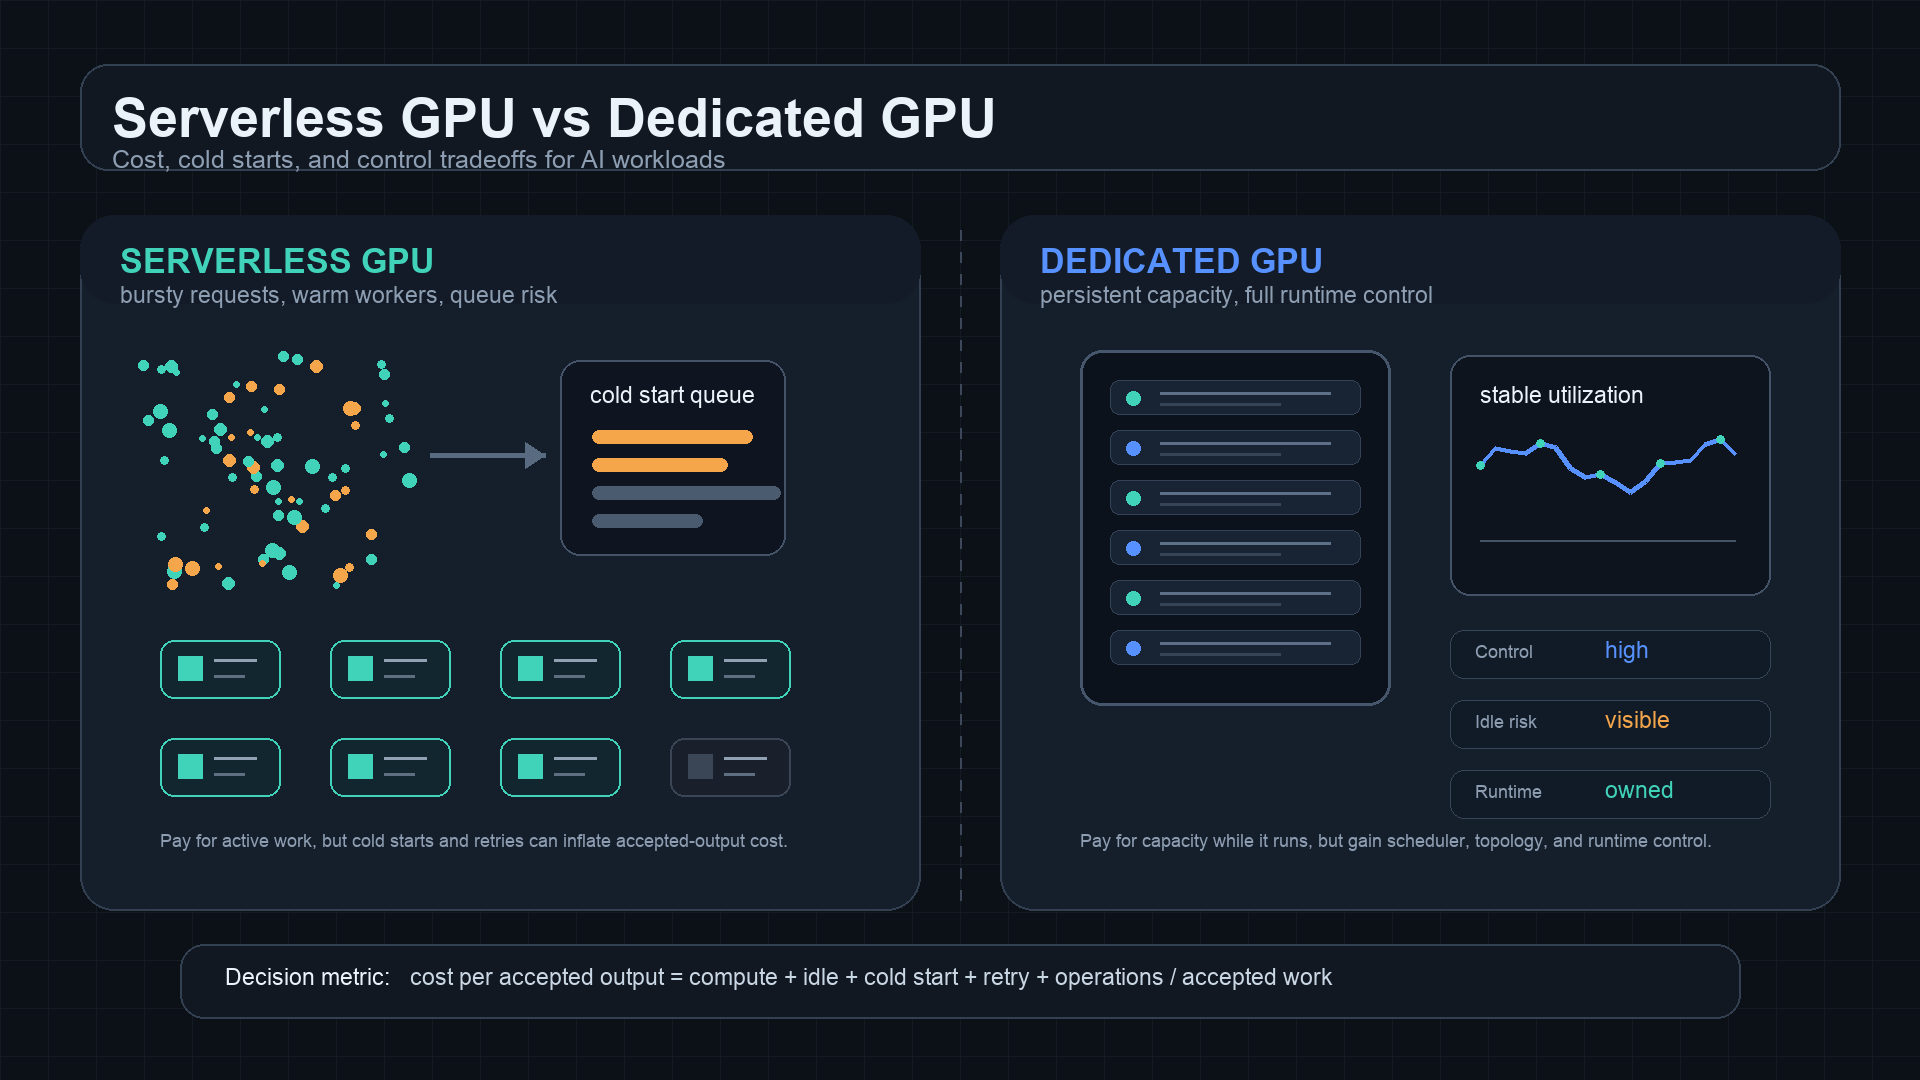
GPU serverless vs GPU dedicado: custo, cold starts e controle
Compare GPU serverless vs GPU dedicado por custo por saída aceita, cold starts, capacidade ociosa, autoscaling e controle operacional.

Comparação de Preços de APIs de Geração de Imagens por IA: GPT Image, Gemini, Imagen e fal
Compare os preços das APIs de geração de imagens entre GPT Image, Gemini Image, Imagen e rotas fal, normalizando as unidades de cobrança em custo por imagem aceita.
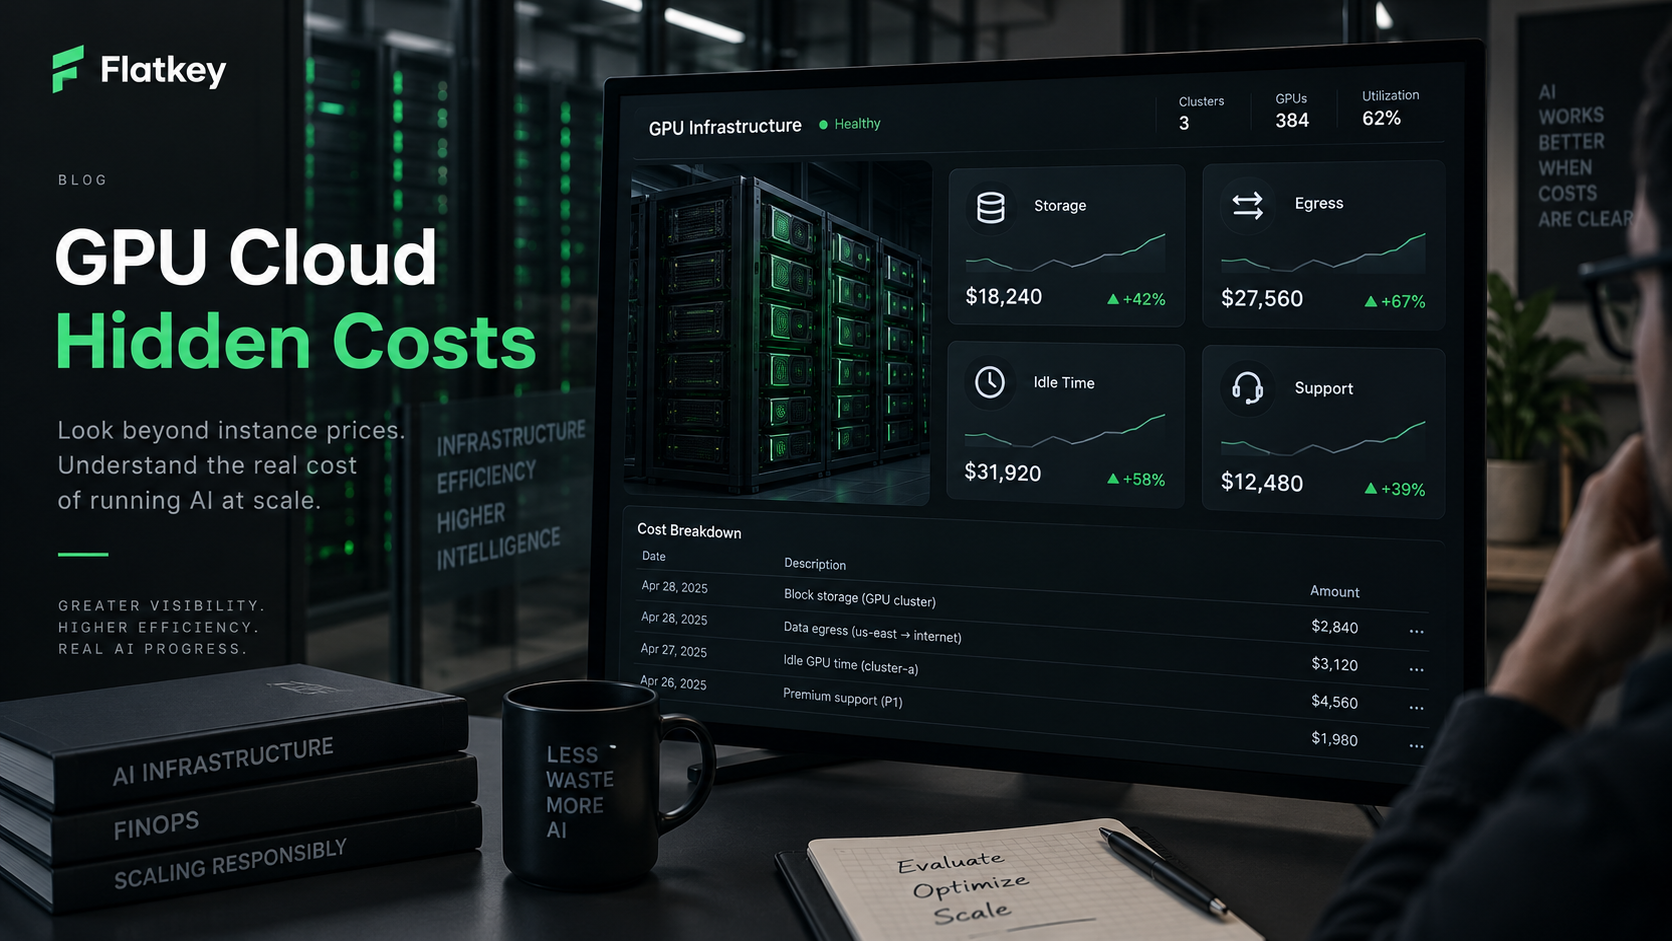
Quais são os custos ocultos dos serviços de GPU na nuvem? Armazenamento, egress, tempo ocioso e suporte
Um guia prático de TCO para GPU na nuvem, para identificar custos de armazenamento, egress, tempo ocioso, falhas de jobs, suporte, rede e operações antes que a fatura chegue.
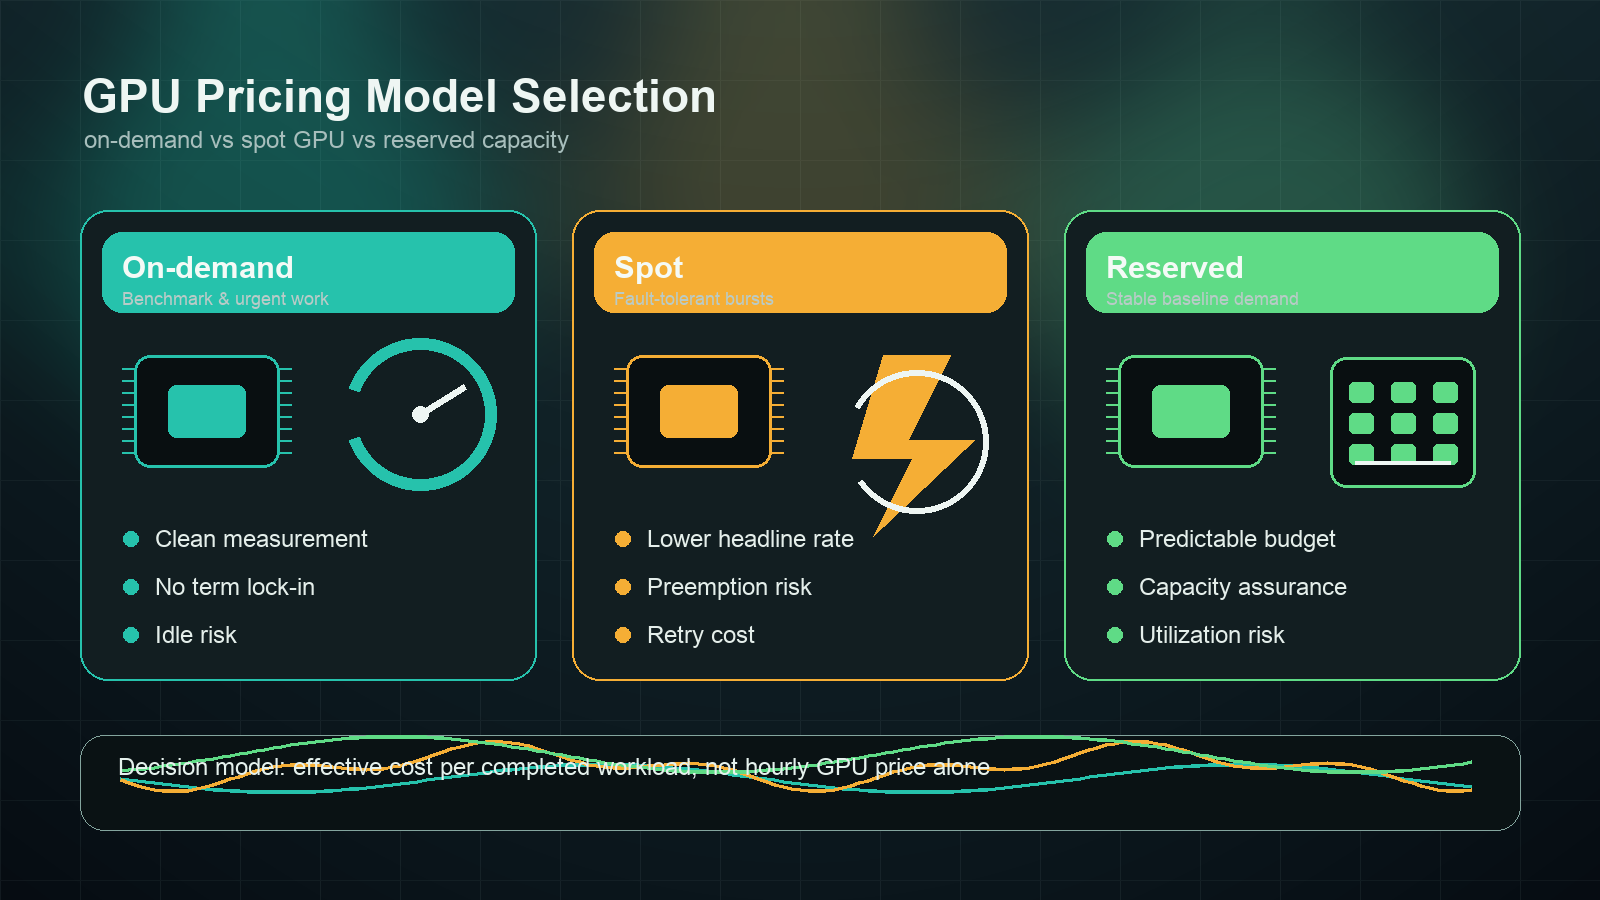
Preços de GPU sob demanda vs spot vs reservada: qual modelo se adapta à sua carga de trabalho?
Uma estrutura orientada pela carga de trabalho para escolher capacidade de GPU sob demanda, spot ou reservada sem confundir a tarifa horária listada com o custo da carga de trabalho concluída.
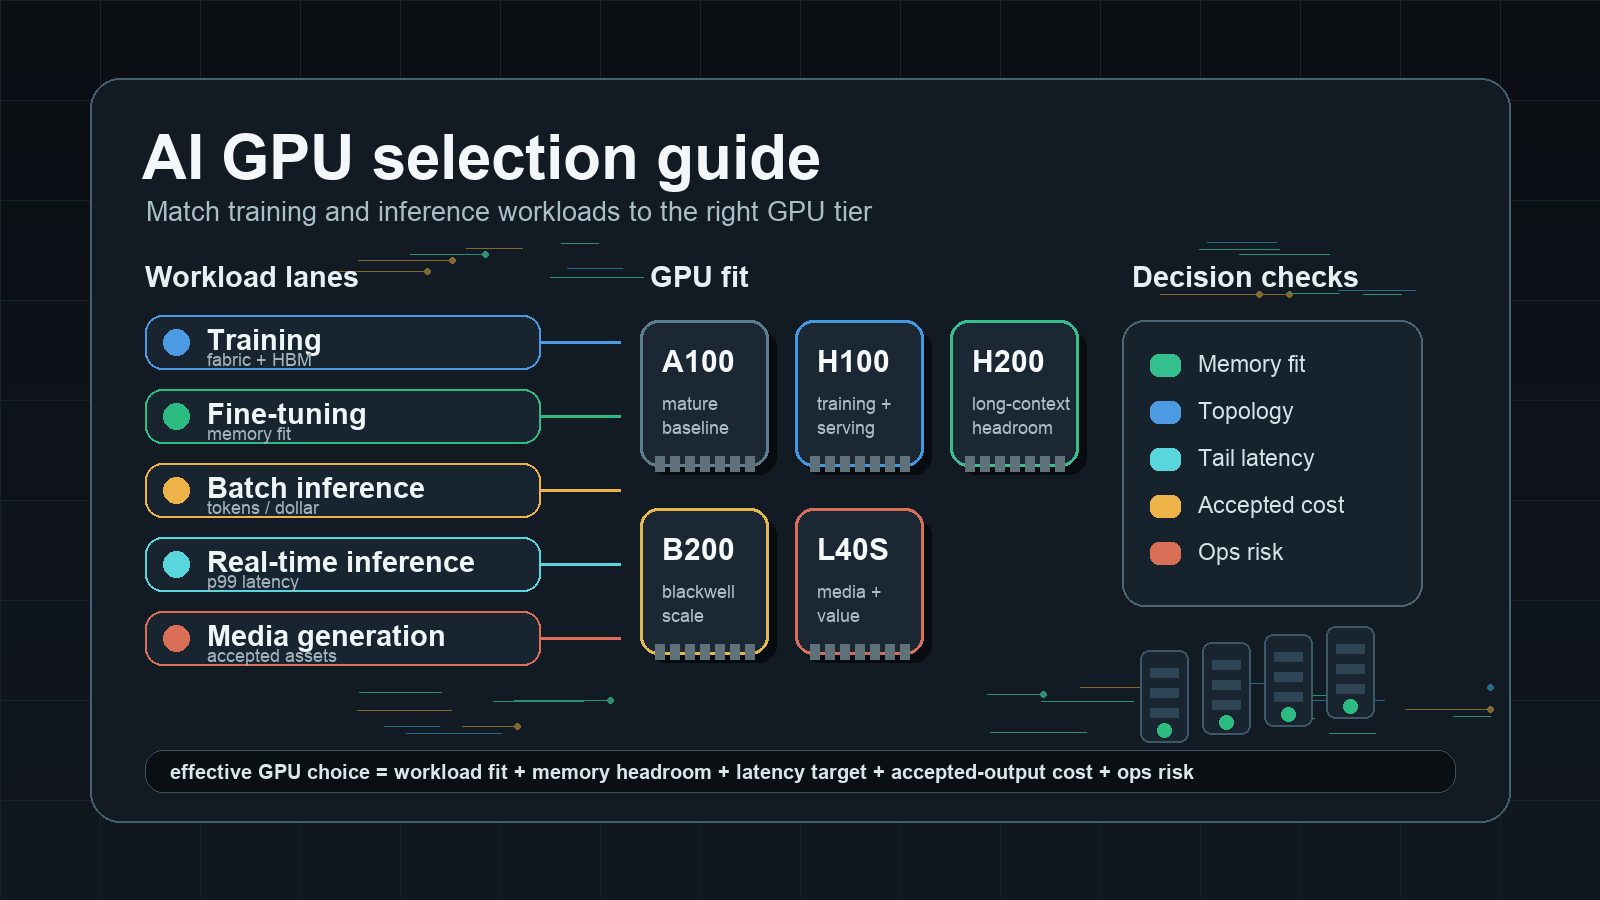
Guia de Seleção de GPU para IA: Combine Cargas de Trabalho de Treinamento e Inferência com a GPU Certa
Um guia prático de seleção de GPU para IA, voltado a equipes que precisam alinhar cargas de trabalho de treinamento, fine-tuning, inferência de LLMs, geração de mídia e avaliação à GPU e ao modelo de capacidade certos.
Nuvem Privada de GPU: Arquitetura, Isolamento e Modelo Operacional
Saiba como avaliar a arquitetura de nuvem privada de GPU, o isolamento, a propriedade do scheduler, as evidências de segurança, o modelo operacional, o TCO e os testes de aceitação.

Guia de Implantação do vLLM: Sirva uma API de LLM Compatível com a OpenAI em GPUs
Implante o vLLM como uma API compatível com a OpenAI em GPUs com Docker, RunPod Serverless, Ray Serve, métricas, controles de rollout e verificações de custo por saída aceita.
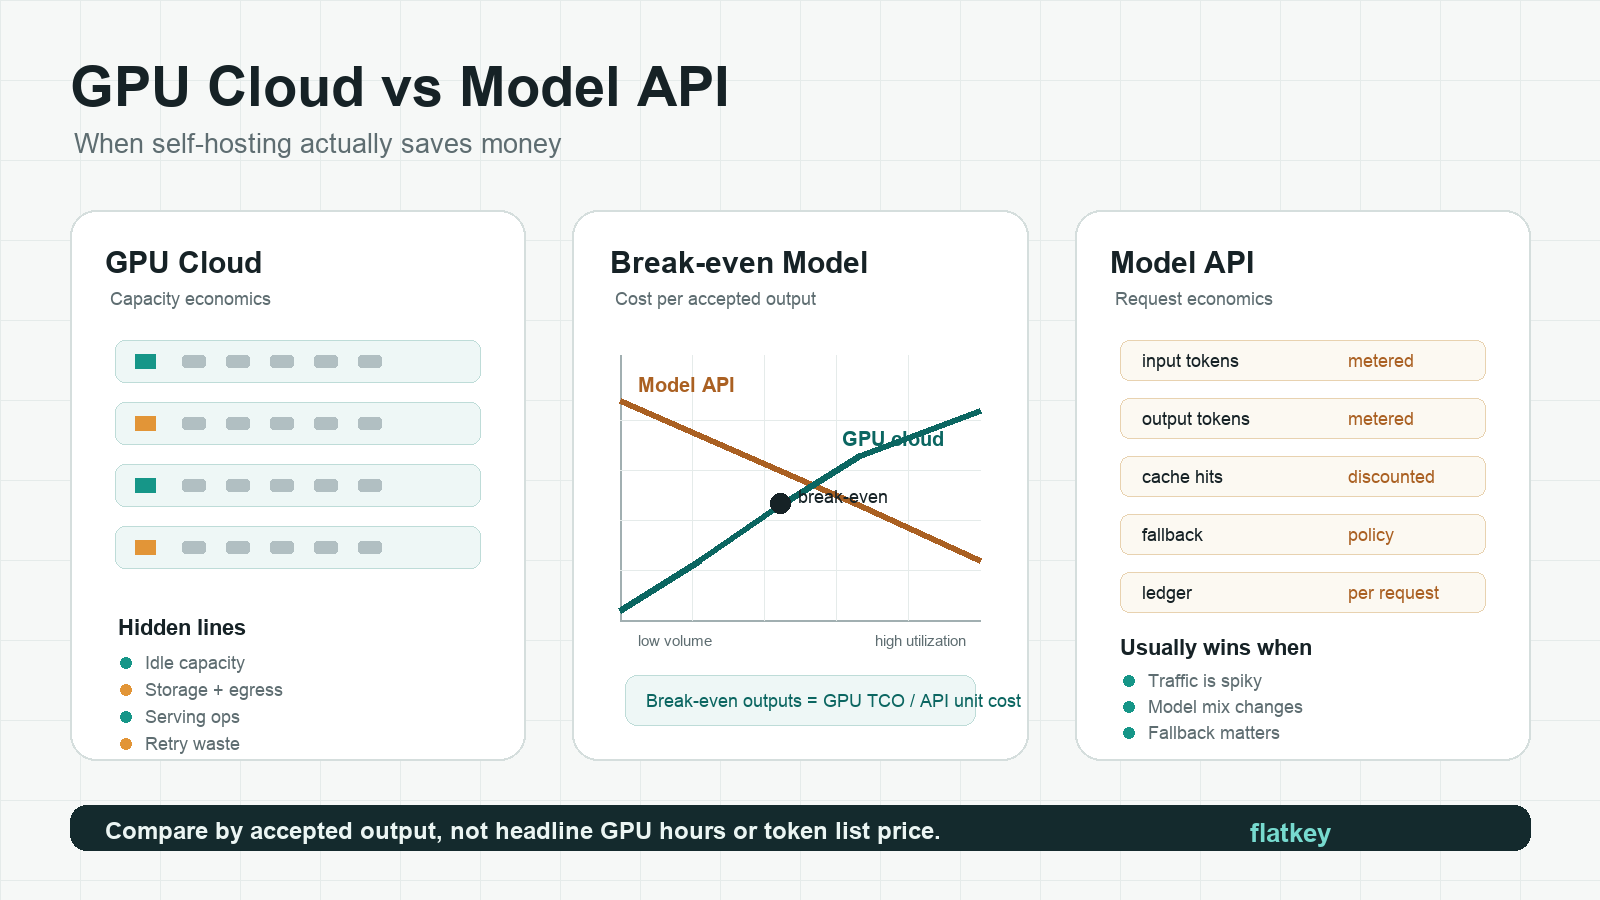
GPU Cloud vs API de Modelo: Quando a Auto-hospedagem Realmente Economiza Dinheiro
Compare a economia entre GPU cloud e API de modelo com uma planilha de ponto de equilíbrio para custo por saída aceita, utilização, retries, capacidade ociosa e operações de serving.
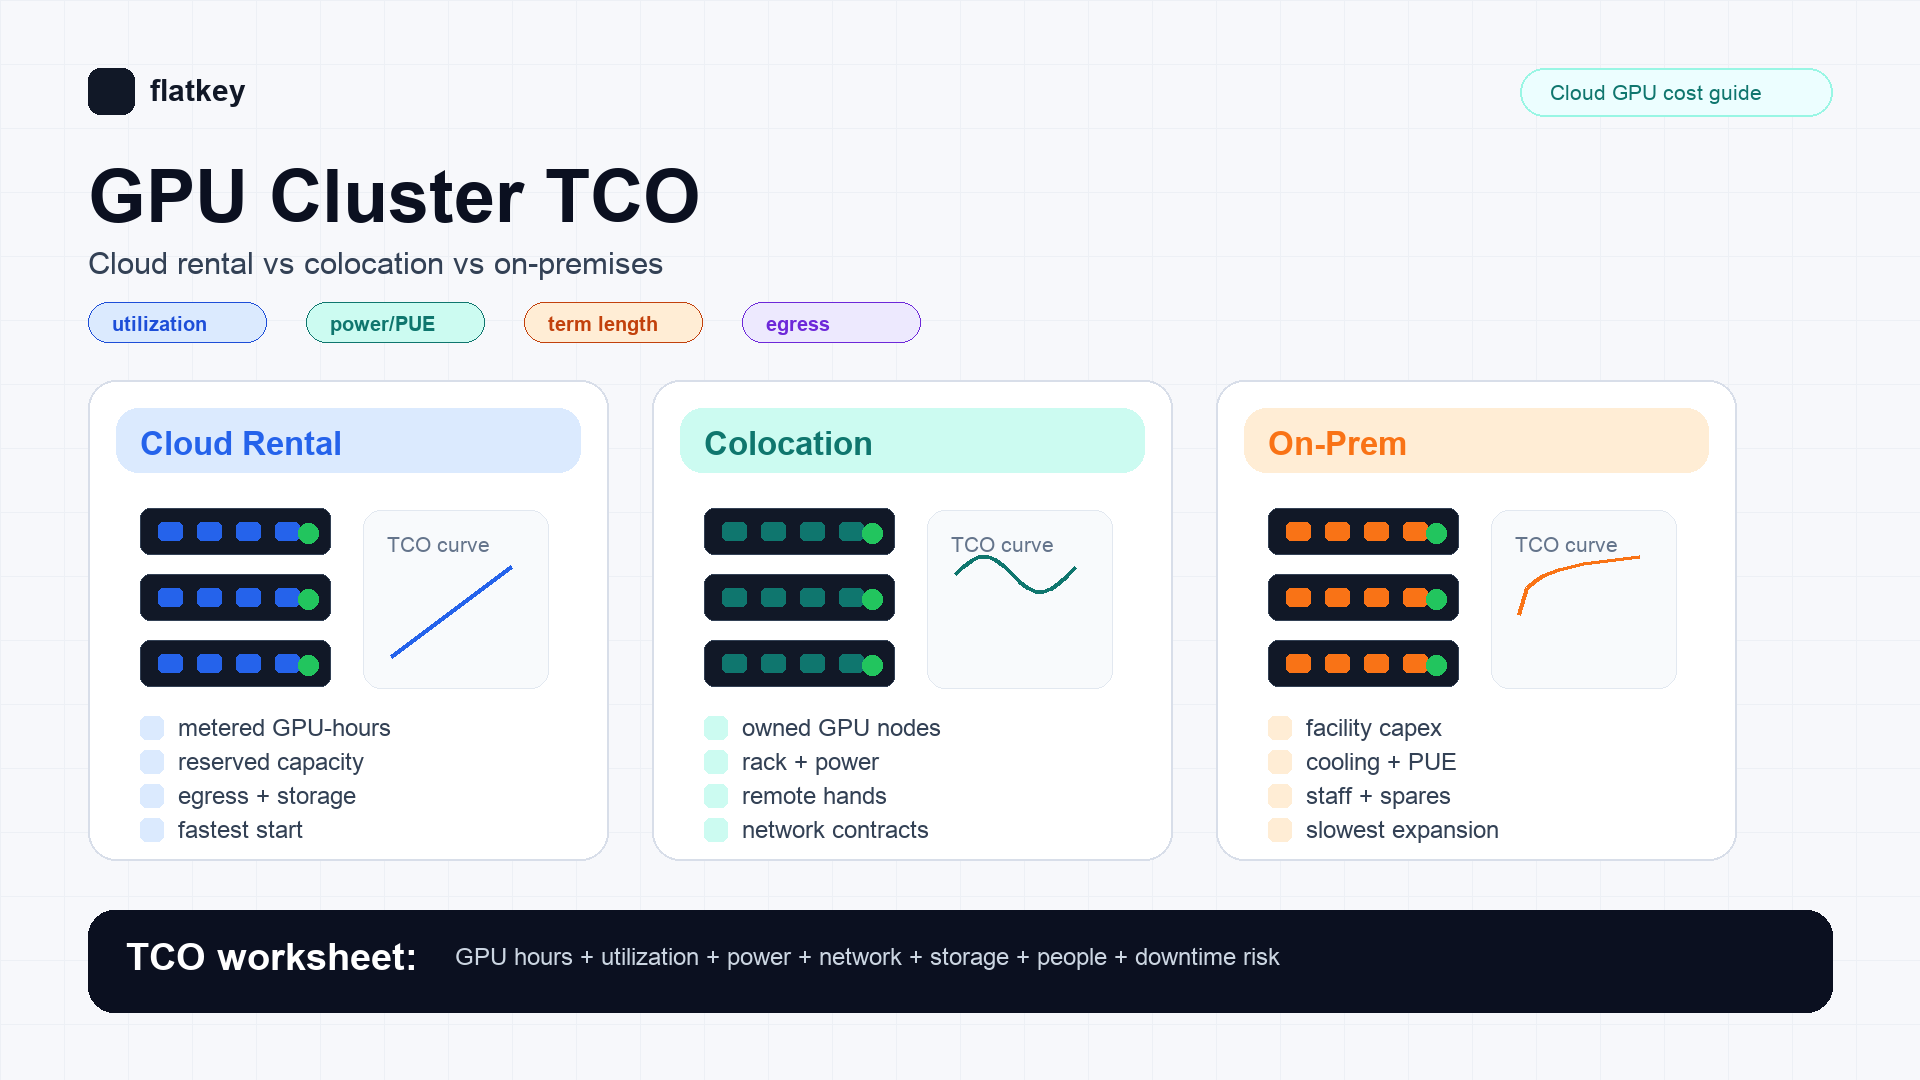
TCO de Cluster GPU: aluguel na nuvem vs colocation vs on-premises
Compare o TCO de clusters GPU entre aluguel na nuvem, colocation e on-premises com uma planilha prática de FinOps para compradores de infraestrutura de IA.
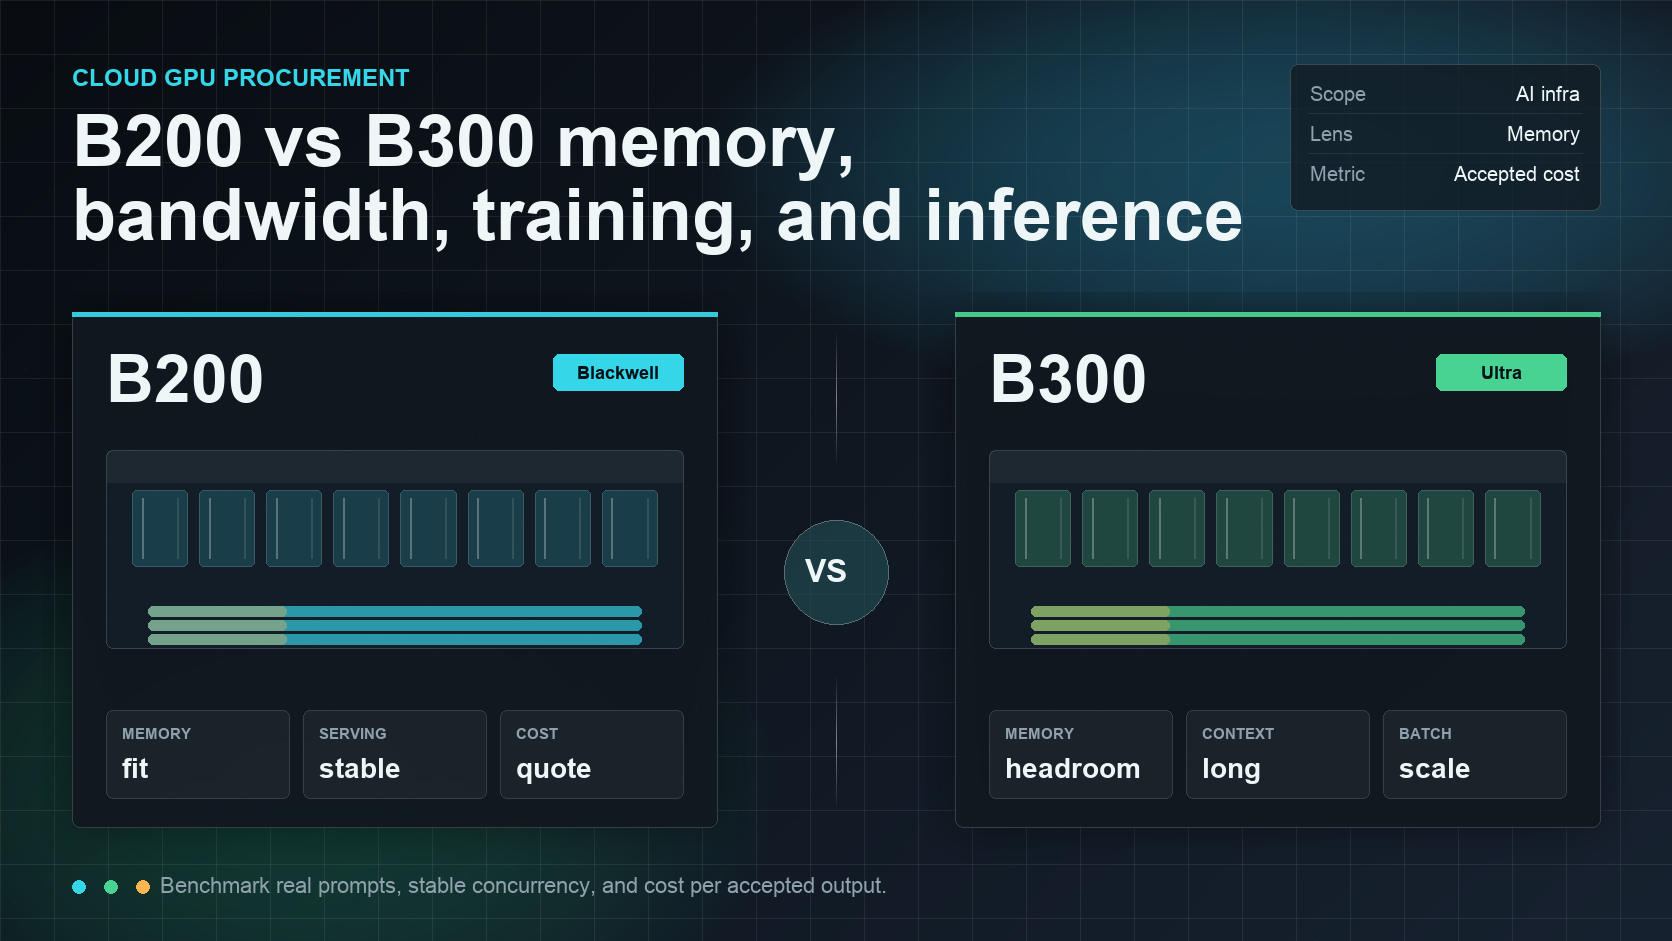
NVIDIA B300 vs B200: Memória, Banda, Treino e Inferência
Uma comparação prática entre B200 e B300 para equipas de infraestrutura de ML que avaliam a memória, a largura de banda, o treino, a inferência e a economia de aquisição das GPUs NVIDIA Blackwell.
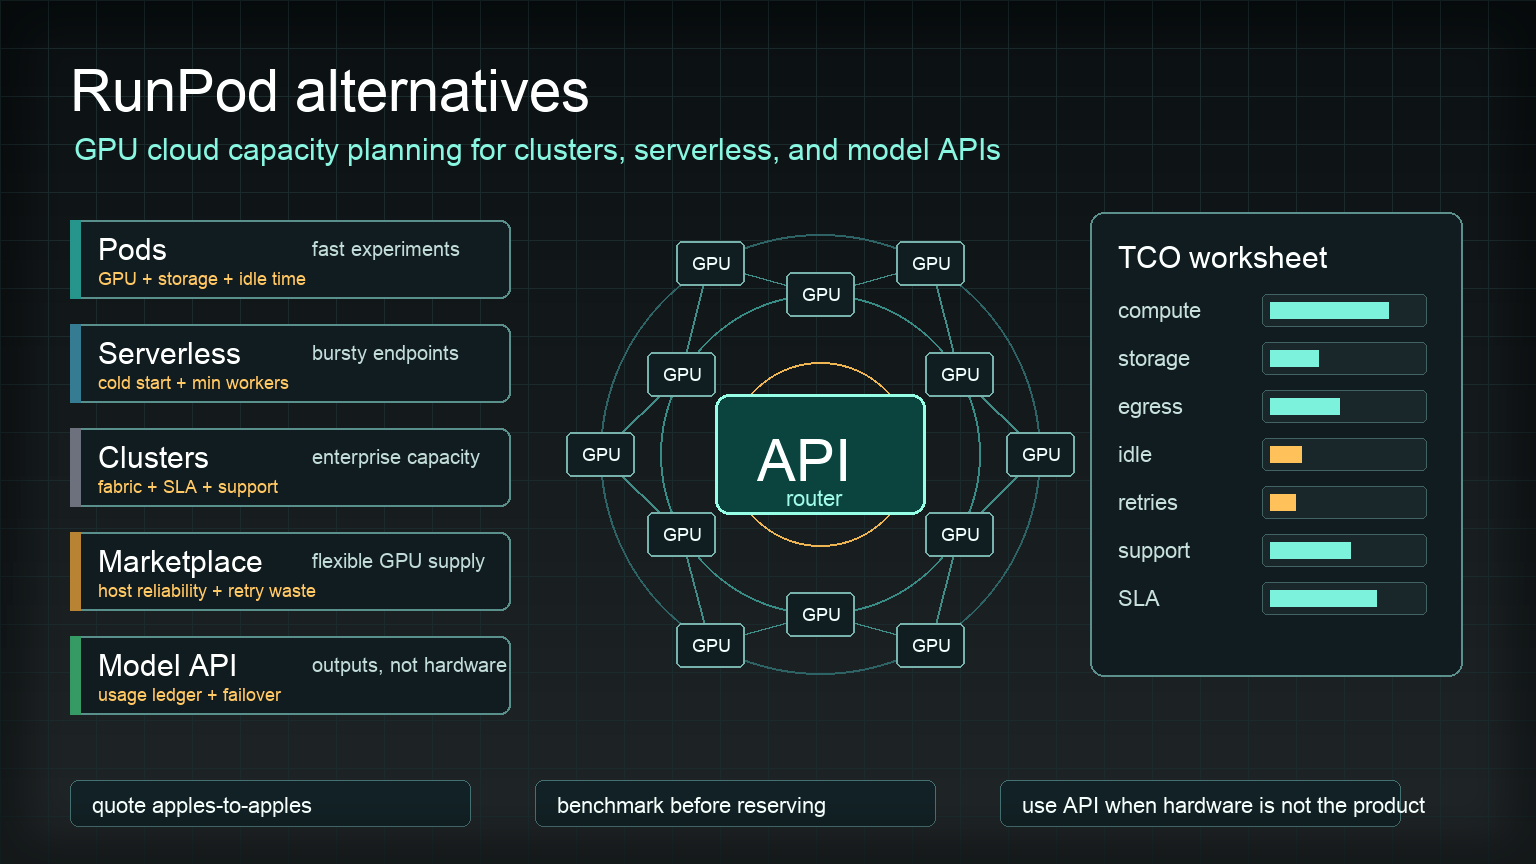
10 melhores alternativas ao RunPod em 2026: preços, vantagens e qual escolher
Compare 10 alternativas ao RunPod com preços de GPUs de outubro de 2026: marketplaces mais baratos, nuvens de GPU estáveis, plataformas serverless e APIs de modelos, além de Vast.ai vs RunPod, confiabilidade e um checklist de migração.
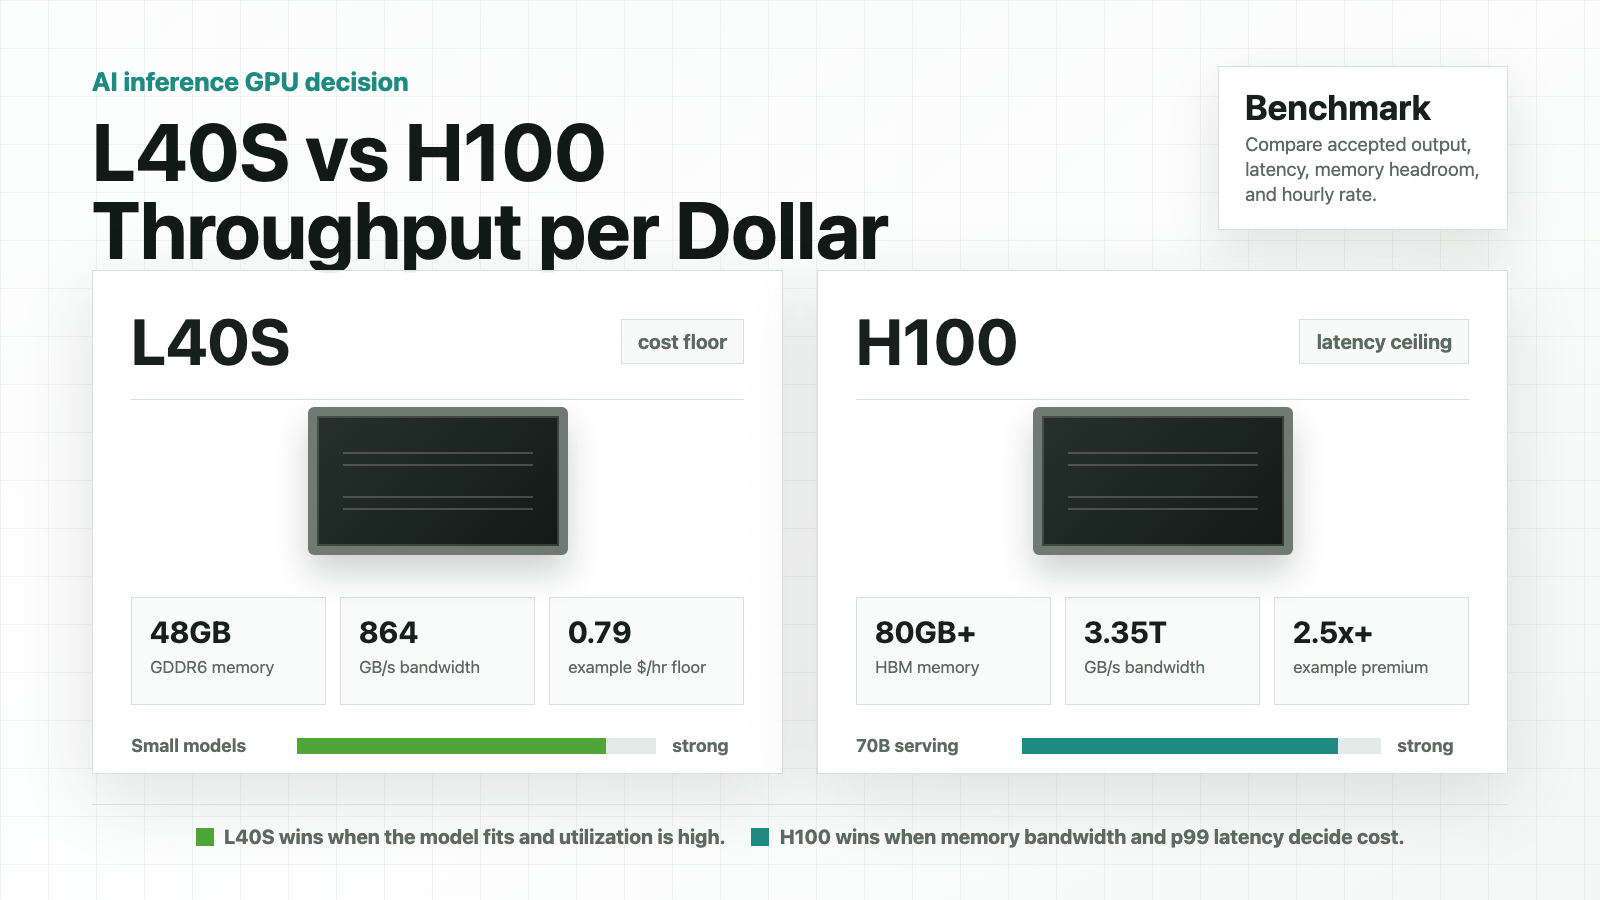
NVIDIA L40S vs H100 para Inferência de IA: Throughput por Dólar
Uma comparação prática entre L40S e H100 para equipes de IA que avaliam throughput de inferência, latência, adequação de memória e custo de GPU na nuvem por saída aceita.
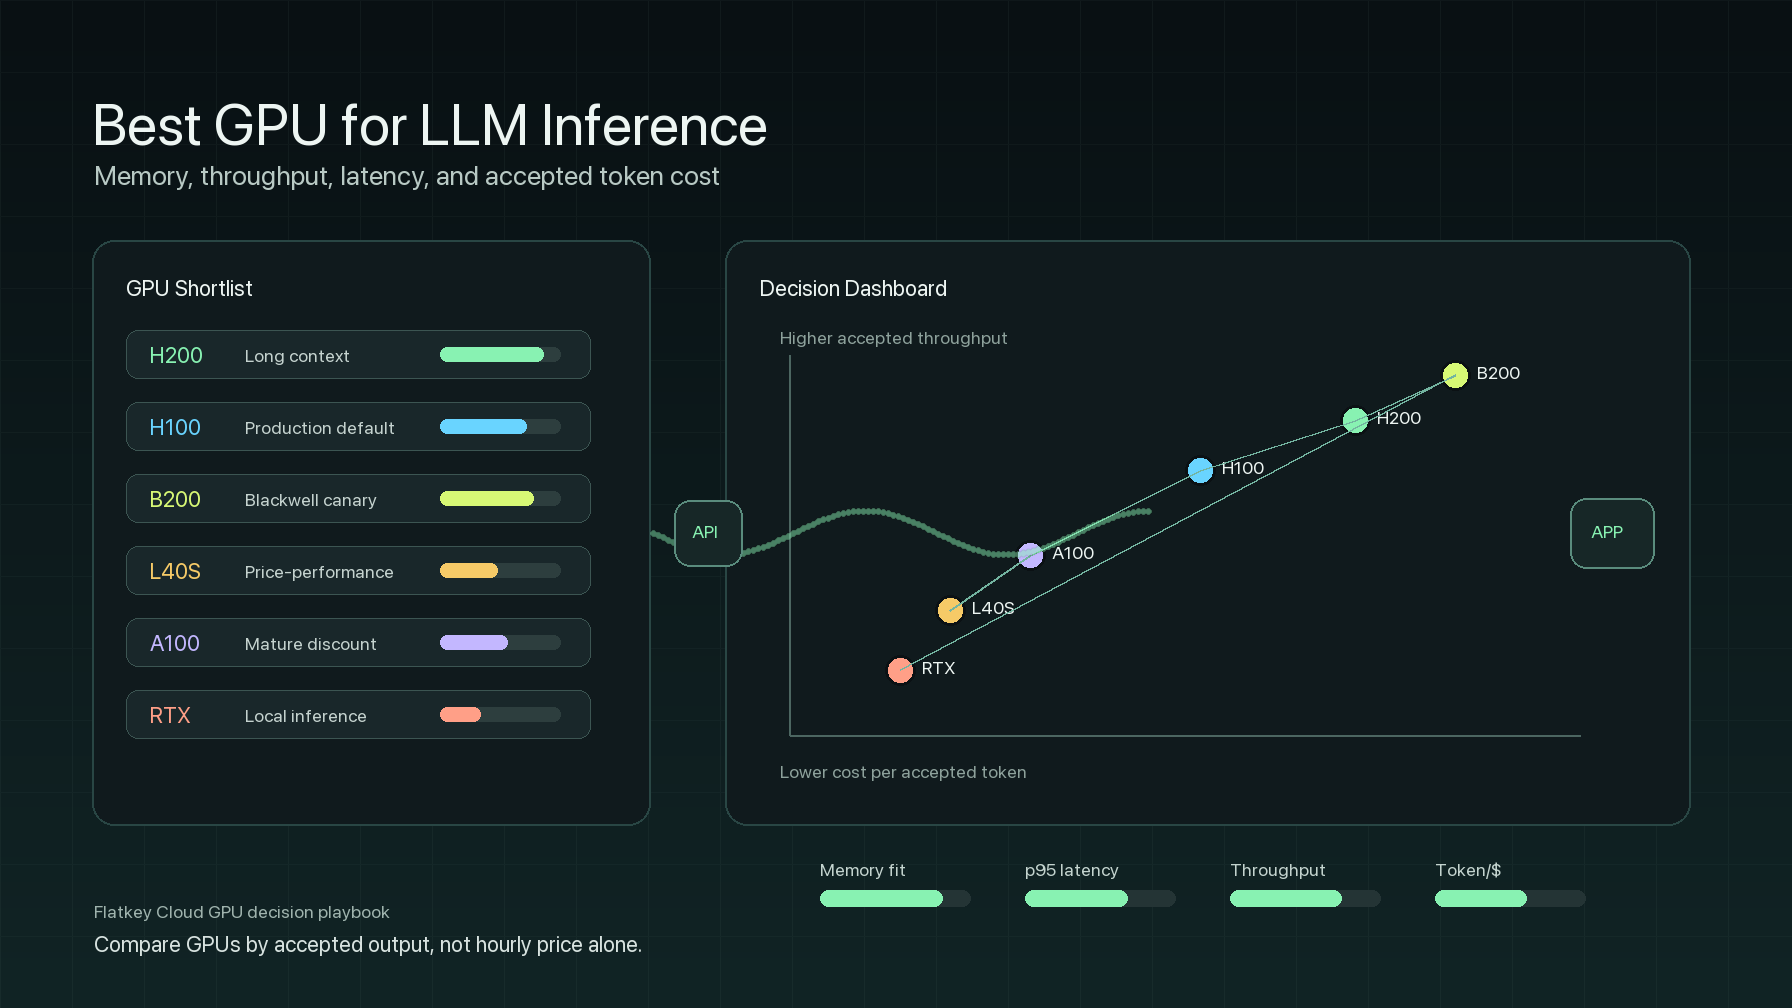
Melhor GPU para Inferência de LLM: Memória, Rendimento, Latência e Custo
Um guia prático de seleção de GPU para equipes empresariais de inferência de LLM, comparando H100, H200, B200, A100, L40S, GPUs locais da classe RTX, tokens por dólar, latência p95, adequação de memória e custo por token aceito.
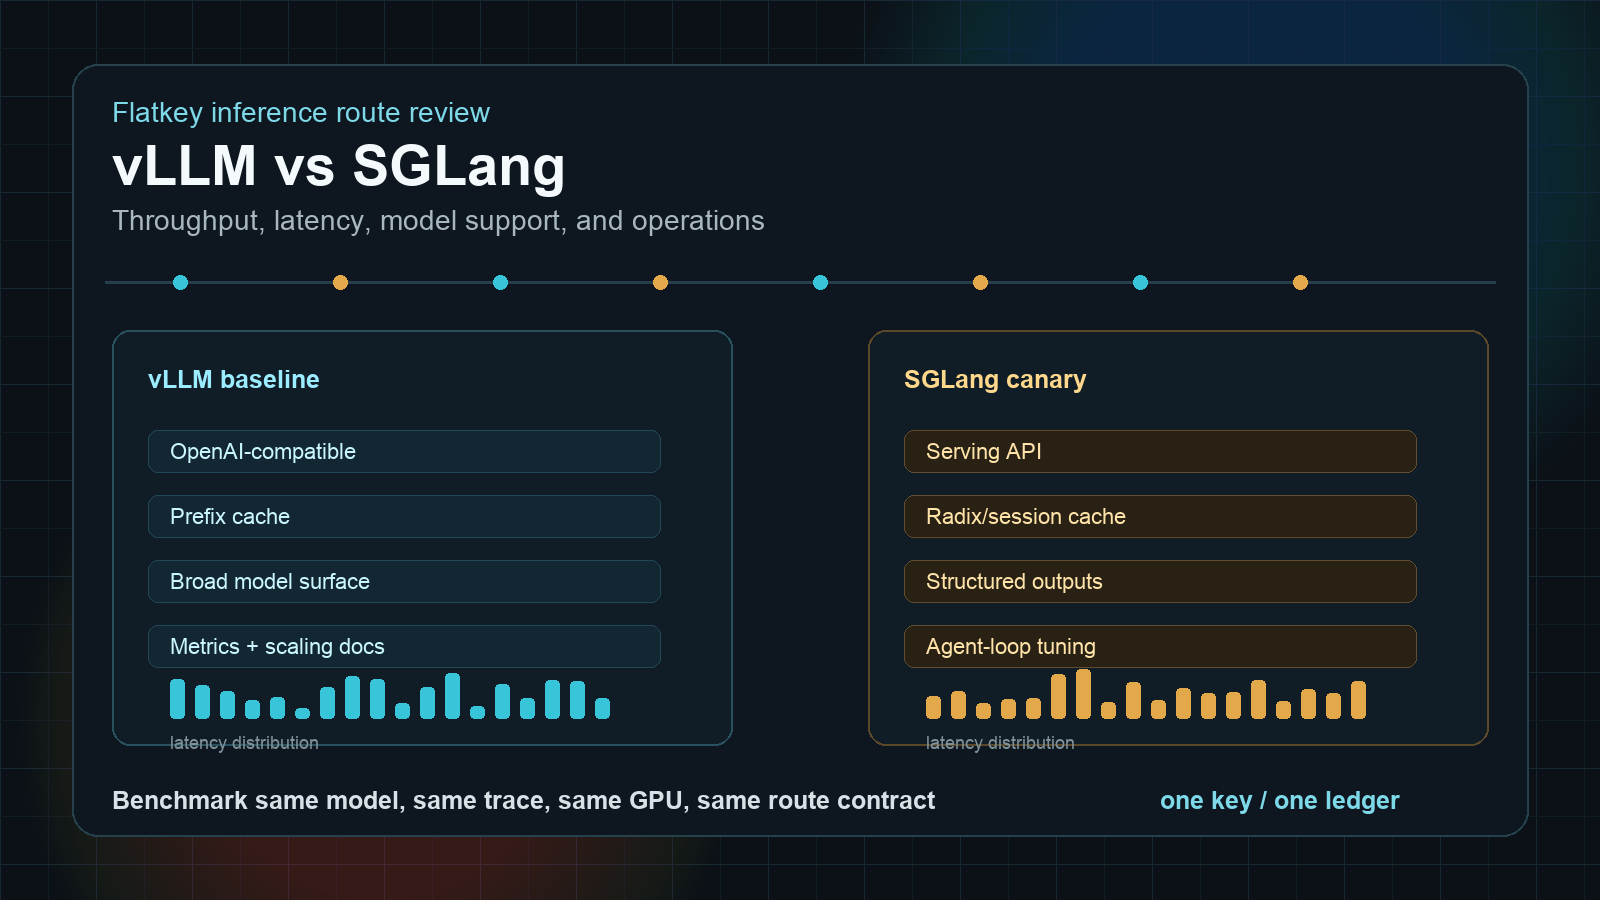
vLLM vs SGLang: Throughput, Latency, Model Support e Operações
Compare SGLang vs vLLM para inferência em GPU na nuvem: throughput, latência, suporte a modelos, operações, benchmarks e quando o Ollama se encaixa em testes locais.
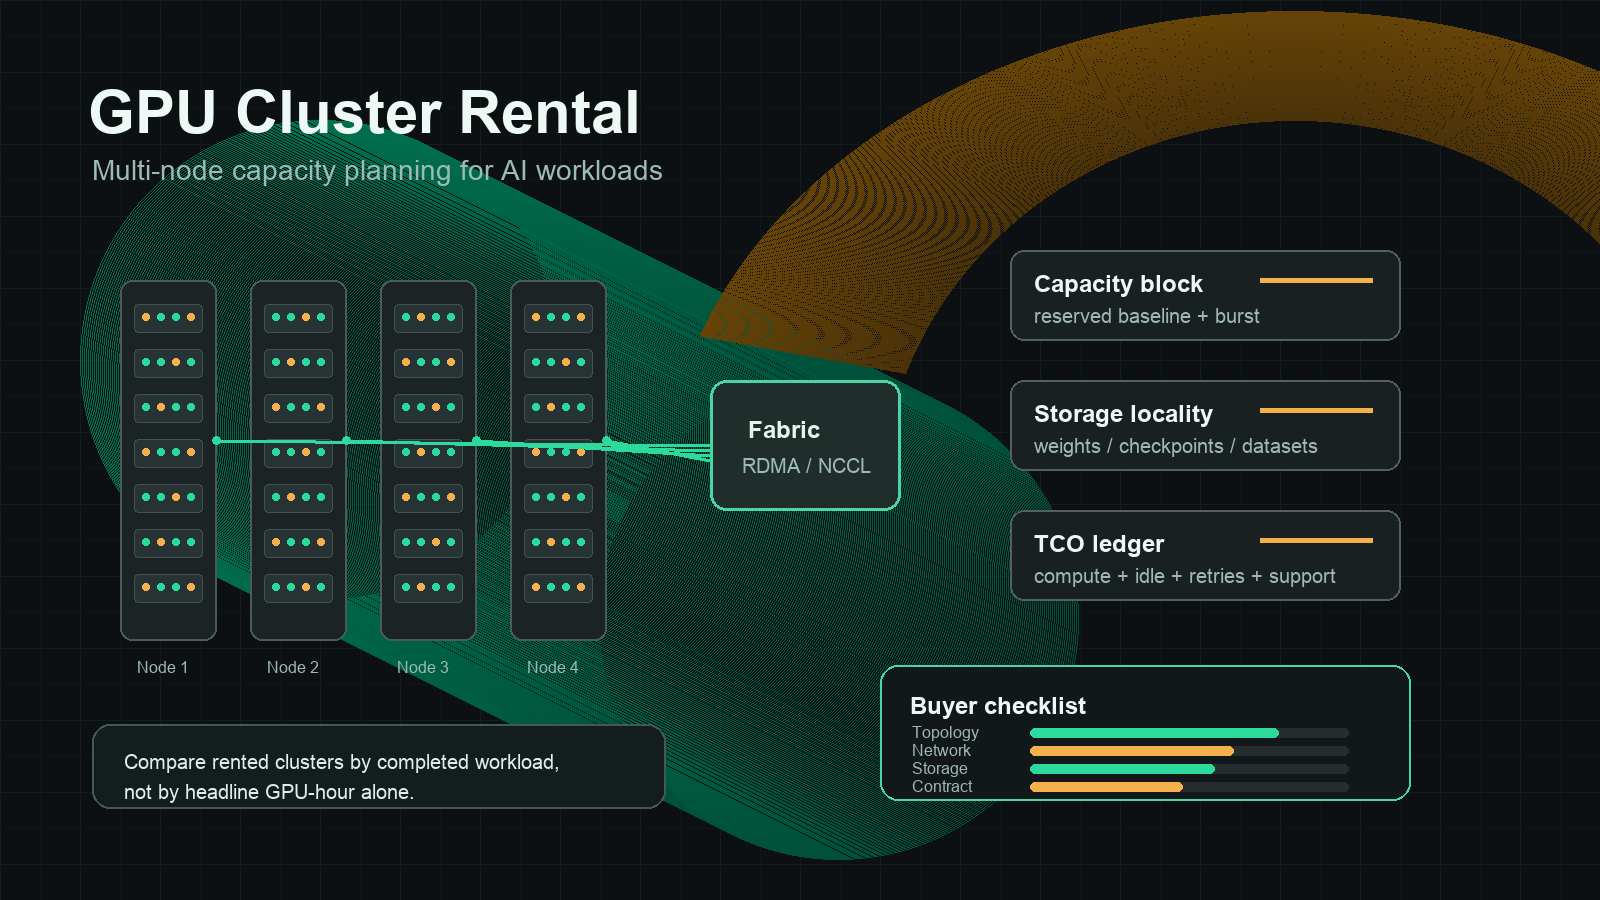
Aluguel de Cluster de GPU: Um Guia do Comprador para Capacidade de IA Multi-Nó
Um guia do comprador para equipes corporativas de IA que avaliam aluguel de cluster de GPU multi-nó, provedores de nuvem, capacidade reservada, rede, armazenamento e TCO.
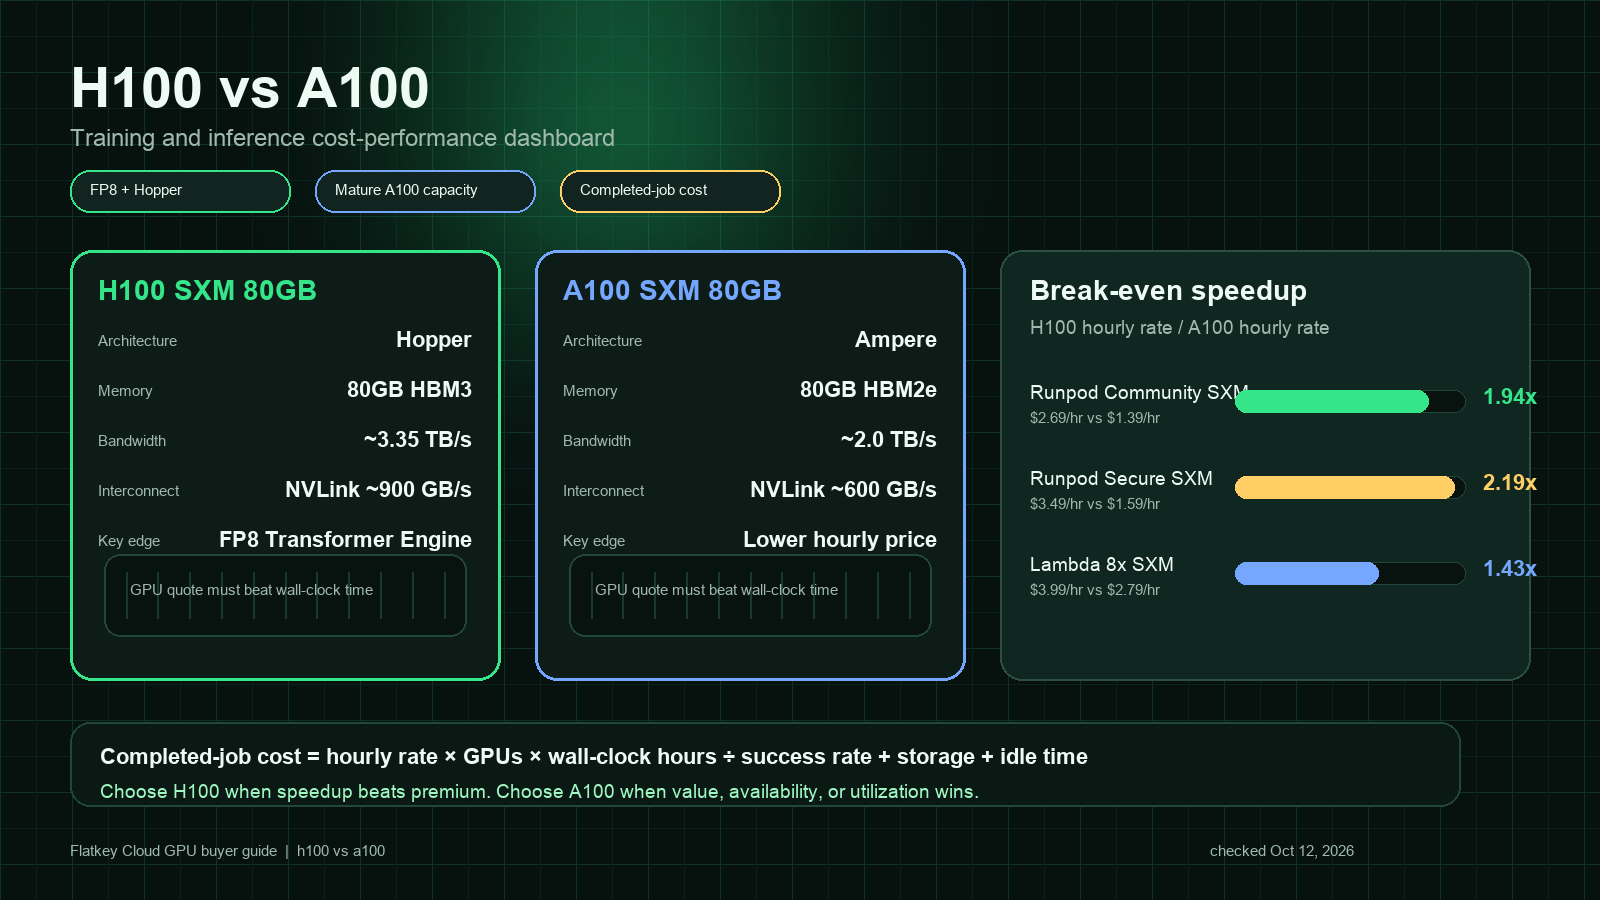
NVIDIA H100 vs A100: Custo-benefício em treinamento e inferência
Uma comparação prática entre H100 e A100 para equipes de IA que decidem entre o desempenho do Hopper e o valor do Ampere em treinamento, inferência e aluguel de GPUs na nuvem.

H200 vs H100 (2026): especificações, desempenho real, preço por hora e qual alugar
NVIDIA H200 vs H100 em 2026: especificações oficiais, a importância de 141GB para inferência de modelos de 70B, preços reais por hora da Flatkey Compute, RunPod e Lambda, alternativas Blackwell e a escolha por carga de trabalho.
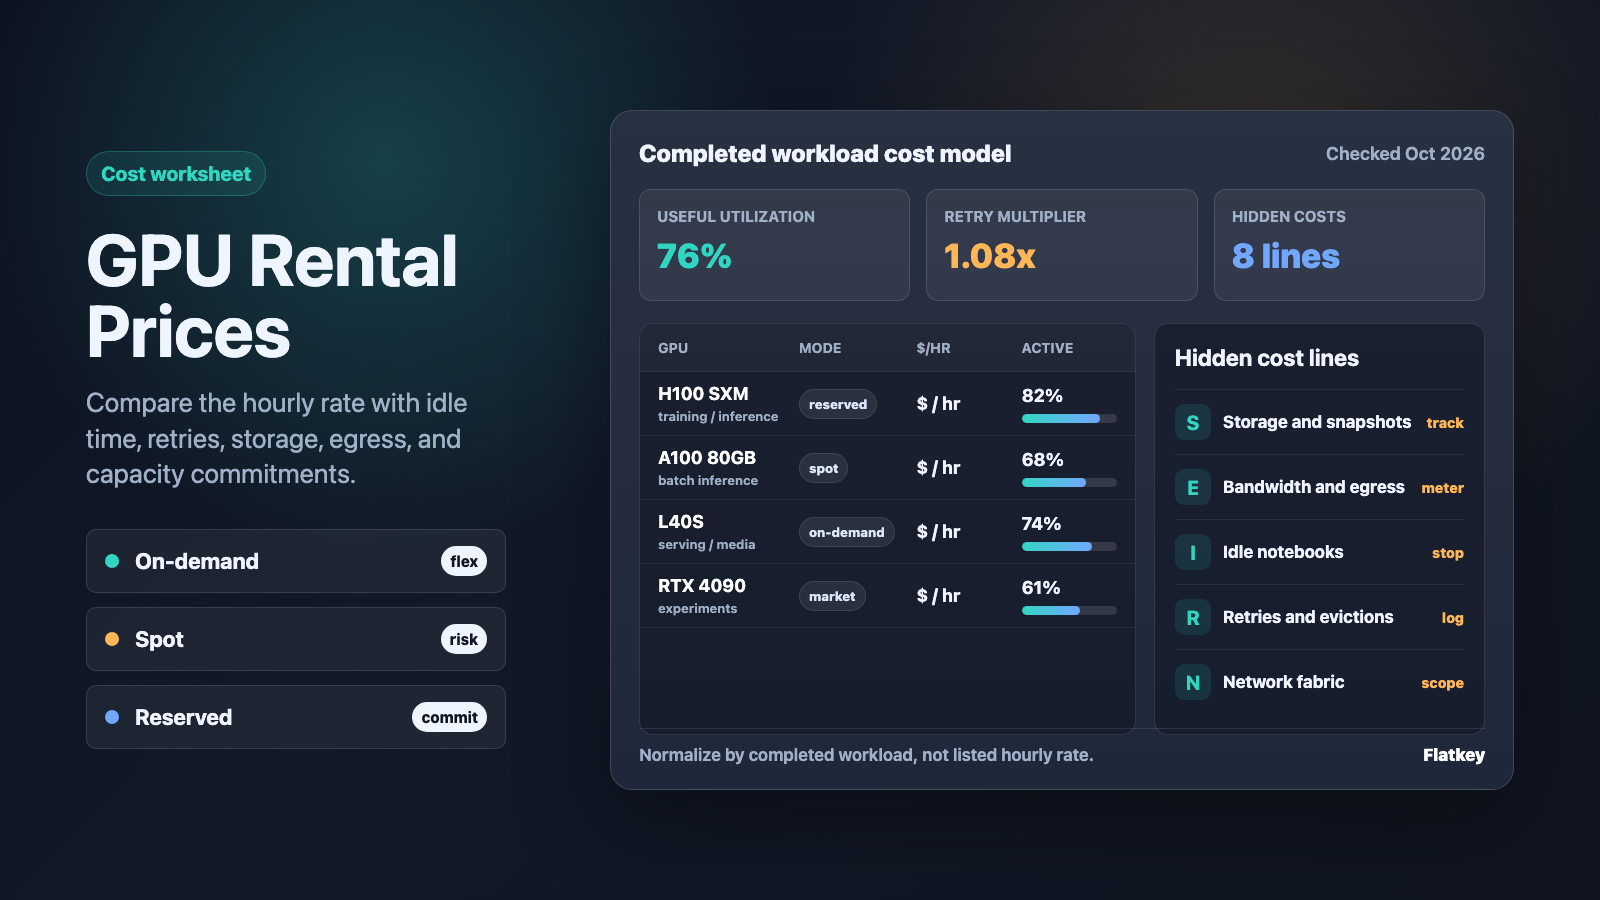
Preços de Aluguel de GPU Explicados: On-Demand, Spot, Reserved e Custos Ocultos
Um guia prático para comparar preços de aluguel de GPU pelo custo do trabalho concluído, e não apenas pelas taxas horárias, com verificações de fontes para modelos on-demand, spot, reserved, marketplace e de custos ocultos.
Crie mais rápido com um único gateway de IA.
Use a flatkey.ai para gerenciar modelos, chaves, cobrança e observabilidade em uma plataforma de API.
Começar