
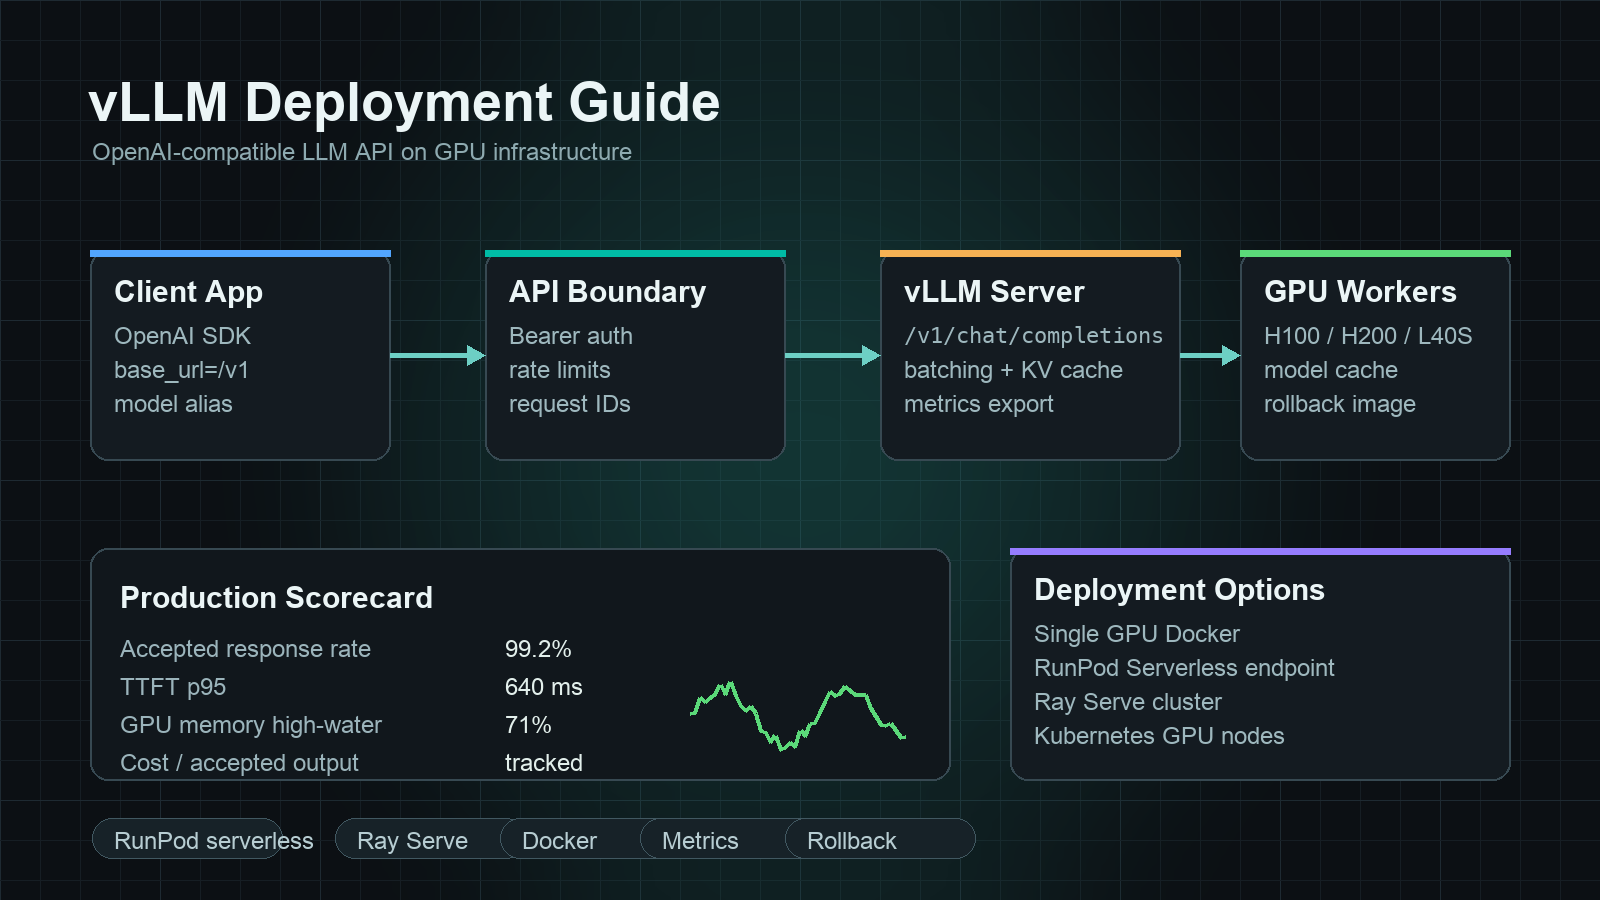
Una guía de despliegue de vLLM debería responder una pregunta práctica: ¿cómo conviertes capacidad de GPU en una API de LLM compatible con OpenAI que los equipos de aplicación puedan llamar, observar, revertir y comparar con APIs de modelos gestionados?
La respuesta corta es empezar con un modelo, una forma de GPU, una ruta compatible con OpenAI y un plan de medición. vLLM puede exponer /v1/models, /v1/chat/completions y otros endpoints relacionados con el estilo de OpenAI, pero un despliegue de producción es más que el primer comando vllm serve. Necesitas una imagen de contenedor, caché del modelo, límite de autenticación, comprobaciones de salud, métricas, límites de solicitudes, una prueba de carga y una tarjeta de puntuación de coste por salida aceptada.
Esta guía de despliegue de vLLM ofrece a los desarrolladores de IA y a los equipos de plataforma una ruta de despliegue desde un único servidor GPU hasta RunPod Serverless, Ray Serve y patrones de producción al estilo Kubernetes. También explica cuándo una API de modelo o un router como Flatkey puede ser más sencillo que hacerse cargo de la capa de serving en GPU.
Guía rápida de despliegue de vLLM
Usa esta secuencia antes de añadir complejidad de orquestación.
| Paso | Decisión | Valor predeterminado práctico |
|---|---|---|
| 1. Elige el modelo | Elige un modelo compatible y una revisión exacta | Empieza con el modelo más pequeño que pruebe el contrato de la API y luego escala |
| 2. Elige la GPU | Confirma el ajuste de memoria antes de optimizar el rendimiento | Usa la misma clase de GPU en pruebas y producción |
| 3. Inicia vLLM | Expón una API compatible con OpenAI | Usa primero vllm serve y luego contenedízalo |
| 4. Bloquea los límites de solicitud | Delimita la longitud del contexto, la concurrencia y el tamaño de salida | Protege la GPU de prompts sin límite |
| 5. Añade autenticación y controles de red | No expongas directamente un worker GPU en bruto | Pon delante una pasarela, un ingress o un endpoint privado |
| 6. Mide la salida aceptada | Controla respuestas exitosas, latencia, reintentos y coste | Compara con el coste por salida aceptada de la API del modelo |
| 7. Añade mecanismos de despliegue gradual | Canary, rollback y alias de modelo versionados | Mantén estable el código cliente mientras cambian los servicios |
El objetivo no es que cada carga de trabajo se aloje por sí misma. El objetivo es saber cuándo vLLM autogestionado merece la pena por su superficie operativa.
Qué te ofrece vLLM
vLLM es un motor de inferencia y serving de código abierto para modelos de lenguaje grandes. Su documentación cubre serving compatible con OpenAI, despliegue con Docker, métricas, caché de prefijos, cuantización, decodificación especulativa, paralelismo y arquitecturas de modelos compatibles. Esas piezas hacen de vLLM un valor predeterminado sólido cuando quieres servir modelos de pesos abiertos detrás de un contrato de API familiar.
La propiedad útil en producción es el límite de la API. Si tu aplicación ya llama a un cliente compatible con OpenAI, un endpoint de vLLM puede reducir el trabajo de reescritura de la aplicación. La capa de serving puede cambiar, los pesos del modelo pueden cambiar y el host GPU puede moverse, mientras el código cliente sigue enviando solicitudes de chat completion a una única URL base.
Eso no elimina el trabajo de plataforma. Traslada el trabajo duro desde la integración de aplicaciones a las operaciones de inferencia: asignación de GPU, carga de modelos, batching, observabilidad, límites de tasa, respuesta a incidentes y gestión de costes.
Despliegue de vLLM en una sola GPU
Empieza localmente o en una GPU de la nube antes de añadir serverless, Ray o Kubernetes.
pip install vllm

vllm serve meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000
Luego prueba el endpoint compatible con OpenAI.
curl http://localhost:8000/v1/models
Usa una solicitud de chat que se parezca a la solicitud que realmente enviará tu aplicación.
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-8B-Instruct",
    "messages": [
      {"role": "user", "content": "Write a three-bullet deployment checklist."}
    ],
    "temperature": 0.2,
    "max_tokens": 300
  }'
Este primer despliegue no es producción. Responde a cuatro preguntas:
- ¿Se carga el modelo en la GPU seleccionada?
- ¿Tu cliente entiende la forma de la respuesta?
- ¿Funcionan el streaming, la llamada a herramientas o la salida estructurada para tu solicitud específica?
- ¿Cuáles son las cifras aproximadas de tiempo hasta el primer token y la latencia de extremo a extremo?
Mantén la primera prueba sencilla. No ajustes el batching, la cuantización ni el paralelismo hasta que el endpoint base funcione.
Despliegue con Docker para un servidor GPU reproducible
Para un servidor reproducible, usa la ruta oficial de Docker de vLLM o una imagen de contenedor fijada en tu propio registro. Los controles de producción importantes no son solo la etiqueta de la imagen. También son la pila de controladores, la compatibilidad con CUDA, la caché del modelo, el montaje de volumen, el puerto de red y los flags del proceso.
Forma de ejemplo:
docker run --gpus all \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  --env HUGGING_FACE_HUB_TOKEN=$HUGGING_FACE_HUB_TOKEN \
  vllm/vllm-openai:latest \
  --model meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000
Antes de usar este patrón en producción, fija versiones:
- Etiqueta de la imagen de vLLM.
- Controlador NVIDIA y runtime de contenedores.
- Pila CUDA, si se gestiona por separado.
- Revisión del modelo o hash de commit.
- Comportamiento del tokenizer y de la plantilla de chat.
- Modo de cuantización, si se usa.
Una guía de despliegue de vLLM está incompleta si solo dice "ejecuta Docker". El runbook también necesita comportamiento de reinicio, registros, calentamiento de la caché del modelo, sondas de disponibilidad y una ruta de reversión a la imagen y revisión del modelo anteriores.
Haz que el endpoint sea compatible con OpenAI, pero no sin autenticación
vLLM puede hablar una API compatible con OpenAI, pero tu worker vLLM sin procesar normalmente no debería ser el límite público de Internet. Pon algo delante de él:
- Un endpoint privado de VPC para servicios internos.
- Un gateway de API con validación de token bearer.
- Una malla de servicios o controlador de entrada con mTLS.
- Un proxy ligero a nivel de aplicación que aplique alias de modelo, IDs de solicitud y presupuestos por equipo.
- Una capa de enrutador cuando necesites fallback a APIs de modelos gestionadas.
Usa URLs base específicas por entorno:
VLLM_BASE_URL_DEV=http://localhost:8000/v1
VLLM_BASE_URL_STAGING=https://staging-inference.example.com/v1
VLLM_BASE_URL_PROD=https://inference.example.com/v1
Luego mantén reversible el cliente de la aplicación:
from openai import OpenAI

client = OpenAI(
    api_key="not-used-by-raw-vllm",
    base_url="https://inference.example.com/v1",
)

response = client.chat.completions.create(
    model="llama-3-1-8b-instruct",
    messages=[{"role": "user", "content": "Resume el plan de despliegue."}],
)
Si más adelante enrutas algunas solicitudes a la capa de API de modelos compatible con OpenAI de Flatkey, el mismo patrón de cliente sigue siendo útil: cambia la URL base, la clave de API y el alias del modelo mientras mantienes estable el contrato de la aplicación.
Ajustes de producción que decidir antes del tráfico
Las banderas de despliegue dependen del modelo, la GPU y la carga de trabajo, pero todos los equipos deberían decidir estos controles antes del tráfico de producción:
| Control | Por qué importa |
|---|---|
| Longitud máxima del modelo | Evita que unos pocos prompts largos consuman toda la memoria de la KV-cache |
| Número máximo de tokens de salida | Evita que generaciones descontroladas acaparen la capacidad de decodificación |
| Límite de concurrencia | Protege la latencia p95 y p99 durante picos de tráfico |
| Tiempo de espera de la solicitud | Evita que las solicitudes atascadas oculten la sobrecarga |
| Política de cola | Decide si la demanda excedente espera, falla rápido o hace fallback |
| Alias del modelo | Permite a los clientes usar un nombre estable mientras cambia la revisión servida |
| Barrera de autenticación | Evita que un endpoint GPU costoso se convierta en un proxy abierto |
| Política de registros | Equilibra la depuración con la retención de datos y los requisitos de privacidad |
| Exportación de métricas | Hace observables la latencia, los errores, el comportamiento de la caché y el rendimiento |
No copies las banderas de otro equipo. Copia su método de medición.
Métricas para despliegues de producción de vLLM
Haz seguimiento de las métricas en tres capas.
| Capa | Métricas a seguir |
|---|---|
| Capa de API | Conteo de solicitudes, tasa de respuestas aceptadas, tasa de 4xx/5xx, tasa de timeouts, tasa de reintentos |
| Capa de servicio | Tiempo hasta el primer token, latencia entre tokens, latencia de extremo a extremo, espera en cola, tokens por segundo |
| Capa de GPU | Utilización de GPU, utilización de memoria, eventos de OOM, tiempo de carga del modelo, recuento de reinicios |
Luego añade la métrica financiera:
coste por salida aceptada =
  (alquiler de GPU + almacenamiento + ancho de banda + reintentos + tiempo del operador)
  / respuestas aceptadas que pasan los controles de calidad
Esto mantiene la guía de despliegue de vLLM vinculada a la economía de producción. Un endpoint más rápido no es más barato si falla con más frecuencia, necesita más intervención manual o permanece inactivo la mayor parte del día.
Para un contexto de costes más amplio, compara tu endpoint medido con precios de alquiler de GPU, la mejor GPU para inferencia de LLM, nube de GPU vs API de modelo y TCO de clúster GPU.
Guía de despliegue serverless de vLLM en RunPod
Una guía de despliegue serverless de vLLM en RunPod tiene un modelo operativo distinto al de una VM GPU de larga ejecución. Empaquetas un handler o contenedor, defines el endpoint serverless y dejas que la plataforma escale workers en torno a las solicitudes. Esto puede ser útil cuando el tráfico es irregular o cuando quieres una superficie de ejecución GPU gestionada sin encargarte de cada detalle del ciclo de vida de la VM.
Usa RunPod Serverless cuando:
- Quieres ejecución GPU estilo endpoint sin gestionar hosts persistentes.
- El tráfico es lo bastante irregular como para que la capacidad GPU siempre activa quede ociosa.
- El comportamiento de arranque en frío y de carga del modelo es aceptable para la carga de trabajo.
- Tu app puede tolerar el patrón de solicitud asíncrono o específico del endpoint de la plataforma.
- Puedes probar la concurrencia, la cola y el comportamiento del timeout antes del lanzamiento.
Ten cuidado con serverless para chat sensible a la latencia. Los modelos grandes pueden tener un comportamiento material de arranque en frío y de tiempo de carga. Mide la latencia hasta el primer token después de períodos de inactividad, no solo durante una prueba comparativa en caliente.
Para una guía de despliegue de vLLM en un endpoint serverless de RunPod, tu prueba de aceptación debería incluir:
| Check | Por qué importa |
|---|---|
| Tiempo de descarga de la imagen del contenedor | Las imágenes grandes pueden dominar los arranques en frío |
| Descarga de los pesos del modelo o montaje de volumen | Las descargas repetidas pueden borrar los ahorros del serverless |
| Número máximo de workers | Evita gastos inesperados durante picos |
| Tiempo de espera de la cola | Define el comportamiento de fallos visible para el usuario |
| Política de workers en caliente | Cambia la latencia y el coste en reposo |
| Forma de la solicitud y la respuesta | Confirma que los clientes compatibles con OpenAI se pueden adaptar limpiamente |
Si tu consulta de búsqueda exacta es runpod serverless endpoints vllm deployment guide, trata "endpoints" como un tema de operaciones: construye el endpoint, pero también prueba los arranques en frío, el escalado de workers, los límites de solicitudes y la reversión.
Guía de despliegue de Ray Serve vLLM
Una guía de despliegue de Ray Serve vLLM es útil cuando el despliegue ya no es solo un modelo en un worker. Ray Serve puede ayudar a los equipos a construir una aplicación de serving que componga despliegues, escale réplicas y se ejecute en un clúster de Ray. Eso es valioso cuando necesitas lógica de serving a nivel de Python alrededor del modelo, enrutamiento personalizado, aplicaciones multmodelo o un clúster que ya estandariza en Ray.
Usa Ray Serve cuando:
- Ya ejecutas Ray para infraestructura de ML.
- Necesitas múltiples despliegues en un solo grafo de serving.
- Quieres enrutamiento a nivel de aplicación alrededor de uno o más motores vLLM.
- Necesitas un camino desde pruebas locales hasta un clúster de Ray.
- Tu equipo de plataforma puede operar Ray, no solo vLLM.
La contrapartida es la superficie operativa. Ray aporta poder de orquestación, pero también añade operaciones del clúster de Ray, comportamiento de autoescalado, consideraciones del almacén de objetos, registros, paneles y otra ruta de actualización. Para un solo modelo detrás de un endpoint, un despliegue directo de vLLM puede ser más simple.
Patrón de despliegue en Kubernetes
Kubernetes encaja bien cuando tu organización ya opera nodos GPU, ingress, secretos, métricas y políticas de despliegue en Kubernetes. No es automáticamente el primer despliegue correcto para un equipo pequeño.
La lista de verificación de Kubernetes:
| Área | Lista de verificación |
|---|---|
| Programación de GPU | Etiquetas de nodos, taints, solicitudes de recursos, plugin de dispositivo y aislamiento de GPU |
| Almacenamiento del modelo | Volumen persistente, sincronización con almacén de objetos o estrategia de imagen integrada |
| Arranque | Calentamiento de la caché del modelo y sonda de readiness realista |
| Salud | Sonda de liveness que no mate cargas de modelo lentas pero saludables |
| Despliegue | Despliegue canary o blue-green con reversión rápida |
| Autoescalado | Escala según cola, latencia o métricas de GPU, no solo CPU |
| Redes | Solo interno por defecto; ingress público solo mediante controles de autenticación |
| Observabilidad | Latencia por ruta, tasa de error, memoria de GPU y atribución de costes |
Si tu plataforma todavía no tiene madurez de Kubernetes con GPU, empieza primero con un host GPU o un endpoint gestionado. Kubernetes debería reducir el riesgo operativo, no convertir un endpoint simple en un proyecto de clúster.
Plan de prueba de carga para un despliegue de vLLM
No hagas pruebas de carga con un solo prompt. Crea un conjunto de solicitudes representativo.
Usa al menos tres trazas:
- Chat corto: prompt corto, salida corta, alta concurrencia.
- RAG de contexto largo: prompt largo, salida media, plantilla repetida de sistema y recuperación.
- Bucle de agente o herramienta: esquema repetido, salida estructurada, cancelación, reintentos y contexto de múltiples turnos.
Registra:
| Métrica | Objetivo |
|---|---|
| Solicitudes aceptadas por minuto | Mide el rendimiento útil |
| Tiempo hasta el primer token p50/p95/p99 | Muestra la latencia interactiva |
| Latencia de extremo a extremo p50/p95/p99 | Muestra el tiempo de tarea visible para el usuario |
| Tasa de errores y timeouts | Muestra la fiabilidad bajo carga |
| Latencia ajustada por reintentos | Muestra la experiencia real tras fallos |
| Marca máxima de memoria de GPU | Muestra el margen |
| Coste por salida aceptada | Muestra la economía |
Ejecuta dos benchmarks:
- Ejecución por defecto: ajuste mínimo, para saber el tiempo hasta producción.
- Ejecución ajustada: batching, caché, cuantización y límites de solicitud ajustados, para saber el techo.
Si la ejecución ajustada es más rápida pero frágil, no la despliegues como predeterminada. Despliega la configuración que tu equipo de guardia pueda explicar.
Cuándo no desplegar vLLM por tu cuenta
El autoalojamiento es valioso cuando necesitas control del hardware, pesos personalizados, localización estricta de los datos o una utilización sostenida alta en una carga de trabajo estable. Es menos atractivo cuando el tráfico es incierto, la elección del modelo cambia con frecuencia, se requieren modelos propietarios de vanguardia o el equipo carece de capacidad operativa para inferencia.
Elige primero una API de modelo gestionada o un router cuando:
- Aún estás probando la calidad del modelo.
- Necesitas intercambios frecuentes de modelo.
- El tráfico es irregular o difícil de prever.
- La conmutación por error entre proveedores importa más que el control de la GPU.
- Necesitas un registro de uso, presupuestos, facturas y gobernanza del equipo antes del ajuste de GPU.
Flatkey encaja en esta capa cuando las cargas de trabajo del lado de la API necesitan una sola clave, un solo saldo, una sola factura, registros de uso y acceso a rutas oficiales de modelos. Si más adelante una carga de trabajo demuestra ser lo bastante estable para servirla en GPUs dedicadas, sigue comparando el endpoint de vLLM autogestionado con comparación de precios de modelos de IA, comparación de precios de API de IA y tu coste medido de GPU por salida aceptada.
Plantilla de runbook de despliegue
Copia esto antes del lanzamiento.
Servicio:
  Responsable:
  En guardia:
  Alias del modelo:
  Revisión del modelo servido:
  Versión de vLLM:
  Imagen del contenedor:
  Tipo y cantidad de GPU:
  URL base:

Política de solicitudes:
  Longitud máxima del modelo:
  Máximo de tokens de salida:
  Máxima concurrencia:
  Tiempo de espera de la cola:
  Tiempo de espera de la solicitud:
  Método de autenticación:

Observabilidad:
  Panel de métricas:
  Ubicación de los registros:
  Campo de ID de traza/solicitud:
  Umbrales de alerta:

Despliegue:
  Porcentaje canary:
  Imagen de rollback:
  Revisión del modelo de rollback:
  Ruta de respaldo:

Coste:
  Fuente del coste de GPU:
  Suposiciones de almacenamiento/ancho de banda:
  Denominador de salida aceptada:
  Responsable de la revisión semanal de costes:
Esta plantilla importa más que un primer comando perfecto. Una guía de despliegue de vLLM que no se pueda entregar a la guardia sigue siendo un prototipo.
Preguntas frecuentes
¿Sigue siendo contenido de guía de despliegue de vLLM si uso un endpoint de GPU gestionado?
Sí. Si vLLM es el motor de servicio y estás decidiendo cómo exponerlo, escalarlo, observarlo y protegerlo, sigue perteneciendo a una guía de despliegue de vLLM. Los detalles operativos difieren entre una VM en bruto, RunPod Serverless, Ray Serve y Kubernetes, pero las pruebas de aceptación son similares: contrato del endpoint, latencia, errores, concurrencia, rollback y coste por salida aceptada.
¿Debería usar RunPod Serverless o una VM de GPU persistente para vLLM?
Usa RunPod Serverless cuando el manejo de picos y las operaciones de endpoint gestionado importen más que la latencia siempre caliente. Usa una VM de GPU persistente cuando necesites un rendimiento cálido predecible, control directo del host o una ruta de depuración más simple. Compara ambas si la latencia y la utilización impulsan la decisión.
¿Cuándo tiene sentido Ray Serve con vLLM?
Ray Serve tiene sentido cuando vLLM forma parte de una aplicación de servicio más grande, especialmente si ya operas Ray. Para un solo modelo detrás de un solo endpoint, servir vLLM directamente puede ser más fácil de ejecutar.
¿Puede vLLM reemplazar la API de OpenAI?
vLLM puede exponer una interfaz compatible con OpenAI para modelos autogestionados compatibles, pero no hace que los modelos de pesos abiertos sean idénticos a las APIs propietarias de frontera. Trátalo como un contrato de endpoint y una opción de servicio, y luego valida la calidad del modelo, la latencia y el coste operativo frente a tu carga de trabajo.
¿Qué debería medir primero?
Mide la tasa de respuestas aceptadas, el tiempo hasta el primer token, la latencia p95 y p99, la tasa de timeouts, la presión de memoria de la GPU y el coste por salida aceptada. Los tokens brutos por segundo son útiles, pero no son suficientes para decisiones de producción.
¿Dónde encaja Flatkey con vLLM?
Usa vLLM cuando necesites encargarte de la capa de servicio en GPU. Usa Flatkey cuando quieras una capa de API de modelo compatible con OpenAI, facturación unificada, registros de uso y gobernanza sobre rutas y herramientas oficiales de modelos. Muchos equipos usarán ambos: vLLM para cargas de trabajo autogestionadas estables y Flatkey para modelos de frontera, respaldo, experimentos y gobernanza del lado de la API.
Lista de verificación final
Antes del lanzamiento, tu guía de despliegue de vLLM debería producir estos artefactos:
- Una revisión del modelo y una versión del contenedor fijadas.
- Una URL base compatible con OpenAI y probada.
- Un límite de autenticación y red.
- Límites de solicitud para contexto, salida, tiempo de espera y concurrencia.
- Métricas de latencia, errores, encolamiento, rendimiento y memoria de la GPU.
- Una ruta de rollback y la imagen anterior conocida como buena.
- Una hoja de cálculo de coste por salida aceptada.
- Un registro de decisión que explique por qué vLLM autogestionado supera a una API de modelo gestionada para esta carga de trabajo.
Si esos artefactos existen, no solo estás ejecutando vLLM. Estás operando una API de LLM en GPUs.
Fuentes oficiales que conviene tener abiertas
- documentación del servidor compatible con OpenAI de vLLM
- documentación de despliegue con Docker de vLLM
- documentación de métricas de producción de vLLM
- documentación de Ray Serve LLM
- documentación de endpoints de RunPod Serverless
- documentación de NVIDIA Container Toolkit
- Flatkey Compute
- precios de Flatkey


