
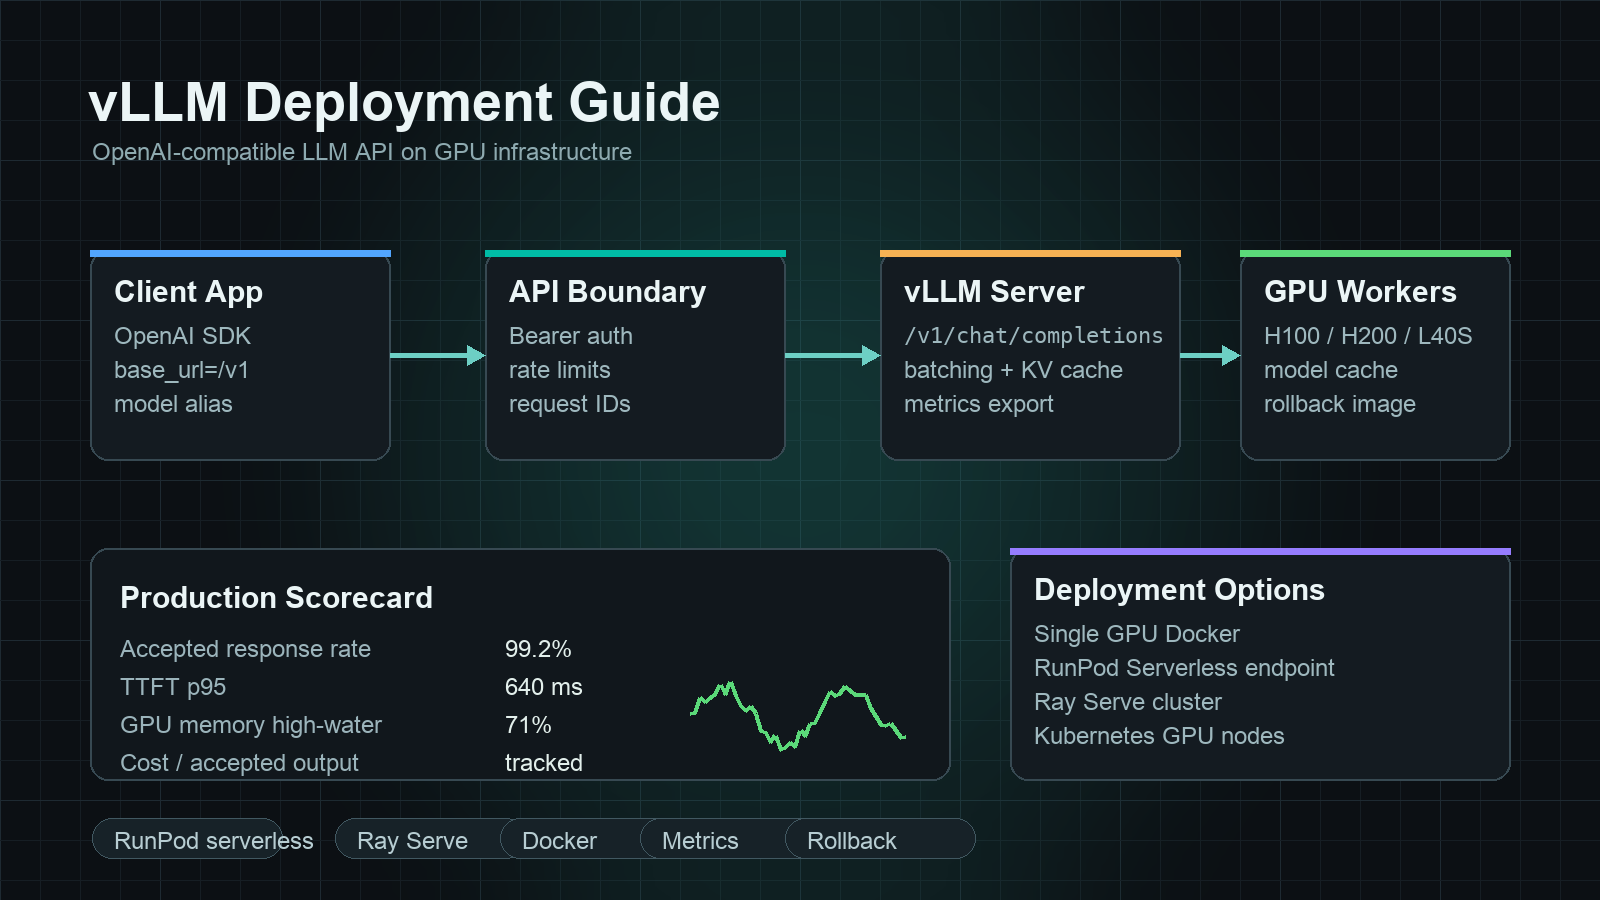
vLLM デプロイメントガイドが答えるべき実践的な प्रश्नは1つです。GPU容量を、アプリケーションチームが呼び出し、監視し、ロールバックでき、マネージドなモデルAPIと比較できるOpenAI互換LLM APIにどう変えるか、ということです。
短い答えは、1つのモデル、1つのGPU構成、1つのOpenAI互換ルート、そして1つの測定計画から始めることです。vLLMは /v1/models、/v1/chat/completions、および関連するOpenAIスタイルのエンドポイントを提供できますが、本番デプロイは最初の vllm serve コマンドだけではありません。コンテナイメージ、モデルキャッシュ、認証境界、ヘルスチェック、メトリクス、リクエスト制限、負荷テスト、そして承認済み出力あたりのコストスコアカードが必要です。
このvLLM デプロイメントガイドでは、AI開発者とプラットフォームチーム向けに、単一GPUサーバーから RunPod Serverless、Ray Serve、Kubernetesスタイルの本番パターンまでのデプロイ経路を示します。また、GPUサービング層を自前で持つよりも、Flatkey のようなモデルAPIやルーターのほうが簡単な場合についても説明します。
vLLM デプロイメントガイドのクイック版
オーケストレーションの複雑さを追加する前に、この手順を使ってください。
| ステップ | 判断 | 実用上のデフォルト |
|---|---|---|
| 1. モデルを選ぶ | サポートされている1つのモデルと正確なリビジョンを選択する | API契約を証明できる最小のモデルから始め、そこから拡大する |
| 2. GPUを選ぶ | スループット調整の前にメモリに収まることを確認する | テストと本番で同じGPUクラスを使う |
| 3. vLLMを起動する | OpenAI互換APIを公開する | まず vllm serve を使い、その後コンテナ化する |
| 4. リクエスト制限を固定する | コンテキスト長、同時実行数、出力サイズに上限を設ける | 無制限のプロンプトからGPUを守る |
| 5. 認証とネットワーク制御を追加する | 生のGPUワーカーを直接公開しない | その前段にゲートウェイ、Ingress、またはプライベートエンドポイントを置く |
| 6. 承認済み出力を計測する | 成功レスポンス、レイテンシ、リトライ、コストを追跡する | モデルAPIの承認済み出力あたりコストと比較する |
| 7. ロールアウト機構を追加する | カナリア、ロールバック、バージョン付きモデルエイリアス | 提供内容を変更しながらクライアントコードは安定させる |
目的は、すべてのワークロードをセルフホストにすることではありません。目的は、セルフホストの vLLM が運用面の負担に見合うのはいつかを把握することです。
vLLM が提供するもの
vLLM は、大規模言語モデル向けのオープンソース推論・サービングエンジンです。ドキュメントでは、OpenAI互換サービング、Dockerデプロイ、メトリクス、プレフィックスキャッシュ、量子化、推測デコード、並列処理、対応モデルアーキテクチャが扱われています。これらの要素により、慣れ親しんだAPI契約の背後でオープンウェイトモデルを提供したい場合、vLLM は有力なデフォルトになります。
本番で有用なのはAPI境界です。アプリケーションがすでに OpenAI互換クライアントを呼び出しているなら、vLLM エンドポイントはアプリケーション改修の手間を減らせます。サービング層、モデル重み、GPUホストが変わっても、クライアントコードは1つのベースURLにチャット完了リクエストを送り続けられます。
ただし、これでプラットフォーム作業がなくなるわけではありません。難しい作業がアプリ統合から推論運用へ移るだけです。GPU割り当て、モデル読み込み、バッチ処理、可観測性、レート制限、障害対応、コスト管理が必要になります。
単一GPUの vLLM デプロイメント
サーバーレス、Ray、Kubernetes を追加する前に、ローカルまたは1台のクラウドGPUで始めてください。
pip install vllm

vllm serve meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000
次に、OpenAI互換エンドポイントをテストします。
curl http://localhost:8000/v1/models
アプリケーションが実際に送るリクエストに似たチャットリクエストを使ってください。
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-8B-Instruct",
    "messages": [
      {"role": "user", "content": "3つの箇条書きのデプロイチェックリストを書いてください。"}
    ],
    "temperature": 0.2,
    "max_tokens": 300
  }'
この最初のデプロイは本番ではありません。次の4点に答えます。
- 選択したGPUでモデルは読み込めるか?
- クライアントはレスポンス形式を理解できるか?
- ストリーミング、ツール呼び出し、構造化出力は、特定のリクエストで動作するか?
- 初回トークンまでの時間とエンドツーエンドのレイテンシのおおよその数値はどれくらいか?
最初のテストは地味なままにしてください。ベースエンドポイントが動くまで、バッチ処理、量子化、並列化を調整しないでください。
再現可能なGPUサーバー向けの Docker デプロイメント
再現可能なサーバーには、公式の vLLM Docker パス、または自社レジストリ内の固定済みコンテナイメージを使います。重要な本番制御はイメージタグだけではありません。ドライバスタック、CUDA互換性、モデルキャッシュ、ボリュームマウント、ネットワークポート、プロセスフラグも重要です。
例:
docker run --gpus all \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  --env HUGGING_FACE_HUB_TOKEN=$HUGGING_FACE_HUB_TOKEN \
  vllm/vllm-openai:latest \
  --model meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000
このパターンを本番で使う前に、次のバージョンを固定してください。
- vLLM のイメージタグ。
- NVIDIA ドライバとコンテナランタイム。
- 別管理の場合は CUDA スタック。
- モデルのリビジョンまたはコミットハッシュ。
- トークナイザーとチャットテンプレートの挙動。
- 使用する場合は量子化モード。
vLLM デプロイメントガイドは、単に「Docker を実行する」と書くだけでは不十分です。運用手順書には、再起動時の挙動、ログ、モデルキャッシュのウォームアップ、readiness プローブ、そして前のイメージとモデルリビジョンへ戻すロールバック手順も必要です。
エンドポイントをOpenAI互換にするが、認証なしにはしない
vLLM は OpenAI 互換 API を話せますが、素の vLLM ワーカーをそのままパブリックインターネットの境界に置くべきでは通常ありません。前段に何かを置きます:
- 社内サービス向けのプライベート VPC エンドポイント。
- Bearer トークン検証付きの API ゲートウェイ。
- mTLS を備えたサービスメッシュまたは ingress コントローラー。
- モデルエイリアス、リクエスト ID、チームごとの予算を強制する薄いアプリ層プロキシ。
- マネージドなモデル API へのフォールバックが必要な場合のルーター層。
環境ごとのベース URL を使います:
VLLM_BASE_URL_DEV=http://localhost:8000/v1
VLLM_BASE_URL_STAGING=https://staging-inference.example.com/v1
VLLM_BASE_URL_PROD=https://inference.example.com/v1
次に、アプリケーションのクライアントを可逆に保ちます:
from openai import OpenAI

client = OpenAI(
    api_key="not-used-by-raw-vllm",
    base_url="https://inference.example.com/v1",
)

response = client.chat.completions.create(
    model="llama-3-1-8b-instruct",
    messages=[{"role": "user", "content": "Summarize the deployment plan."}],
)
後で一部のリクエストを Flatkey の OpenAI 互換モデル API レイヤーにルーティングするようになっても、同じクライアントパターンは引き続き有効です。アプリケーションの契約を安定させたまま、ベース URL、API キー、モデルエイリアスを変更できます。
トラフィック投入前に決めるべき本番設定
デプロイメントフラグはモデル、GPU、ワークロードによって異なりますが、どのチームも本番トラフィックの前に次の制御項目を決めるべきです:
| 制御項目 | 重要な理由 |
|---|---|
| 最大モデル長 | いくつかの長いプロンプトが KV キャッシュメモリをすべて消費するのを防ぐ |
| 最大出力トークン数 | 暴走した生成が decode 容量を占有し続けるのを防ぐ |
| 同時実行数制限 | バースト性のあるトラフィック下で p95 および p99 レイテンシを保護する |
| リクエストタイムアウト | 停止したリクエストが過負荷を隠すのを防ぐ |
| キューポリシー | 過剰需要を待たせるか、即時失敗させるか、フォールバックさせるかを決める |
| モデルエイリアス | 提供中のリビジョンが変わっても、クライアントは安定した名前を使える |
| 認証境界 | 高価な GPU エンドポイントがオープンプロキシになるのを防ぐ |
| ログポリシー | デバッグとデータ保持・プライバシー要件のバランスを取る |
| メトリクス出力 | レイテンシ、エラー、キャッシュ挙動、スループットを可観測にする |
他チームのフラグをそのままコピーしないでください。測定方法をコピーしてください。
vLLM 本番デプロイメントのメトリクス
メトリクスは 3 つの層で追跡します。
| レイヤー | 追跡するメトリクス |
|---|---|
| API レイヤー | リクエスト数、受理された応答率、4xx/5xx 率、タイムアウト率、リトライ率 |
| サービングレイヤー | 最初のトークンまでの時間、トークン間レイテンシ、エンドツーエンドレイテンシ、キュー待ち時間、1 秒あたりトークン数 |
| GPU レイヤー | GPU 使用率、メモリ使用率、OOM イベント、モデルロード時間、再起動回数 |
次に、財務メトリクスを追加します:
cost per accepted output =
  (GPU rental + storage + bandwidth + retries + operator time)
  / accepted responses that pass quality checks
これにより、vLLM デプロイメントガイドが本番の経済性と結びつきます。より速いエンドポイントでも、失敗が多い、手作業の介入が多い、または一日の大半がアイドル状態なら、安いわけではありません。
より広いコストの文脈については、計測したエンドポイントを GPU 賃借価格、LLM 推論に最適な GPU、GPU クラウド vs モデル API、および GPU クラスタ TCO と比較してください。
RunPod serverless vLLM デプロイメントガイド
RunPod serverless vLLM デプロイメントガイドは、長時間稼働する GPU VM とは異なる運用モデルです。ハンドラーまたはコンテナをパッケージ化し、サーバーレスエンドポイントを定義し、プラットフォームにリクエストに応じてワーカーをスケールさせます。これは、トラフィックがスパイク状に増減する場合や、VM のライフサイクル詳細をすべて自分で管理せずにマネージドな GPU 実行基盤が欲しい場合に有用です。
RunPod Serverless を使うのは次のような場合です:
- 永続ホストを管理せずにエンドポイント型の GPU 実行を使いたい。
- トラフィックがバースト的で、常時稼働の GPU 容量だと遊休が多くなる。
- コールドスタートとモデルロードの挙動がワークロードにとって許容範囲である。
- アプリがプラットフォームの非同期またはエンドポイント固有のリクエストパターンに耐えられる。
- 起動前に同時実行、キューイング、タイムアウトの挙動をテストできる。
レイテンシに敏感なチャットではサーバーレスに注意してください。大規模モデルでは、コールドスタートやロード時間の影響が大きくなりえます。ウォームなベンチマーク中だけでなく、アイドル期間後の最初のトークンまでのレイテンシを測定してください。
RunPod serverless endpoint vLLM デプロイメントガイドでは、受け入れテストに次を含めるべきです:
| 確認項目 | 重要な理由 |
|---|---|
| コンテナイメージのプル時間 | 大きなイメージはコールドスタートの大部分を占めることがある |
| モデル重みのダウンロードまたはボリュームマウント | 繰り返しのダウンロードはサーバーレスの節約効果を打ち消す可能性がある |
| 最大ワーカー数 | 急増時の予期しないコスト発生を防ぐ |
| キュータイムアウト | ユーザー向けの失敗時の挙動を定義する |
| ウォームワーカー方針 | レイテンシとアイドルコストが変わる |
| リクエストとレスポンスの形状 | OpenAI互換クライアントをきれいに適応できることを確認する |
もし正確な検索クエリが runpod serverless endpoints vllm deployment guide であるなら、"endpoints" は運用トピックとして扱ってください。つまり、エンドポイントを構築するだけでなく、コールドスタート、ワーカーのスケーリング、リクエスト制限、ロールバックもテストします。
Ray Serve vLLM デプロイメントガイド
Ray Serve vLLM デプロイメントガイド は、デプロイが単に1つのワーカー上の1つのモデルではなくなったときに有用です。Ray Serve は、デプロイメントを組み合わせ、レプリカをスケールし、Ray クラスタ上で動作するサービングアプリケーションの構築を支援できます。これは、モデルの周りに Python レベルのサービングロジックが必要な場合、カスタムルーティング、マルチモデルアプリケーション、またはすでに Ray を標準化しているクラスタがある場合に価値があります。
次のような場合に Ray Serve を使います。
- すでに ML インフラとして Ray を運用している。
- 1つのサービンググラフに複数のデプロイメントが必要。
- 1つまたは複数の vLLM エンジンの周りでアプリケーションレベルのルーティングを行いたい。
- ローカルテストから Ray クラスタへの移行経路が必要。
- プラットフォームチームが vLLM だけでなく Ray も運用できる。
トレードオフは運用面の広さです。Ray はオーケストレーション能力を提供しますが、Ray クラスタ運用、自動スケーリングの挙動、オブジェクトストアの考慮事項、ログ、ダッシュボード、そして別のアップグレード経路も追加されます。1つのエンドポイントの背後にある単一モデルなら、vLLM を直接デプロイするほうが簡単な場合があります。
Kubernetes デプロイメントパターン
組織がすでに Kubernetes で GPU ノード、Ingress、シークレット、メトリクス、ロールアウト方針を運用しているなら、Kubernetes は適しています。小規模チームにとって、最初のデプロイとして自動的に正しいわけではありません。
Kubernetes のチェックリスト:
| 領域 | チェックリスト |
|---|---|
| GPU スケジューリング | ノードラベル、テイント、リソース要求、デバイスプラグイン、GPU 分離 |
| モデルストレージ | 永続ボリューム、オブジェクトストア同期、またはイメージ組み込み戦略 |
| 起動 | モデルキャッシュのウォームアップと現実的な readiness probe |
| ヘルス | 遅いが正常なモデル読み込みを終了させない liveness probe |
| ロールアウト | 高速ロールバック可能なカナリアまたはブルーグリーンデプロイメント |
| オートスケーリング | CPU だけでなく、キュー、レイテンシ、または GPU メトリクスに基づいてスケールする |
| ネットワーキング | デフォルトは内部専用。公開 Ingress は認証制御経由のみ |
| 可観測性 | ルートごとのレイテンシ、エラー率、GPU メモリ、コスト配賦 |
プラットフォームに GPU Kubernetes の成熟度がすでにないなら、まずは1台の GPU ホストかマネージドエンドポイントから始めてください。Kubernetes は運用リスクを減らすべきであり、単純なエンドポイントをクラスタプロジェクトに変えるべきではありません。
vLLM デプロイメントの負荷テスト計画
1つのプロンプトだけで負荷テストしないでください。代表的なリクエストセットを作成します。
少なくとも次の3つのトレースを使います。
- 短いチャット: 短いプロンプト、短い出力、高い同時実行数。
- 長文コンテキスト RAG: 長いプロンプト、中程度の出力、システムテンプレートと検索テンプレートの繰り返し。
- エージェントまたはツールループ: 繰り返しのスキーマ、構造化出力、キャンセル、リトライ、マルチターンコンテキスト。
記録する項目:
| メトリクス | 目標 |
|---|---|
| 1分あたりの受理リクエスト数 | 有効なスループットを測定する |
| 最初のトークンまでの時間 p50/p95/p99 | 対話レイテンシを示す |
| エンドツーエンドのレイテンシ p50/p95/p99 | ユーザーが体感するタスク時間を示す |
| エラー率とタイムアウト率 | 負荷下での信頼性を示す |
| リトライ調整後レイテンシ | 失敗後の実際の体験を示す |
| GPU メモリのピーク使用量 | 余裕を示す |
| 受理された出力あたりのコスト | 経済性を示す |
次の2つのベンチマークを実行します。
- デフォルト実行: 最小限の調整で、プロダクション投入までの時間を把握する。
- チューニング済み実行: バッチ処理、キャッシュ、量子化、リクエスト制限を調整し、上限性能を把握する。
チューニング済み実行が高速でも脆弱なら、デフォルトとしてデプロイしないでください。オンコール担当が説明できる設定をデプロイします。
自分で vLLM をデプロイしないほうがよい場合
ハードウェア制御、カスタム重み、厳格なデータローカリティ、または安定したワークロードで高い継続稼働率が必要な場合、セルフホスティングは価値があります。トラフィックが不確実、モデル選定が頻繁に変わる、最先端の独自モデルが必要、またはチームに推論運用 क्षमताがない場合は、魅力が下がります。
次のような場合は、まずマネージドモデル API またはルーターを選んでください。
- まだモデル品質を検証している。
- 頻繁なモデル切り替えが必要。
- トラフィックが突発的で予測しにくい。
- GPU 制御よりもプロバイダー間のフェイルオーバーが重要。
- GPU のチューニングの前に、利用台帳、予算、請求書、チームガバナンスが必要。
Flatkey は、API 側のワークロードで 1 つのキー、1 つの残高、1 つの請求書、利用記録、そして公式モデルルートへのアクセスが必要なときに、このレイヤーに適合します。後にあるワークロードが専用 GPU サービングに十分安定していると判明した場合は、セルフホストの vLLM エンドポイントを AI model pricing comparison、AI API pricing comparison、そして受け入れ済み出力 1 件あたりの測定済み GPU コストと引き続き比較してください。
デプロイメント・ランブック・テンプレート
起動前にこれをコピーしてください。
サービス:
  所有者:
  当番:
  モデルエイリアス:
  提供中のモデルリビジョン:
  vLLM バージョン:
  コンテナイメージ:
  GPU の種類と台数:
  ベース URL:

リクエストポリシー:
  最大モデル長:
  最大出力トークン数:
  最大同時実行数:
  キュータイムアウト:
  リクエストタイムアウト:
  認証方式:

可観測性:
  メトリクスダッシュボード:
  ログの場所:
  トレース/リクエスト ID フィールド:
  アラート閾値:

ロールアウト:
  カナリア比率:
  ロールバック用イメージ:
  ロールバック用モデルリビジョン:
  フォールバックルート:

コスト:
  GPU コストの出典:
  ストレージ/帯域幅の前提:
  受け入れ済み出力の分母:
  週次コストレビュー担当者:
このテンプレートは、最初の完璧なコマンドよりも重要です。オンコールに引き渡せない vLLM deployment guide は、まだ試作にすぎません。
よくある質問
マネージド GPU エンドポイントを使っても、これは vLLM deployment guide の内容ですか?
はい。vLLM がサービングエンジンであり、その公開、スケール、監視、保護の方法を決めているなら、依然として vLLM deployment guide に含まれます。生の VM、RunPod Serverless、Ray Serve、Kubernetes の間で運用詳細は異なりますが、受け入れテストは似ています。つまり、エンドポイント契約、レイテンシ、エラー、同時実行、ロールバック、そして受け入れ済み出力コストです。
vLLM には RunPod Serverless と永続的な GPU VM のどちらを使うべきですか?
バースト対応とマネージドなエンドポイント運用が、常時ウォームなレイテンシよりも重要なら RunPod Serverless を使ってください。予測可能なウォーム性能、ホストへの直接制御、またはより簡単なデバッグ経路が必要なら永続的な GPU VM を使ってください。レイテンシと利用率が判断材料なら、両方をベンチマークしてください。
vLLM と組み合わせて Ray Serve が有効なのはいつですか?
vLLM がより大きなサービングアプリケーションの一部であり、特にすでに Ray を運用している場合に Ray Serve は有効です。1 つのエンドポイントの背後に 1 つのモデルだけなら、vLLM を直接サービングするほうが運用しやすい場合があります。
vLLM は OpenAI API を置き換えられますか?
vLLM は、対応するセルフホストモデル向けに OpenAI 互換インターフェースを公開できますが、オープンウェイトモデルをプロプライエタリな最先端 API と同一にはしません。エンドポイント契約とサービングの選択肢として扱い、その後でモデル品質、レイテンシ、運用コストをワークロードに照らして検証してください。
最初に何を測定すべきですか?
受け入れ済み応答率、最初のトークンまでの時間、p95 と p99 のレイテンシ、タイムアウト率、GPU メモリ圧迫、そして受け入れ済み出力 1 件あたりのコストを測定してください。生の tokens per second は有用ですが、本番判断にはそれだけでは不十分です。
Flatkey は vLLM のどこに当てはまりますか?
GPU サービング層を自分たちで所有する必要があるときは vLLM を使ってください。1 つの OpenAI 互換モデル API レイヤー、統合請求、利用記録、そして公式モデルルートやツール全体でのガバナンスが欲しいときは Flatkey を使ってください。多くのチームは両方を使います。安定したセルフホストのワークロードには vLLM を、フロンティアモデル、フォールバック、実験、API 側のガバナンスには Flatkey を使います。
最終チェックリスト
起動前に、あなたの vLLM deployment guide は次の成果物を用意しているべきです:
- 固定されたモデルリビジョンとコンテナバージョン。
- テスト済みの OpenAI 互換ベース URL。
- 認証とネットワークの境界。
- コンテキスト、出力、タイムアウト、同時実行に関するリクエスト制限。
- レイテンシ、エラー、キューイング、スループット、GPU メモリのメトリクス。
- ロールバックルートと、直前の既知正常イメージ。
- 受け入れ済み出力あたりのコスト計算シート。
- このワークロードでセルフホスト vLLM がマネージドモデル API より優れている理由を説明する意思決定記録。
これらの成果物があれば、単に vLLM を動かしているだけではありません。GPU 上で LLM API を運用しているのです。


