
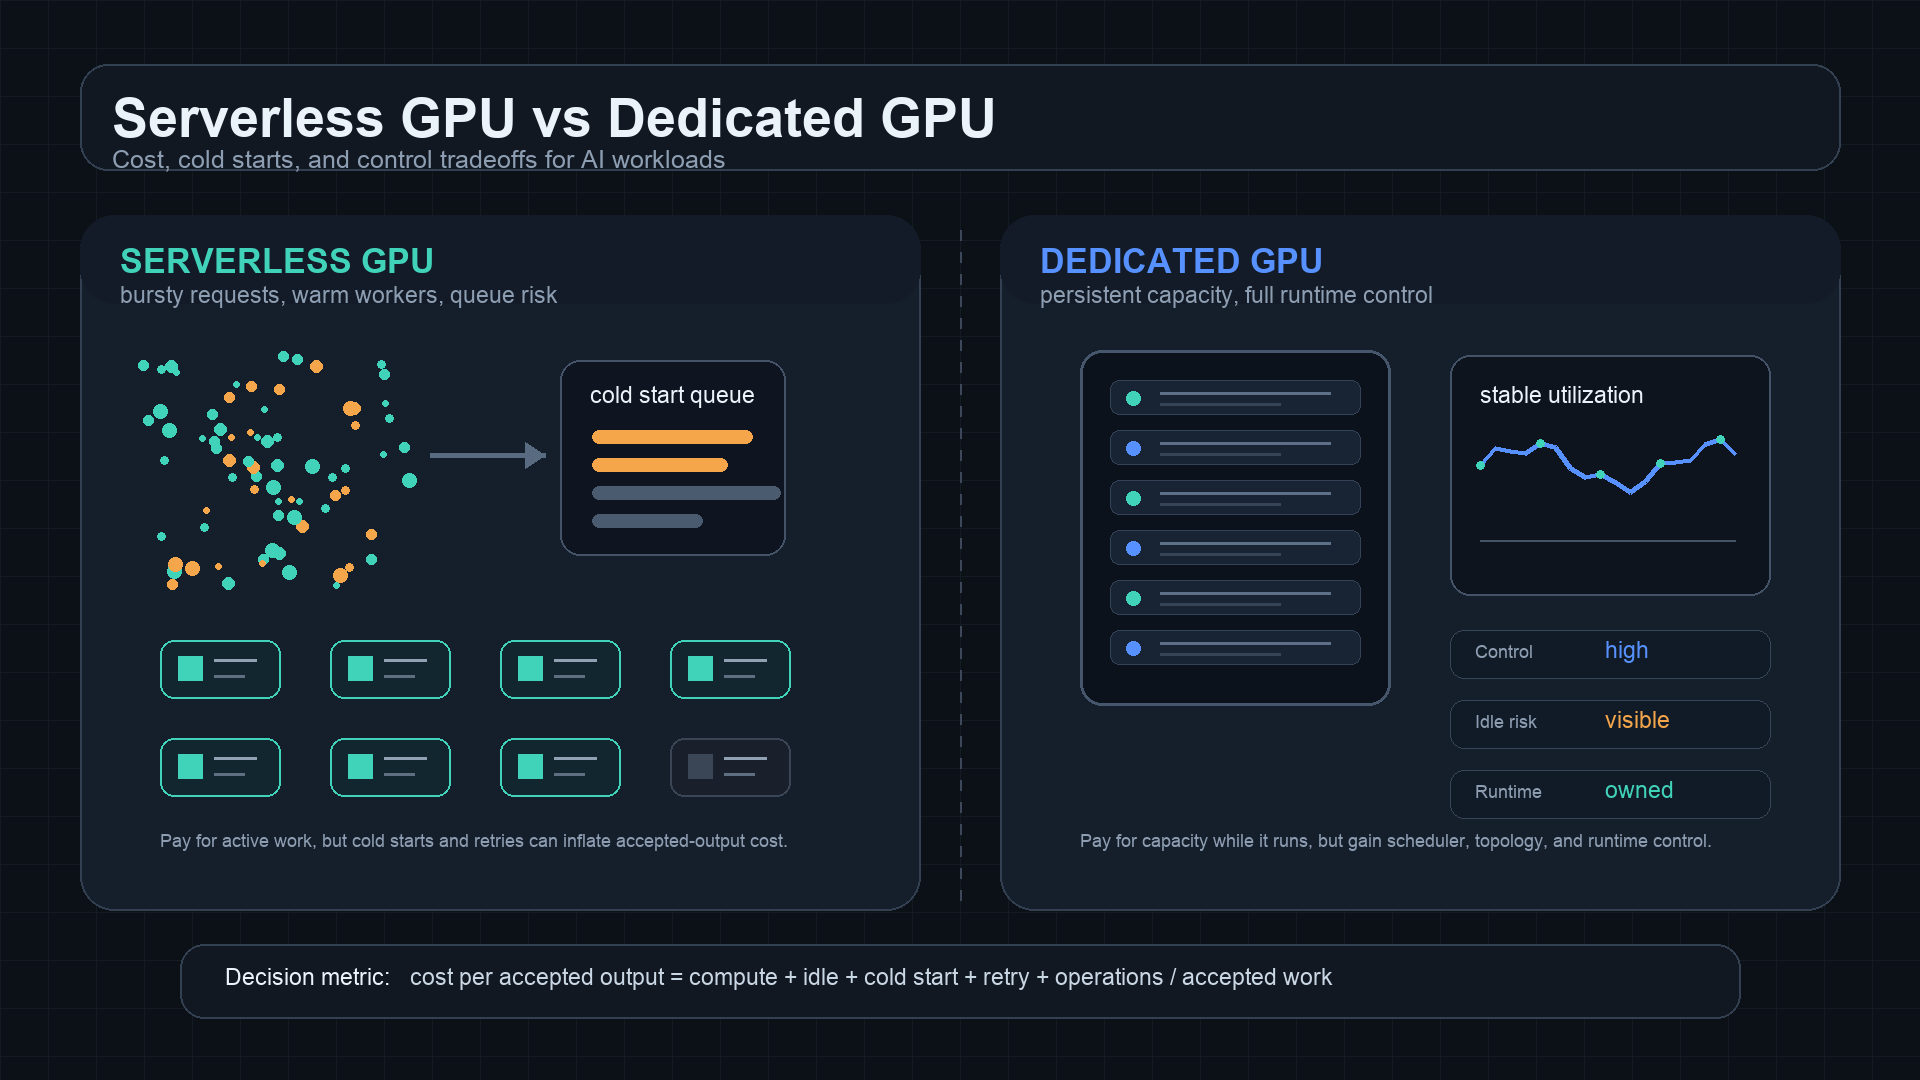
GPU serverless vs GPU dédié : coût, démarrages à froid et contrôle
Choisir entre GPU serverless et capacité GPU dédiée est surtout une question de forme de charge de travail. Les GPU serverless sont attrayants lorsque le trafic est par à-coups, que les expériences sont irrégulières ou que l’équipe veut éviter du matériel inactif. Les GPU dédiés sont attrayants lorsque la demande est stable, que la latence de démarrage compte ou que l’équipe a besoin de contrôler les pilotes, les ordonnanceurs, le réseau, les caches de modèles et les runtimes de diffusion.
L’erreur consiste à comparer le prix d’une requête GPU serverless avec un prix horaire GPU dédié comme s’ils décrivaient la même chose. Ce n’est pas le cas. Un endpoint serverless peut masquer les démarrages à froid, le délai de file d’attente, les limites de concurrence, le coût des retries et la surcharge par requête. Un GPU dédié peut masquer le temps d’inactivité, le risque lié à la capacité réservée, le stockage, le support et le travail d’ingénierie de plateforme.
Pour les développeurs indépendants et les petites équipes IA, la règle pratique est :
serverless GPU vs dedicated GPU should be compared by cost per accepted output,
not by the lowest visible GPU rate.
Si vous décidez encore si la location directe de GPU est nécessaire, lisez aussi les guides Flatkey sur GPU cloud vs API de modèle, les prix de location de GPU et les coûts cachés du cloud GPU. Cet article se concentre sur le choix entre GPU serverless et GPU dédié une fois que les GPU sont déjà dans l’ensemble d’évaluation.
GPU serverless vs GPU dédié : la réponse rapide
Utilisez ce tableau comme premier filtre.
| Point de décision | Le GPU serverless convient généralement | Le GPU dédié convient généralement |
|---|---|---|
| Profil de trafic | Par à-coups, en file d’attente, expérimental ou irrégulier | Stable, à volume élevé, sensible à la latence ou planifié en capacité |
| Forme de facturation | Payez principalement lorsque les workers tournent ou que les requêtes s’exécutent, selon le fournisseur | Payez pendant que l’instance, le pod, le nœud, le cluster ou la réservation existe |
| Risque de démarrage | Démarrages à froid, chargement du modèle, extraction du conteneur, montée en température du worker et délai de file d’attente | Moins d’exposition aux démarrages à froid après la montée en température, mais la capacité inactive est facturée |
| Contrôle opérationnel | Contrôle plus faible sur l’hôte, l’ordonnanceur, le runtime, la topologie et la mise en cache | Contrôle plus important sur les pilotes, la pile de diffusion, les caches, la topologie et l’observabilité |
| Modèle de fiabilité | Mise à l’échelle gérée par le fournisseur avec des limites d’endpoint et des parcours potentiellement froids | Disponibilité gérée par l’équipe, autoscaling, basculement, correctifs et réponse aux incidents |
| Meilleur premier usage | Démos, jobs image/vidéo, inférence par lots, API sporadiques, prototypes | Endpoints d’inférence stables, services de longue durée, runtimes personnalisés, travail multi-nœuds |
La meilleure réponse est souvent progressive :
- Commencez avec un GPU serverless pour une demande inconnue.
- Mesurez les démarrages à froid, le délai de file d’attente, le taux de retry et le coût par sortie acceptée.
- Ne migrez vers une capacité GPU dédiée que les charges de travail stables et à fort volume.
- Laissez un chemin API de modèle ouvert lorsque le produit a besoin de nombreux modèles ou n’a pas besoin de contrôle matériel.
Cette séquence est plus sûre que de réserver des GPU dédiés avant de savoir si la charge de travail peut les occuper.
Ce que signifie « GPU serverless » en pratique
GPU serverless signifie généralement que le fournisseur abstrait la possession de serveurs de longue durée. Vous empaquetez un modèle, un conteneur, une fonction ou un endpoint ; la plateforme démarre des workers GPU lorsque des requêtes arrivent ; et la plateforme peut faire monter ou descendre le nombre de workers en fonction de la demande.
Les implémentations des fournisseurs varient. RunPod décrit Serverless autour d’endpoints et de workers, avec une tarification serverless distincte de la tarification des pods. Modal documente les fonctions GPU, les démarrages à froid et le cycle de vie des conteneurs. Google Cloud Run prend en charge des services avec GPU et dispose de son propre modèle de tarification Cloud Run. Les déploiements Replicate exposent des endpoints d’inférence de production configurables. Ce ne sont pas des produits identiques, donc la checklist source compte.
Du point de vue d’un acheteur, la capacité GPU serverless est utile lorsque :
- Le volume de requêtes est faible, par à-coups ou encore en cours de découverte.
- Les jobs peuvent attendre dans une file sans nuire à l’expérience utilisateur.
- Les démarrages à froid sont acceptables ou peuvent être masqués.
- L’équipe souhaite assumer moins de responsabilités d’infrastructure.
- La charge de travail est empaquetée en jobs répétables plutôt qu’en service toujours chaud.
- L’entreprise préfère des dépenses adaptées à l’usage plutôt qu’un pari mensuel de capacité fixe.
Le compromis caché est que le GPU serverless n’annule pas la physique. Les poids du modèle doivent toujours être chargés. Les conteneurs doivent toujours démarrer. Les GPU doivent toujours avoir de la capacité disponible. Le délai de file d’attente affecte toujours les utilisateurs. Les retries coûtent toujours de l’argent.
Ce que signifie « GPU dédié » en pratique
Une capacité GPU dédiée signifie que vous contrôlez une instance, un pod, un serveur, un nœud ou un cluster en fonctionnement pendant une période donnée. Cela peut être à la demande, réservé, engagé, sur bare metal, en capacité marketplace ou dans un cluster privé. La caractéristique commune est que le GPU est alloué à votre charge de travail plutôt que d’être démarré uniquement autour d’une requête.
La capacité GPU dédiée est utile lorsque :
- L’endpoint doit rester chaud.
- Le trafic est suffisamment prévisible pour maintenir le GPU occupé.
- Vous avez besoin de pilotes personnalisés, de versions CUDA, de kernels, de serveurs de modèles ou de réseau spécifiques.
- Vous avez besoin de conditions de benchmark cohérentes.
- Un démarrage à froid casserait la latence ou l’expérience utilisateur.
- La charge de travail est multi-nœuds, sensible à la topologie ou sensible à la localisation des données.
- Vous voulez exploiter directement vLLM, SGLang, TensorRT-LLM, Triton, Ray Serve, Kubernetes, Slurm ou une infrastructure de service personnalisée.
Le compromis caché, c’est la capacité inactive. Si un GPU dédié fonctionne pendant 730 heures dans un mois mais n’effectue un travail utile que pendant 180 heures, le prix horaire affiché n’est pas le vrai prix par heure utile. Les heures d’inactivité font partie du coût de la charge de travail.
La formule de coût qui rend la comparaison équitable
Utilisez un seul dénominateur pour les deux côtés :
coût par sortie acceptée =
  calcul
  + stockage
  + bande passante
  + temps d’inactivité
  + gaspillage lié aux démarrages à froid
  + gaspillage lié aux retries et aux tâches échouées
  + support
  + surcharge d’ingénierie
  / sorties acceptées, enregistrements, jetons, images, clips ou tâches
Pour le GPU serverless :
coût GPU serverless par sortie acceptée =
  coût facturé par worker/requête
  + gaspillage lié aux démarrages à froid et à la file d’attente
  + coût des requêtes échouées et des retries
  + stockage et transfert des artefacts
  + surcharge d’intégration de la plateforme
  / sorties acceptées
Pour le GPU dédié :
coût GPU dédié par sortie acceptée =
  coût de capacité GPU en fonctionnement
  + stockage et réseau
  + capacité inactive
  + opérations de la pile de service
  + support et travail sur incident
  + gaspillage lié aux échecs et aux redéploiements
  / sorties acceptées
C’est ici que les comparaisons entre GPU serverless et GPU dédié s’inversent souvent. Le serverless peut sembler cher par seconde mais moins coûteux au total s’il évite des GPU inactifs. Le dédié peut sembler cher par mois mais moins coûteux au total si la charge de travail maintient l’accélérateur occupé et évite le gaspillage des démarrages à froid.
Les démarrages à froid sont la taxe du GPU serverless
Les démarrages à froid sont le risque le plus important du GPU serverless. Un démarrage à froid peut inclure :
- La recherche de capacité GPU.
- Le téléchargement ou le montage d’une image de conteneur.
- L’import des dépendances.
- Le chargement des poids du modèle.
- Le déplacement du modèle vers la mémoire GPU.
- Le réchauffement des kernels ou des chemins de compilation.
- La reconstruction des caches.
- L’attente derrière des requêtes précédemment mises en file d’attente.
La documentation de Modal sur les démarrages à froid est utile car elle distingue le démarrage du conteneur, les imports et l’initialisation de l’application. Les mécanismes exacts diffèrent selon le fournisseur, mais la leçon reste la même : le temps de démarrage fait partie de l’expérience utilisateur et du modèle de coût.
Les démarrages à froid sont particulièrement importants lorsque :
| Charge de travail | Pourquoi les démarrages à froid font mal |
|---|---|
| Chat interactif ou agents | Les utilisateurs remarquent une latence élevée sur le premier jeton. |
| Édition d’images en temps réel | La première requête peut sembler cassée même si les suivantes sont rapides. |
| Webhooks ou API exposées aux utilisateurs | Les timeouts en amont peuvent transformer les démarrages à froid en tâches échouées. |
| Files batch avec SLA strict | Le délai de file d’attente peut faire manquer les fenêtres de livraison. |
| Grands modèles | Le chargement des poids peut dominer le chemin de la requête. |
Le GPU serverless peut néanmoins être le bon choix si l’application peut absorber ce délai. Par exemple, les tâches d’images hors ligne, les files d’évaluation nocturnes, l’inférence batch asynchrone et les expérimentations internes tolèrent souvent mieux le réchauffement que le chat destiné aux clients.
Les GPU dédiés échangent les démarrages à froid contre le risque d’inactivité
Les GPU dédiés réduisent généralement l’exposition aux démarrages à froid, car le service peut rester chaud. Les poids du modèle restent chargés, les caches restent chauds et le routage des requêtes peut viser un endpoint connu.
Mais la capacité dédiée crée une autre taxe :
part de gaspillage inactif =
  1 - temps utile GPU actif / temps de fonctionnement facturable
Si la part utile de temps GPU actif est de 30 %, un tarif horaire affiché plus bas peut malgré tout devenir coûteux. Le GPU dédié peut être techniquement prêt, mais financièrement inactif.
Les GPU dédiés fonctionnent le mieux lorsque vous pouvez prouver :
- Un volume de requêtes de base.
- Une forte utilisation du GPU après batching et mise en file d’attente.
- Un choix de modèle stable.
- Des besoins mémoire prévisibles.
- Une pile de service que l’équipe peut exploiter.
- Un plan pour les déploiements progressifs, la surveillance, les alertes et le repli.
Si ces paramètres sont inconnus, le GPU serverless ou une API de modèle est souvent la première étape la plus simple.
Contrôle : ce que les GPU dédiés redonnent
L’argument le plus fort en faveur de la capacité GPU dédiée n’est pas toujours le prix. C’est le contrôle.
La capacité dédiée donne à l’équipe davantage de latitude sur :
- Le modèle, la mémoire et le nombre de GPU.
- La région et la localisation des données.
- Les versions de CUDA, des pilotes, du kernel et des images.
- vLLM, SGLang, TensorRT-LLM, Triton, Ray Serve ou les paramètres d’exécution personnalisés.
- Le batching continu, le comportement du cache KV, la quantification, le décodage spéculatif et le réglage du planificateur.
- Les caches de modèles locaux et les poids préchargés.
- La topologie réseau, les liens privés, la conception VPC, les équilibreurs de charge et l’ingress.
- L’observabilité, les traces, les journaux et la réponse aux incidents.
Ce contrôle est précieux lorsque la charge de travail est suffisamment importante pour justifier la responsabilité. Il est coûteux lorsque l’équipe n’a besoin que de sorties de modèle fiables.
C’est la même frontière abordée dans les articles de Flatkey sur le meilleur GPU pour l’inférence LLM, le guide de déploiement vLLM et vLLM vs SGLang. Si vous optimisez le runtime lui-même, une capacité GPU dédiée peut être la bonne couche. Si vous déployez des fonctionnalités produit sur de nombreux modèles, un chemin API managé peut être plus rapide.
Matrice de décision des charges de travail
Utilisez cette matrice avant de créer un tableur.
| Charge de travail | Meilleur point de départ | Pourquoi |
|---|---|---|
| Nouvelle fonctionnalité produit IA avec demande inconnue | GPU serverless ou API de modèle | Évite d’acheter de la capacité inactive avant de connaître le trafic. |
| File d’attente de génération d’images asynchrone | GPU serverless | Le délai de file d’attente peut être acceptable, et les pics ne nécessitent pas de GPU toujours actifs. |
| Démo ou prototype court | GPU serverless | Une mise en place rapide et une facturation à l’usage comptent généralement plus que le contrôle du runtime. |
| Inférence LLM stable à fort volume | GPU dédié | Une utilisation soutenue peut amortir la pile de service. |
| Point de terminaison client sensible à la latence | GPU dédié ou API de modèle | Les démarrages à froid et le délai de file d’attente sont plus difficiles à masquer. |
| Grand modèle avec chargement lent des poids | GPU dédié | Garder les poids prêts peut être meilleur qu’un démarrage serverless répété. |
| Suite d’évaluation périodique | GPU serverless, GPU spot ou API de modèle batch | Les tâches sont relançables et peuvent s’exécuter derrière une file d’attente. |
| Kernels CUDA personnalisés ou recherche sur le runtime | GPU dédié | L’équipe a besoin d’un contrôle de bas niveau. |
| Entraînement multi-nœuds ou inférence distribuée | Cluster dédié | La topologie, le réseau et les domaines de défaillance dominent. |
| Produit nécessitant de nombreux modèles de pointe | API de modèle ou passerelle | La possession directe d’un GPU ne résout pas l’accès à des modèles multi-fournisseurs. |
Pour une planification de capacité plus large, associez cela aux guides de Flatkey sur le GPU à la demande vs GPU spot, le TCO d’un cluster GPU et la location de cluster GPU.
Pièges de coût du GPU serverless
L’économie du GPU serverless peut décevoir lorsque les équipes ignorent ces éléments.
| Piège | Ce qui se passe | Contrôle |
|---|---|---|
| Chargement lent du modèle | Chaque worker à froid passe du temps facturable avant que le travail utile ne commence | Préemballez les artefacts, réduisez la taille des images, mettez les poids en cache, mesurez séparément la phase de warmup |
| Inadéquation des timeouts | Les démarrages à froid déclenchent des timeouts en amont et des retries | Définissez des timeouts réalistes, des files asynchrones, des identifiants de tâche idempotents |
| Opacité de la file d’attente | Les utilisateurs voient un délai, mais les tableaux de bord n’affichent que les requêtes terminées | Suivez l’attente en file, le temps de démarrage à froid, le temps d’activité du worker et la latence entre acceptation et sortie |
| Petites tâches sur de gros GPU | Le surcoût par requête domine le calcul utile | Regroupez les tâches ou utilisez un modèle plus petit/une route API |
| Limites de concurrence en rafale | Les requêtes s’accumulent pendant les fenêtres de lancement | Testez la concurrence du point de terminaison avant le lancement |
| Amplification des retries | Les tâches échouées multiplient les tentatives facturées | Suivez les sorties acceptées, pas les sorties tentées |
| Transfert de données | Les entrées, les poids et les sorties circulent à répétition | Gardez les artefacts proches des workers et expirez les fichiers temporaires |
La question d’achat n’est pas « le fournisseur prend-il en charge le GPU serverless ? » C’est « que devient le coût par sortie acceptée quand les workers sont froids, que les files sont pleines et que des retries se produisent ? »
Pièges de coût du GPU dédié
L’économie du GPU dédié peut décevoir dans l’autre sens.
| Piège | Ce qui se passe | Contrôle |
|---|---|---|
| Point de terminaison inactif | Le GPU reste chaud pour de rares requêtes | Autoscalez, consolidez les charges ou utilisez un modèle API/serverless pour les faibles volumes |
| Mémoire surdimensionnée | Un gros GPU exécute une charge qui tiendrait sur du matériel plus petit | Benchmarkez la mémoire et le débit du modèle avant de vous engager |
| Inadéquation de la réservation | Le contrat suppose une demande qui n’apparaît jamais | Réservez sur la base du socle mesuré, pas sur des prévisions de lancement |
| Propriété de la pile de service | Les ingénieurs maintiennent le runtime au lieu des fonctionnalités produit | Intégrez le travail de plateforme dans le TCO |
| Lignes cloud cachées | Le stockage, l’egress, le support et le réseau sont en dehors du tarif GPU | Utilisez une feuille de calcul complète des coûts cachés du cloud GPU |
| Rotation des modèles | Une nouvelle famille de modèles modifie les besoins en mémoire, précision ou runtime | Gardez des voies de sortie ouvertes |
| Charge d’incident | La disponibilité devient le problème de votre équipe | Définissez les alertes, le fallback et le périmètre du support fournisseur |
Le contrôle du GPU dédié n’a de valeur que lorsque l’équipe peut l’exploiter. Si la charge de travail n’est pas assez stable pour être optimisée, ce contrôle supplémentaire peut devenir un fardeau opérationnel.
Exemple chiffré : pourquoi la réponse change avec l’utilisation
Prenons une équipe qui exécute une fonctionnalité de génération de médias asynchrone. Les tarifs exacts sont hypothétiques ; remplacez-les par des prix fournisseurs vérifiés avant d’acheter.
| Champ | GPU serverless | GPU dédié |
|---|---|---|
| Jobs acceptés par mois | 120,000 | 120,000 |
| Calcul affiché | Façonné par l’usage | Capacité mensuelle fixe |
| Démarrage à froid et gaspillage de file d’attente | Plus élevé | Plus faible |
| Capacité inactive | Plus faible | Plus élevée |
| Contrôle du temps d’exécution | Plus faible | Plus élevé |
| Meilleur risque | La demande est inconnue | La demande est stable |
Si la plupart des jobs arrivent par courtes rafales et que le reste de la journée est calme, le GPU serverless peut l’emporter car il évite la capacité dédiée inactive. Si les jobs arrivent régulièrement toute la journée et que le modèle a une phase de préchauffage lente, le GPU dédié peut l’emporter car les workers restent chauds et le débit est plus facile à ajuster.
Modifiez maintenant la charge de travail pour une inférence LLM orientée client avec une latence stricte. La décision peut basculer même si le serverless paraît moins cher sur un trafic léger, car les chemins de démarrage à froid et la latence de file d’attente créent un risque produit. Dans ce cas, un GPU dédié ou une API de modèle gérée avec des contrôles de latence établis peut être plus sûr.
Le point n’est pas qu’un modèle gagne toujours. Le point est que le choix entre GPU serverless et GPU dédié doit être décidé à partir de la forme mesurée de la charge de travail.
Plan de benchmark avant de choisir
Exécutez la même charge de travail sur les deux chemins pendant une fenêtre de test représentative. Suivez ces métriques.
| Métrique | Chemin GPU serverless | Chemin GPU dédié |
|---|---|---|
| Résultats acceptés | Compter les résultats réussis après les filtres de qualité | Même dénominateur |
| Résultats tentés | Inclure les jobs ayant échoué et retentés | Inclure les jobs ayant échoué et retentés |
| Latence p50 / p95 / p99 | Inclure le temps de file d’attente et de démarrage à froid | Inclure le temps de routage et de batch |
| Temps jusqu’au premier travail utile | Démarrage du worker, chargement du modèle, préchauffage | Démarrage du déploiement, chargement du modèle, déploiement progressif |
| Part de démarrages à froid | Pourcentage de requêtes touchant des workers à froid | Généralement plus faible après préchauffage |
| Attente en file | Retard de file de l’endpoint et pression de concurrence | File du planificateur et attente du batch |
| Utilisation du GPU | Temps d’activité du worker s’il est exposé | Utilisation du calcul et de la mémoire du GPU |
| Coût d’inactivité | Généralement plus faible, mais vérifier les minimums | Principal risque de coût |
| Taux de nouvelle tentative | Timeout, erreurs de worker, erreurs de capacité | OOM, déploiement, runtime, erreurs d’hôte |
| Heures d’ingénierie | Intégration et débogage de l’endpoint | Opérations de la plateforme et travail sur les incidents |
Le test doit inclure des conditions froides, des conditions chaudes, du trafic en rafale, du trafic normal et la récupération après panne. Un benchmark qui ne mesure que le débit à chaud n’est pas une décision entre GPU serverless et GPU dédié ; c’est un test de vitesse partiel.
Liste de contrôle des sources fournisseur
Utilisez les pages officielles comme listes de contrôle des sources, et non comme grilles tarifaires figées. Vérifiez-les à nouveau le jour où vous approuvez la dépense.
| Fournisseur/catégorie | Source officielle à vérifier | Éléments à capturer |
|---|---|---|
| RunPod Serverless | Présentation de RunPod Serverless, Tarification de RunPod Serverless | Modèle d’endpoint, comportement des workers, base de facturation, comportement de démarrage à froid, stockage, réseau, concurrence, journaux, limites |
| RunPod Pods / style dédié | Présentation de RunPod Pods, Tarification de RunPod Pods, Tarification RunPod | Modèle de GPU, mode sécurisé/communautaire, facturation du pod, stockage, volume réseau, attentes en matière de disponibilité |
| Modal | Documentation GPU de Modal, Démarrages à froid Modal, Tarification Modal | Type de GPU, cycle de vie de la fonction, contrôles de démarrage à froid, stratégie d’image de conteneur, facturation de l’utilisation active |
| Google Cloud Run avec GPU | Configuration GPU de Cloud Run, Tarification Cloud Run | Contraintes du service GPU, instances minimales, concurrence, facturation CPU/mémoire/GPU, impact sur la latence des requêtes |
| Google Compute Engine GPU | Tarification GPU de Compute Engine | Type de GPU, région, coût de la VM, disque, réseau, réservations, remises pour engagement |
| Instances GPU AWS EC2 | Tarification Amazon EC2 | À la demande, Spot, Savings Plans, Reserved Instances, blocs de capacité, stockage, transfert de données, support |
| Lambda Cloud | Lambda GPU Cloud | Type d’instance, disponibilité, conditions à la demande/réservées, stockage, réseau, périmètre du support |
| Déploiements Replicate | Documentation des déploiements Replicate | Paramètres de déploiement, comportement de montée en charge, options matérielles, instances minimales/maximales, adéquation à un endpoint de production |
Pour cet article, la liste de contrôle des sources a été examinée le 13 octobre 2026.
Questions d’achat avant de vous engager
Posez ces questions avant de choisir entre GPU serverless et GPU dédié.
| Question | Pourquoi c’est important |
|---|---|
| Quel est le dénominateur des sorties acceptées ? | Évite de comparer les tentatives de requête avec les résultats métier réussis. |
| À quelle fréquence le point de terminaison sera-t-il à froid ? | Les démarrages à froid peuvent dominer la latence et le coût pour des charges de travail sporadiques. |
| Combien de temps prend le chargement du modèle ? | De gros poids peuvent annuler les économies du serverless. |
| Que se passe-t-il lors d’un pic de concurrence ? | Les files d’attente serverless et les autoscalers dédiés doivent tous deux être soumis à des tests de charge. |
| Quel est le taux d’inactivité du GPU dédié ? | La capacité inutilisée est la principale fuite de coût fixe. |
| Les tâches peuvent-elles être relancées en toute sécurité ? | Les workflows serverless et de type spot ont besoin d’idempotence. |
| Avons-nous besoin d’un contrôle runtime personnalisé ? | Sinon, la possession d’un GPU dédié peut être inutile. |
| Le stockage, l’egress, les logs et le support sont-ils inclus ? | Le calcul GPU n’est qu’une partie de la facture. |
| La charge de travail peut-elle migrer vers une API de modèle ? | Les produits à faible utilisation ou multi-modèles peuvent ne pas justifier des opérations GPU. |
| Quel est le plan de sortie si le modèle change ? | Les engagements matériels deviennent risqués lorsque l’architecture du modèle évolue. |
Le meilleur dossier d’achat comprend un résultat de benchmark, une feuille de calcul du coût par sortie acceptée, et une raison claire expliquant pourquoi l’équipe a besoin soit d’une capacité GPU serverless adaptée à l’usage, soit d’une capacité GPU dédiée contrôlée.
Quand une API de modèle surpasse les deux
Le GPU serverless comme le GPU dédié partent du principe qu’il est utile d’opérer au niveau GPU. Parfois, ce n’est pas le cas.
Une API de modèle managée ou une passerelle peut être préférable lorsque :
- La demande est inconnue ou en rafales.
- Le produit a besoin de plusieurs modèles, et non d’un seul modèle stable auto-hébergé.
- L’équipe a besoin de modèles de pointe ou propriétaires.
- La fiabilité, le fallback et la diversité des fournisseurs comptent plus que le contrôle de l’hôte.
- La finance a besoin de journaux d’utilisation, de budgets et d’une seule facture.
- Le temps d’ingénierie est mieux consacré au comportement du produit qu’aux opérations GPU.
Flatkey correspond à ce côté de la décision. Il offre aux équipes un seul chemin compatible OpenAI, une seule clé, un seul solde, une seule facture, une visibilité sur l’usage, et un accès aux points de terminaison officiels des modèles à travers plusieurs fournisseurs. Si la feuille de calcul serverless GPU vs GPU dédié montre une faible utilisation, un gaspillage élevé lié aux démarrages à froid ou trop de surcharge opérationnelle, comparez cette voie avec comparaison des prix des modèles d’IA, comparaison des prix des API d’IA, et gestion des dépenses d’API d’IA avant de vous engager dans une infrastructure GPU.
Recommandation finale
Utilisez cette séquence pour les décisions serverless GPU vs GPU dédié :
- Utilisez le GPU serverless pour les prototypes, les tâches en rafales, les files d’attente asynchrones et la demande inconnue.
- Mesurez les démarrages à froid, le délai de file d’attente, le taux de reprise et le coût par sortie acceptée.
- Ne migrez les charges de travail stables, à fort volume et sensibles à la latence vers une capacité GPU dédiée qu’après avoir prouvé l’utilisation.
- Gardez une voie d’accès à une API de modèle ouverte lorsque le choix du modèle change souvent, qu’un contrôle matériel n’est pas requis, ou que l’équipe a besoin d’une facturation et d’un fallback plus propres.
Le choix serverless GPU vs GPU dédié n’est pas une décision universelle du type le gagnant rafle tout. Le GPU serverless achète de la flexibilité et réduit le risque d’inactivité. Le GPU dédié achète du contrôle et une capacité plus chaude. La bonne réponse est celle qui offre à votre équipe le coût le plus bas par sortie acceptée tout en plaçant la latence, la fiabilité et le risque opérationnel là où vous pouvez réellement les gérer.
Questions fréquemment posées
Le GPU serverless est-il moins cher que le GPU dédié ?
Le GPU serverless est moins cher lorsque le trafic est faible, en rafales ou incertain au point que des GPU dédiés resteraient inactifs. Le GPU dédié est moins cher lorsque l’utilisation est élevée, que le modèle reste chaud et que l’équipe peut exploiter efficacement la pile de service.
Le GPU serverless a-t-il toujours des démarrages à froid ?
Toutes les requêtes ne seront pas à froid, et les fournisseurs proposent différents contrôles pour la capacité chaude, le nombre minimum de workers, l’optimisation des images et la mise à l’échelle. Mais les démarrages à froid constituent un risque central dans l’évaluation du GPU serverless, car les grands modèles et conteneurs peuvent prendre un temps significatif avant de devenir utiles.
Quand dois-je passer du GPU serverless au GPU dédié ?
Faites-le lorsque vous pouvez prouver une demande stable, une utilisation élevée, une latence de démarrage à froid inacceptable, un besoin de contrôle runtime personnalisé, ou un avantage de coût par sortie acceptée après prise en compte des opérations et du temps d’inactivité.
Le GPU dédié est-il meilleur pour l’inférence LLM ?
Le GPU dédié peut être meilleur pour une inférence LLM stable à fort volume, surtout lorsque vous optimisez vLLM, SGLang, TensorRT-LLM, le batching, le comportement du cache et le chargement du modèle. Pour des produits à faible volume, multi-modèles ou qui évoluent rapidement, une API de modèle peut être plus simple et moins chère.
Que dois-je mesurer en premier ?
Mesurez les sorties acceptées, la part des démarrages à froid, l’attente en file, la latence p95/p99, le taux de reprise, l’utilisation utile du GPU, le coût d’inactivité, le stockage/l’egress et les heures d’ingénierie. Ces métriques rendent la décision serverless GPU vs GPU dédié défendable.


