
Custos, cobrança e operações
Artigos mais recentes em Custos, cobrança e operações.
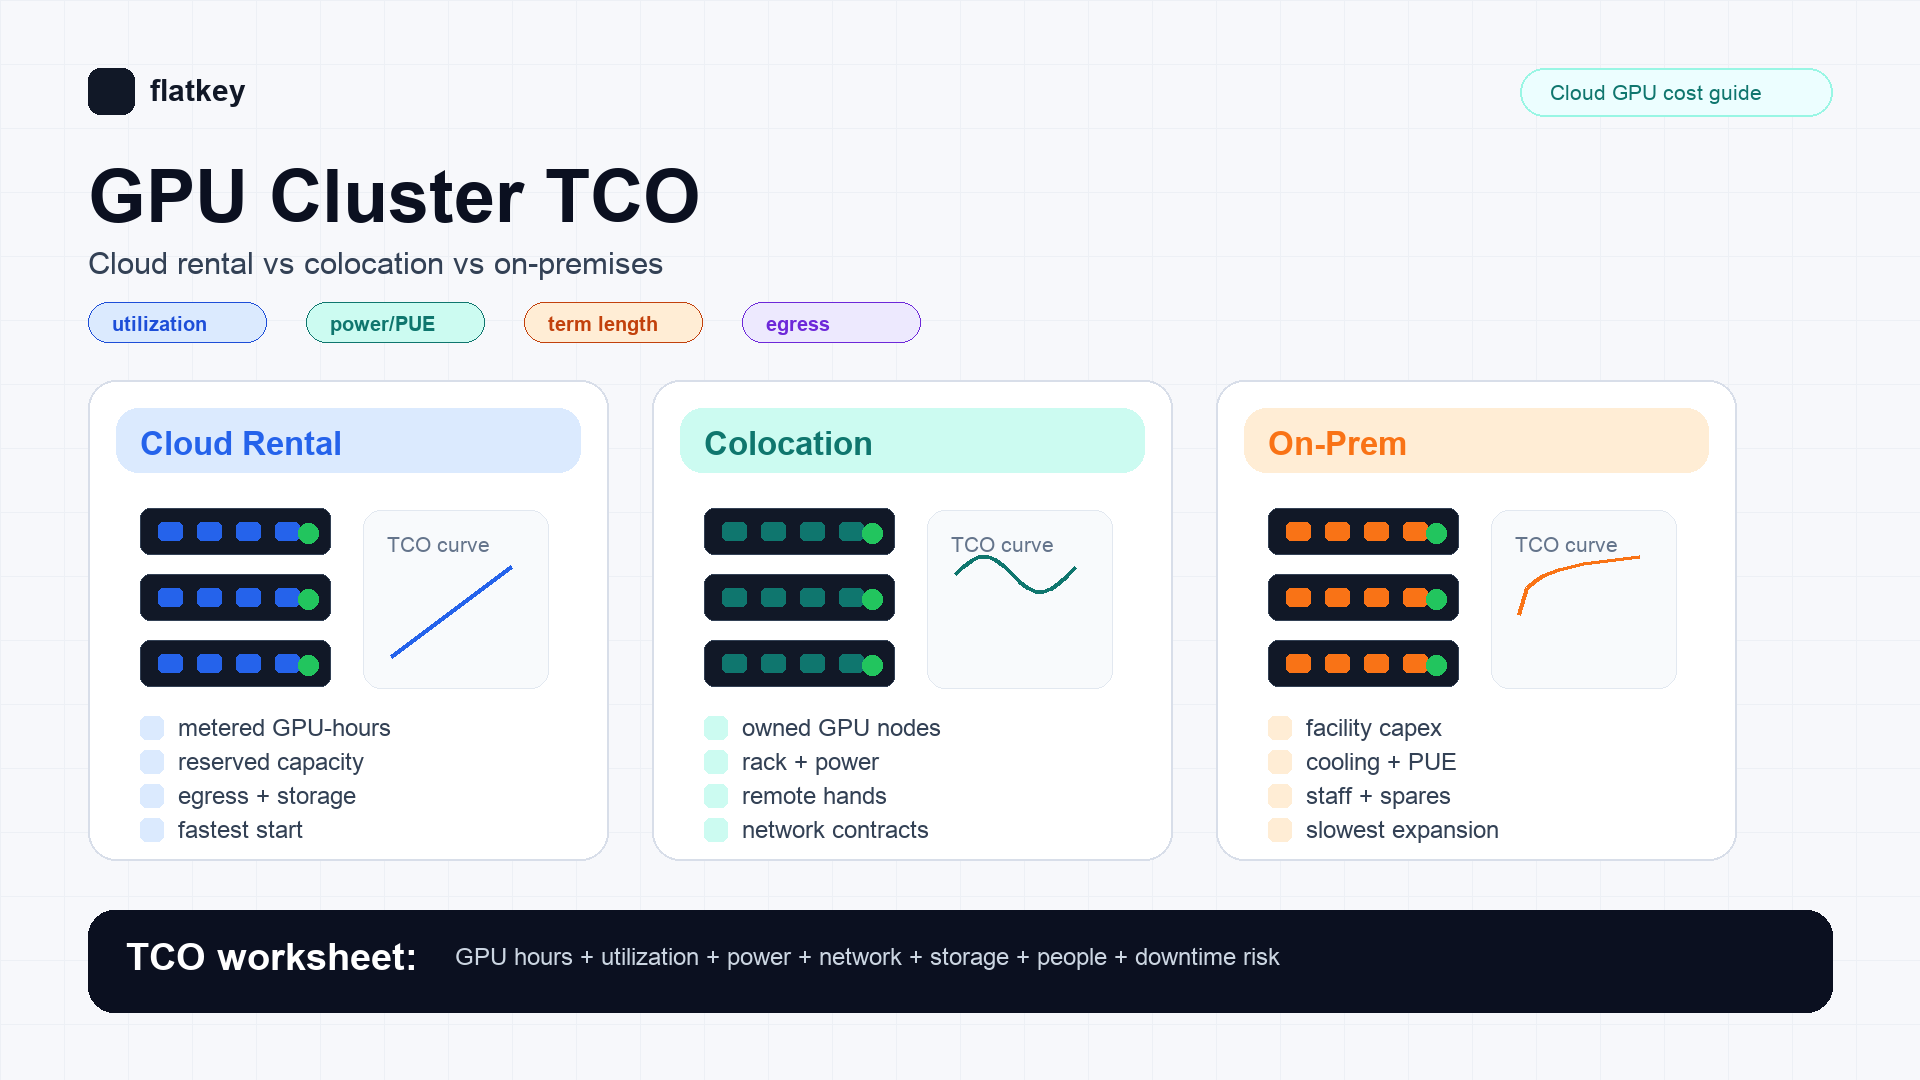
TCO de Cluster GPU: aluguel na nuvem vs colocation vs on-premises
Compare o TCO de clusters GPU entre aluguel na nuvem, colocation e on-premises com uma planilha prática de FinOps para compradores de infraestrutura de IA.
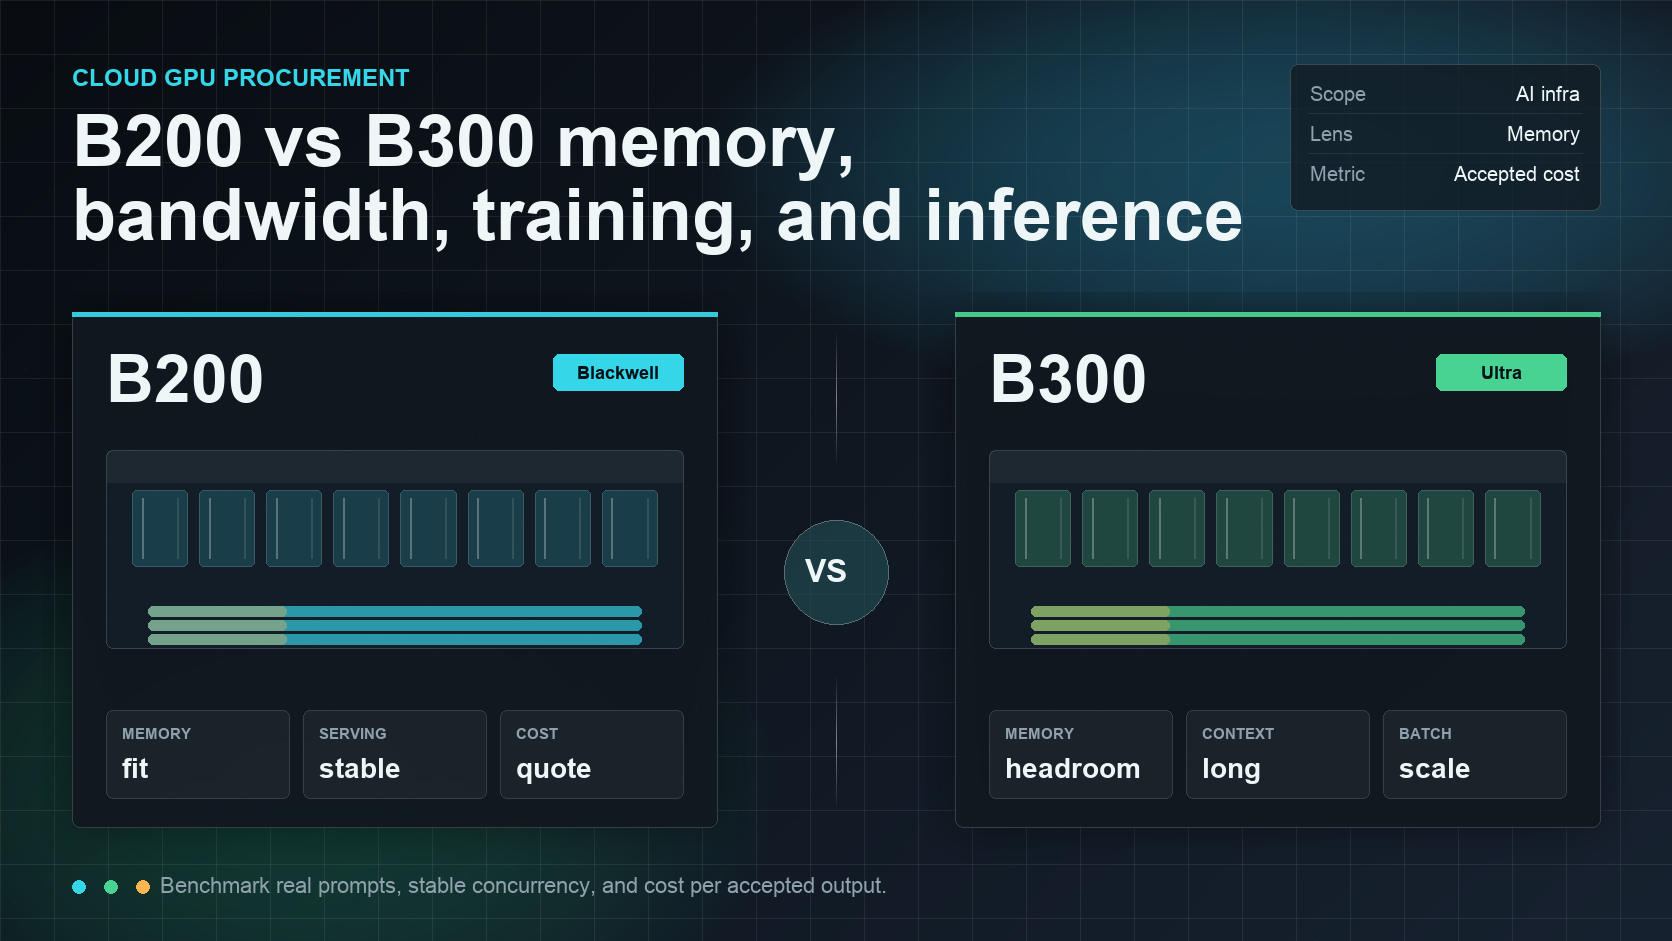
NVIDIA B300 vs B200: Memória, Banda, Treino e Inferência
Uma comparação prática entre B200 e B300 para equipas de infraestrutura de ML que avaliam a memória, a largura de banda, o treino, a inferência e a economia de aquisição das GPUs NVIDIA Blackwell.
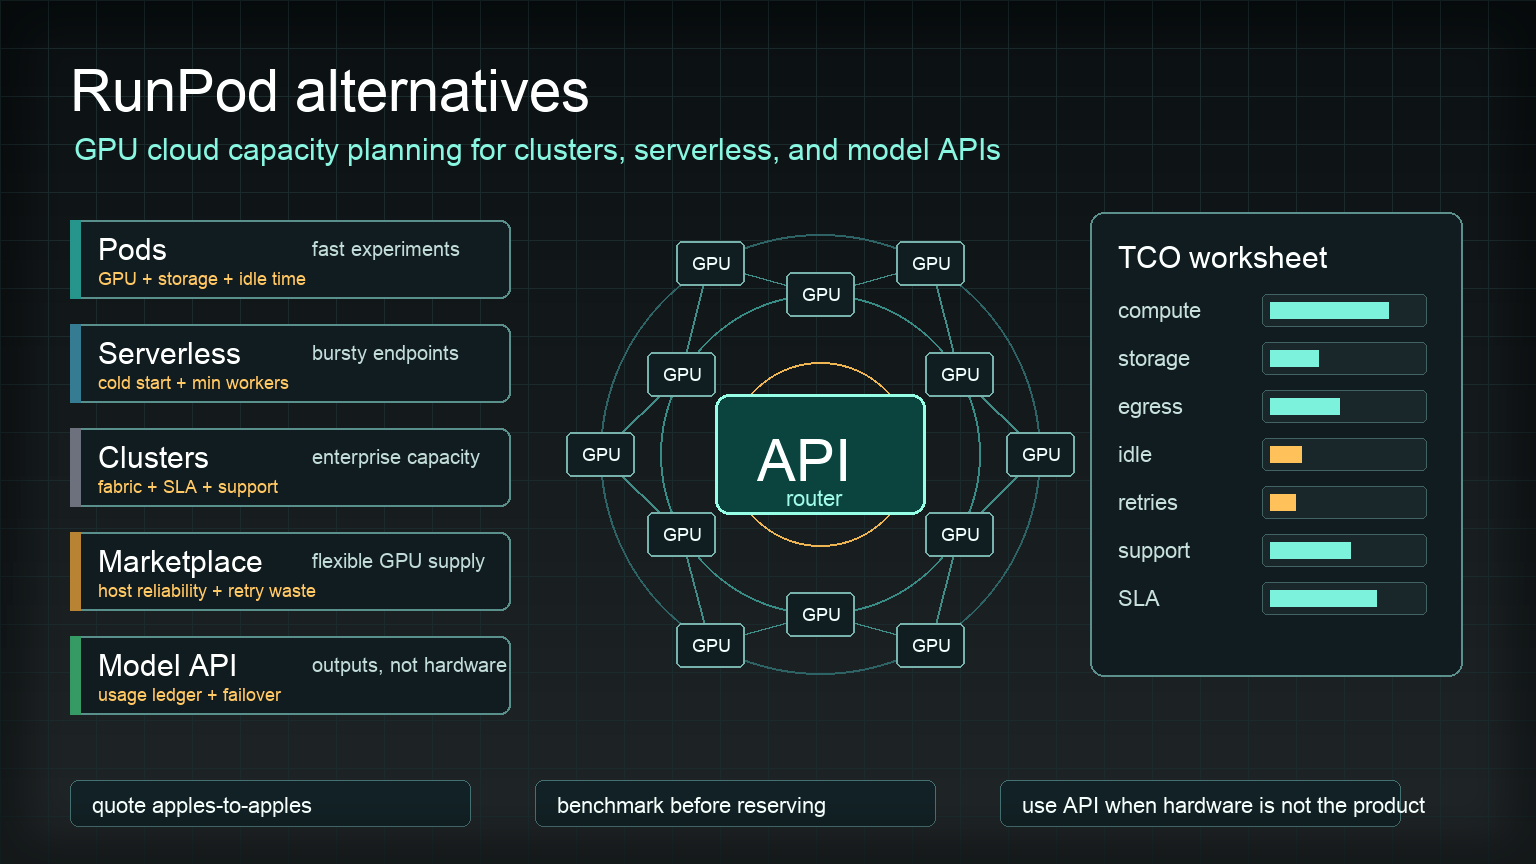
10 melhores alternativas ao RunPod em 2026: preços, vantagens e qual escolher
Compare 10 alternativas ao RunPod com preços de GPUs de outubro de 2026: marketplaces mais baratos, nuvens de GPU estáveis, plataformas serverless e APIs de modelos, além de Vast.ai vs RunPod, confiabilidade e um checklist de migração.
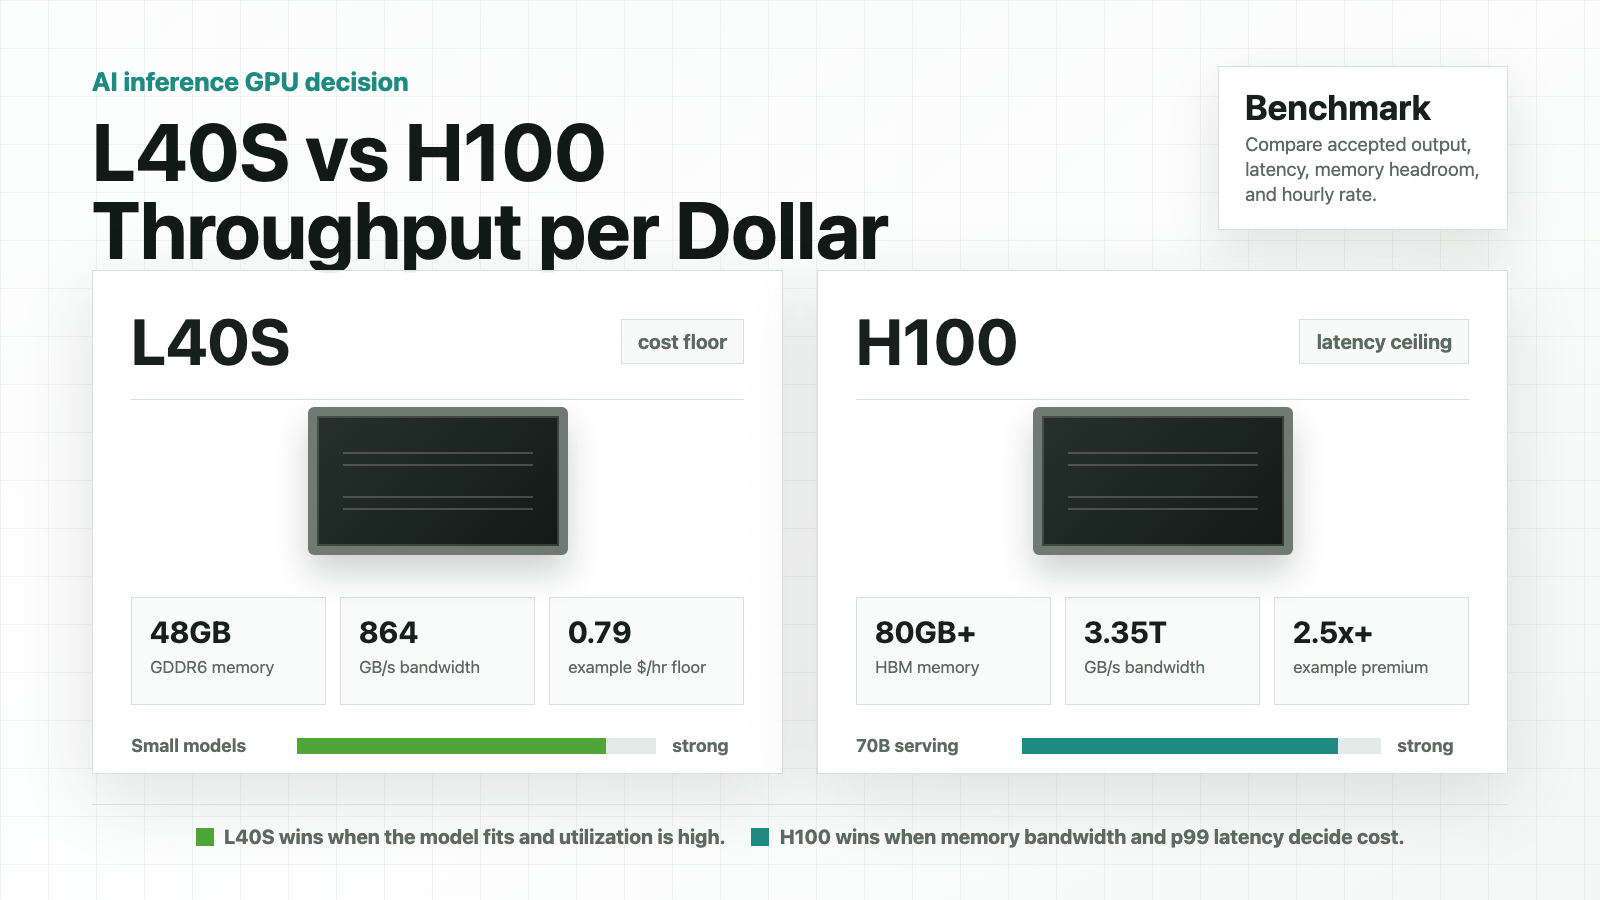
NVIDIA L40S vs H100 para Inferência de IA: Throughput por Dólar
Uma comparação prática entre L40S e H100 para equipes de IA que avaliam throughput de inferência, latência, adequação de memória e custo de GPU na nuvem por saída aceita.
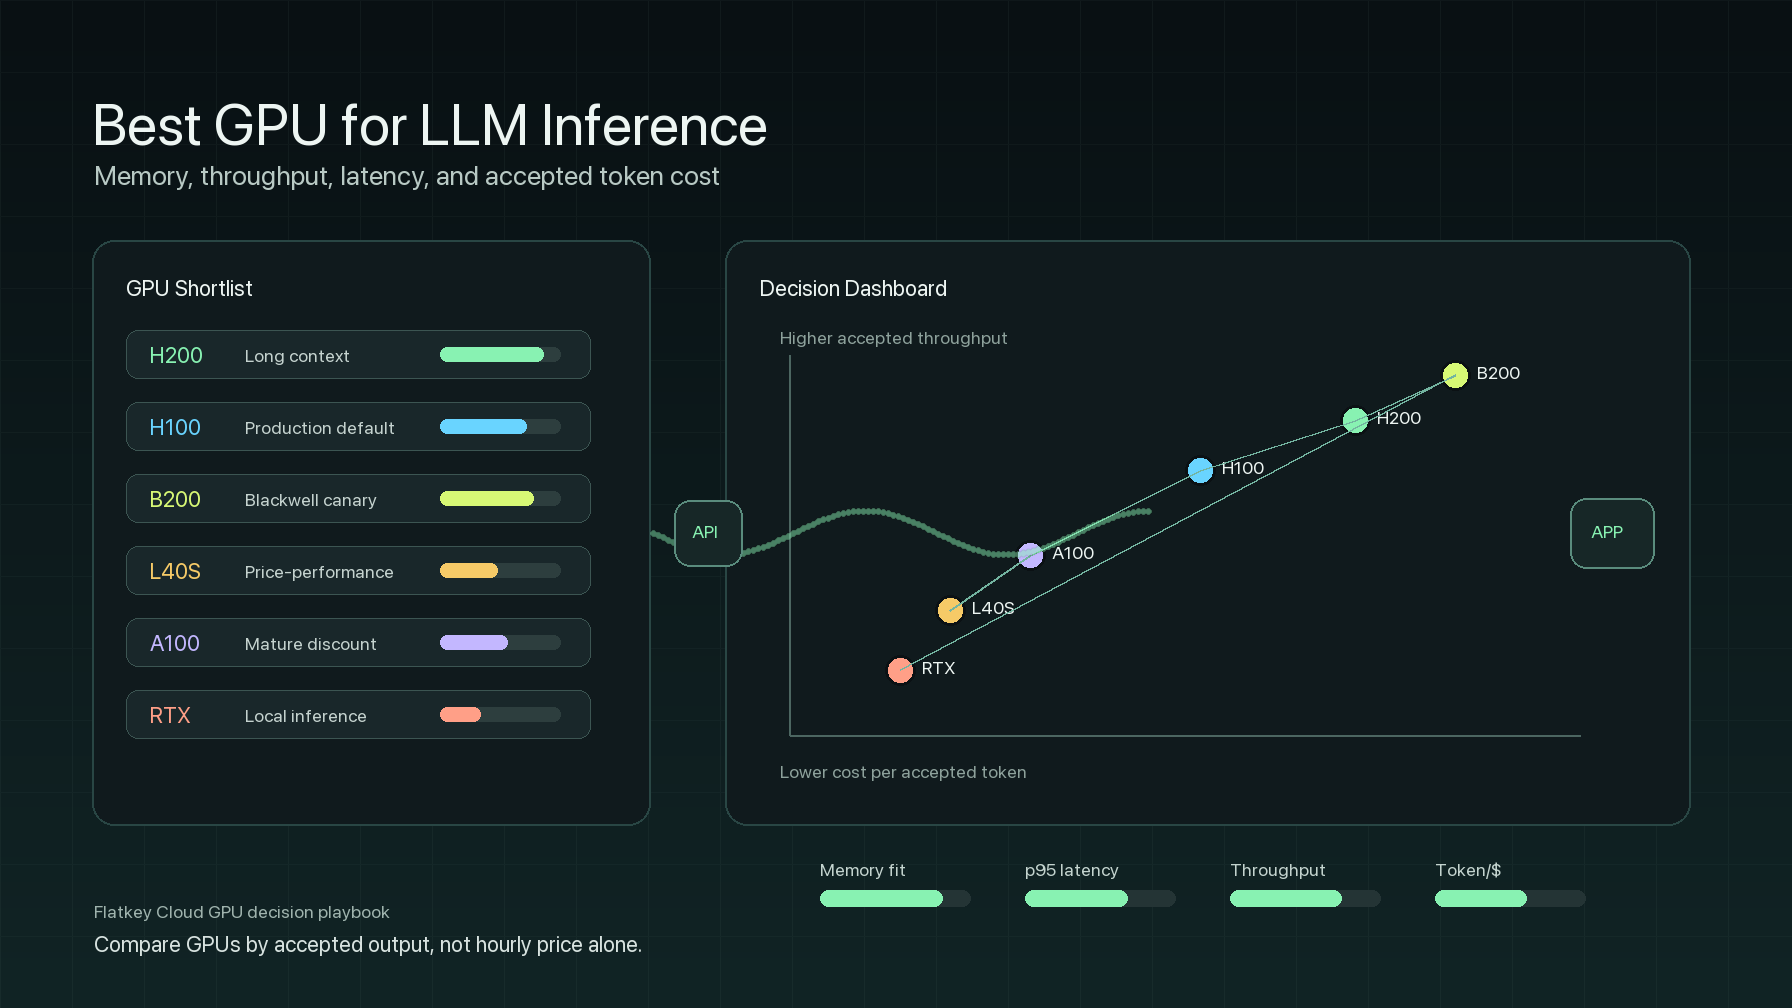
Melhor GPU para Inferência de LLM: Memória, Rendimento, Latência e Custo
Um guia prático de seleção de GPU para equipes empresariais de inferência de LLM, comparando H100, H200, B200, A100, L40S, GPUs locais da classe RTX, tokens por dólar, latência p95, adequação de memória e custo por token aceito.
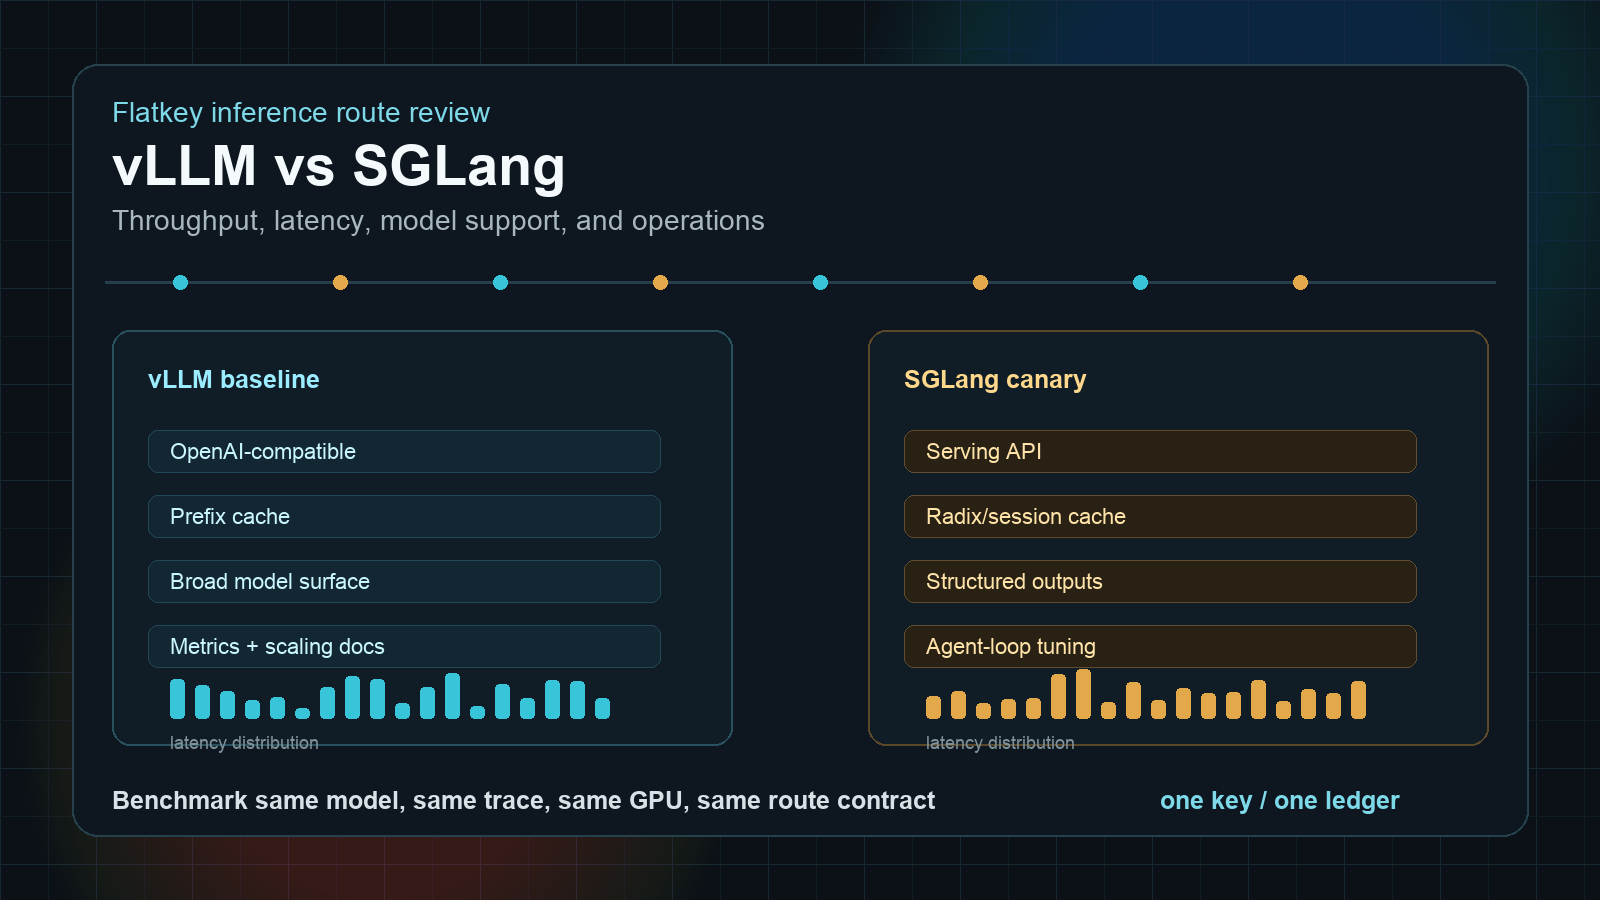
vLLM vs SGLang: Throughput, Latency, Model Support e Operações
Compare SGLang vs vLLM para inferência em GPU na nuvem: throughput, latência, suporte a modelos, operações, benchmarks e quando o Ollama se encaixa em testes locais.
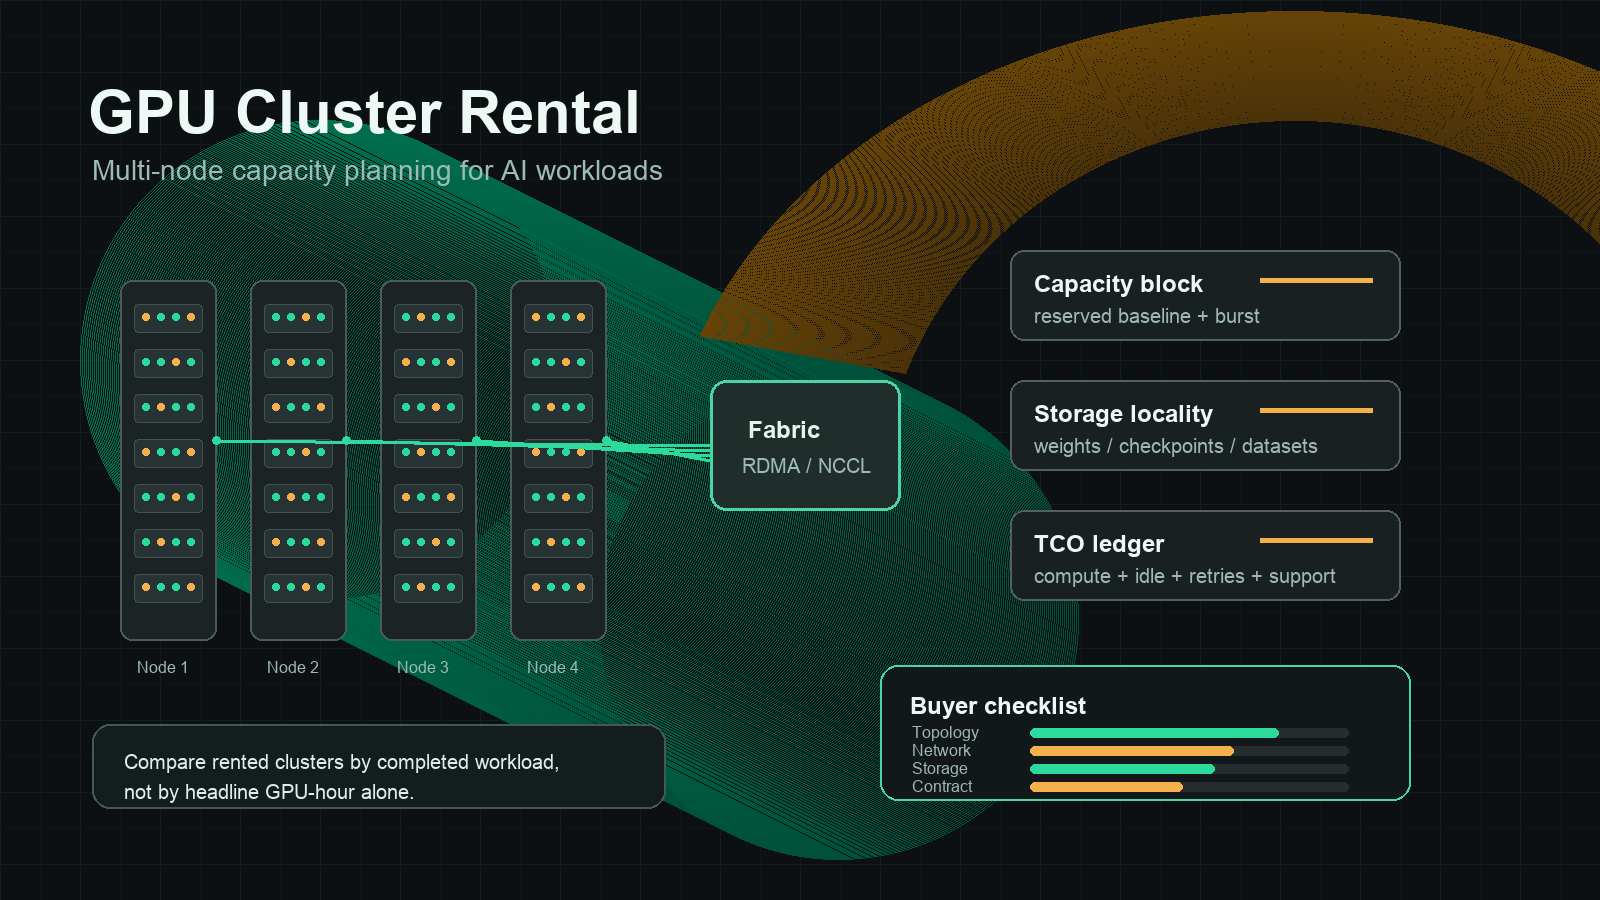
Aluguel de Cluster de GPU: Um Guia do Comprador para Capacidade de IA Multi-Nó
Um guia do comprador para equipes corporativas de IA que avaliam aluguel de cluster de GPU multi-nó, provedores de nuvem, capacidade reservada, rede, armazenamento e TCO.
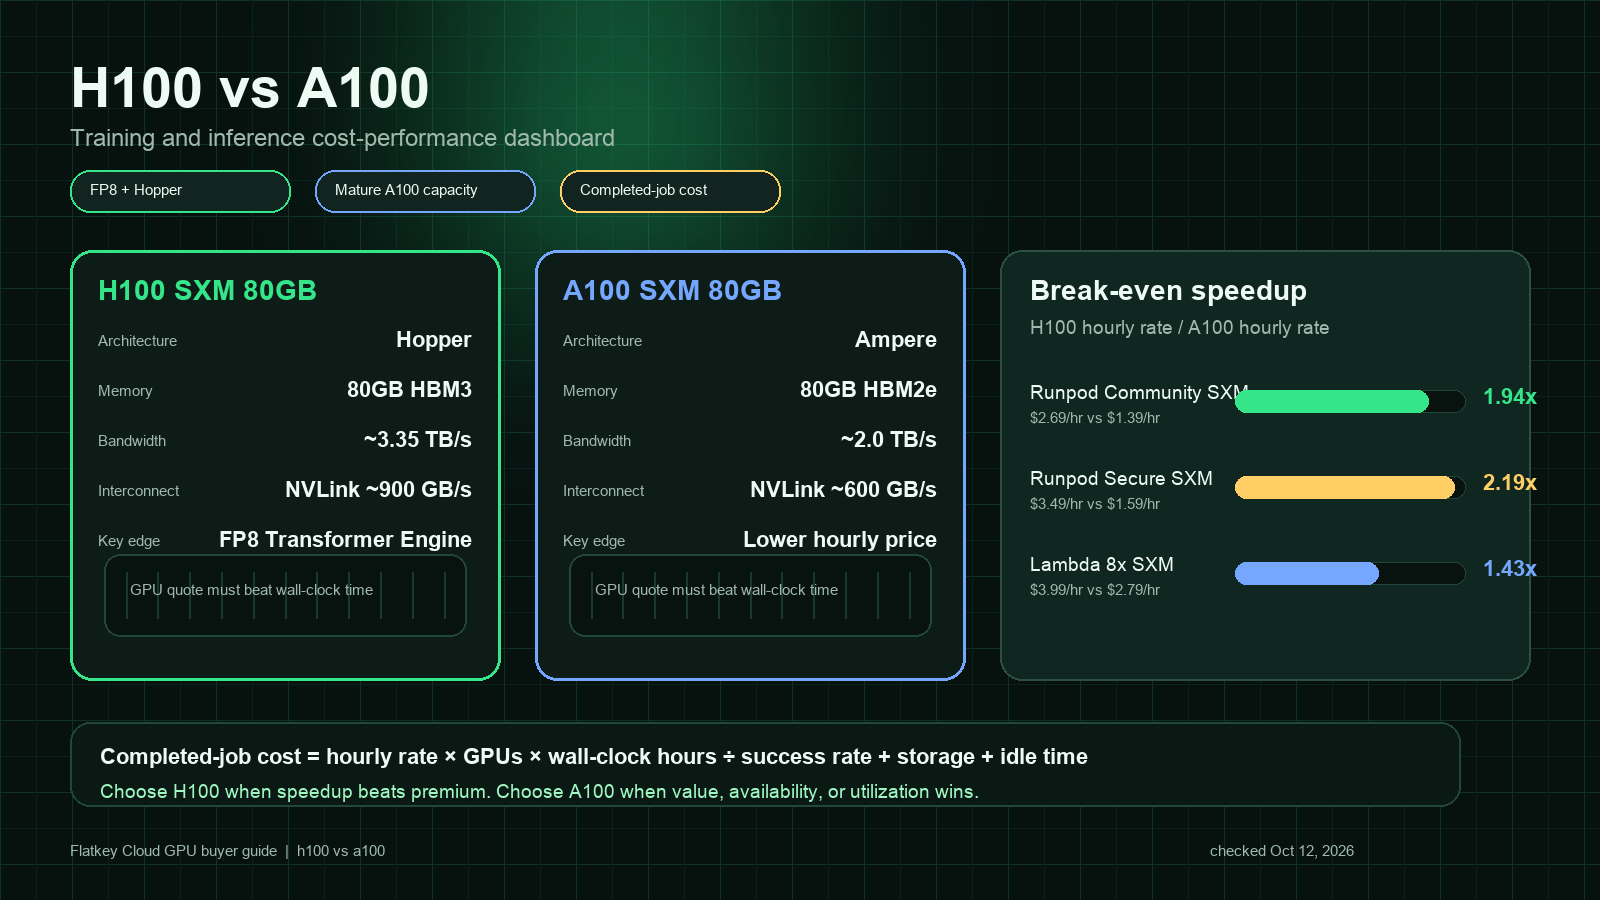
NVIDIA H100 vs A100: Custo-benefício em treinamento e inferência
Uma comparação prática entre H100 e A100 para equipes de IA que decidem entre o desempenho do Hopper e o valor do Ampere em treinamento, inferência e aluguel de GPUs na nuvem.

H200 vs H100 (2026): especificações, desempenho real, preço por hora e qual alugar
NVIDIA H200 vs H100 em 2026: especificações oficiais, a importância de 141GB para inferência de modelos de 70B, preços reais por hora da Flatkey Compute, RunPod e Lambda, alternativas Blackwell e a escolha por carga de trabalho.
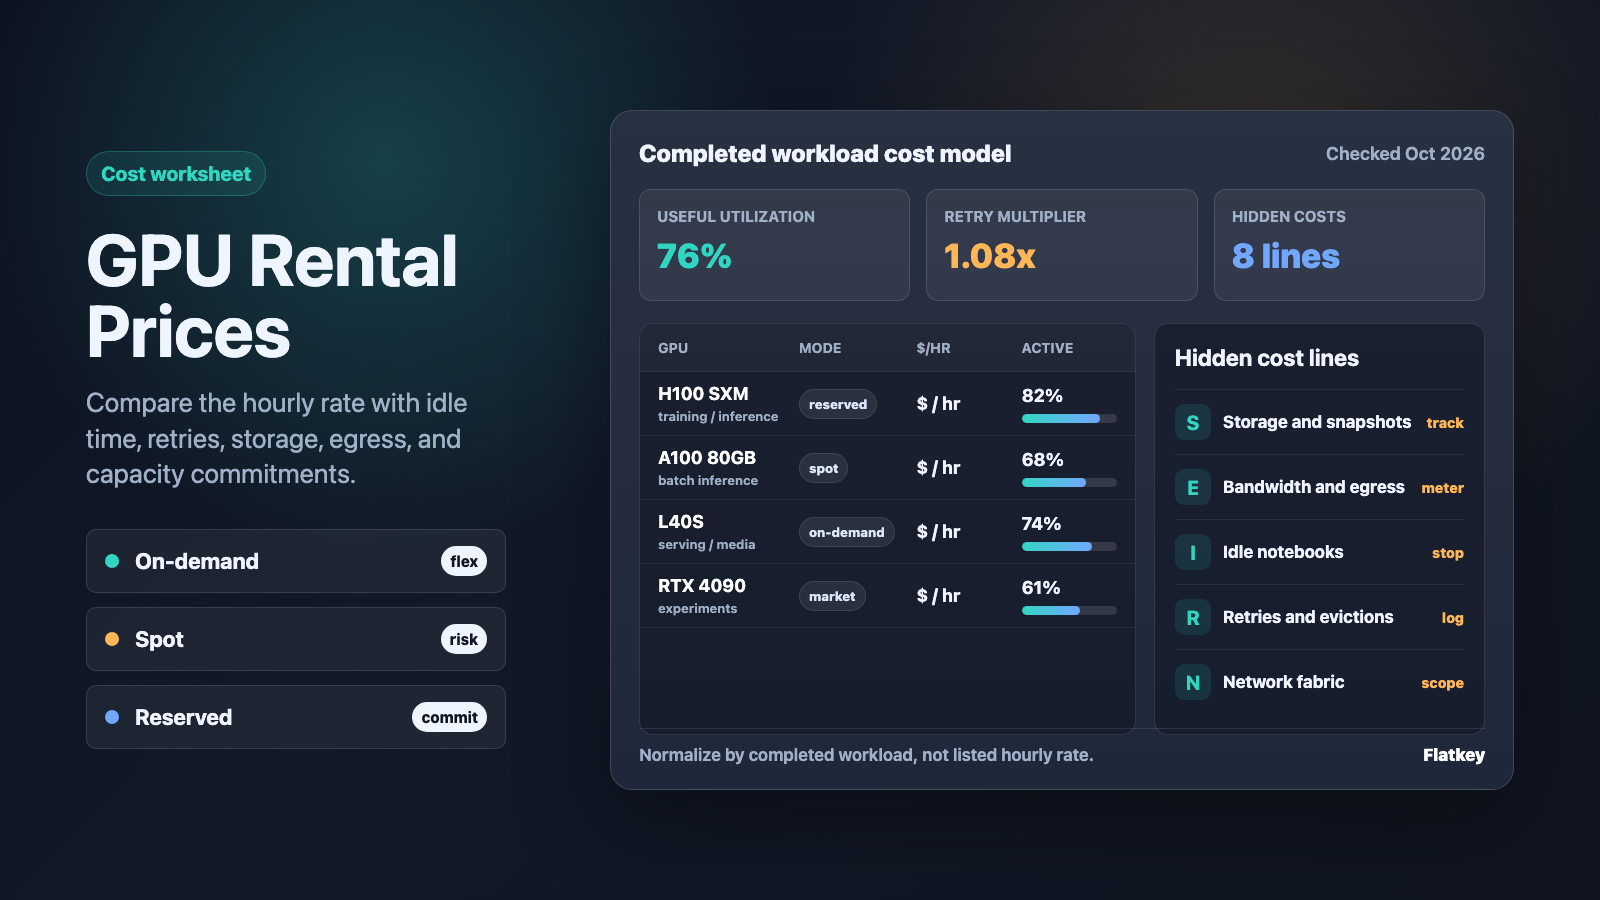
Preços de Aluguel de GPU Explicados: On-Demand, Spot, Reserved e Custos Ocultos
Um guia prático para comparar preços de aluguel de GPU pelo custo do trabalho concluído, e não apenas pelas taxas horárias, com verificações de fontes para modelos on-demand, spot, reserved, marketplace e de custos ocultos.
API de LLM grátis (2026): 10 opções comparadas por limites reais, modelos e pegadinhas
Dez APIs de LLM gratuitas conferidas na documentação oficial em outubro de 2026: o que é grátis, os limites exatos, as pegadinhas e código para alternar entre elas.

Comparação de Preços de Modelos de IA: Custos de Tokens, Imagens e Vídeos em um Só Painel
Compare preços de modelos de IA em fluxos de texto, imagem, vídeo e APIs de múltiplos provedores com um painel para custo por resultado aceito.
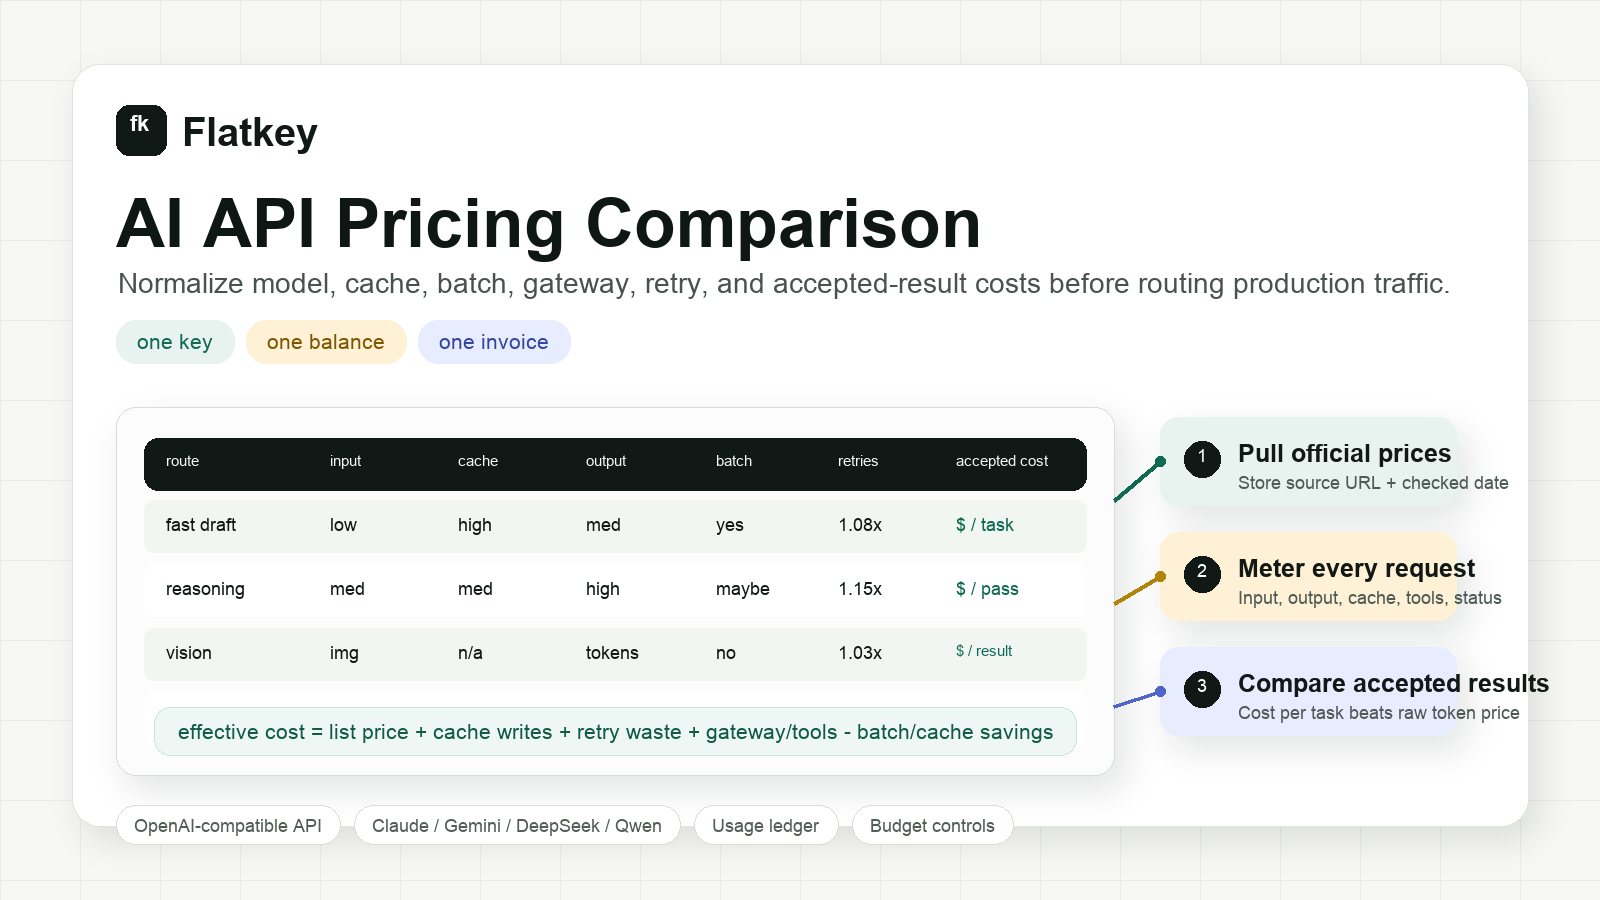
Comparação de Preços de API de IA: Custos de Modelo, Cache, Batch e Gateway
Uma estrutura prática de comparação de preços de API de IA para developers, product teams e procurement teams, comparando custos de modelo, cache, batch, gateway, retries e accepted-result.
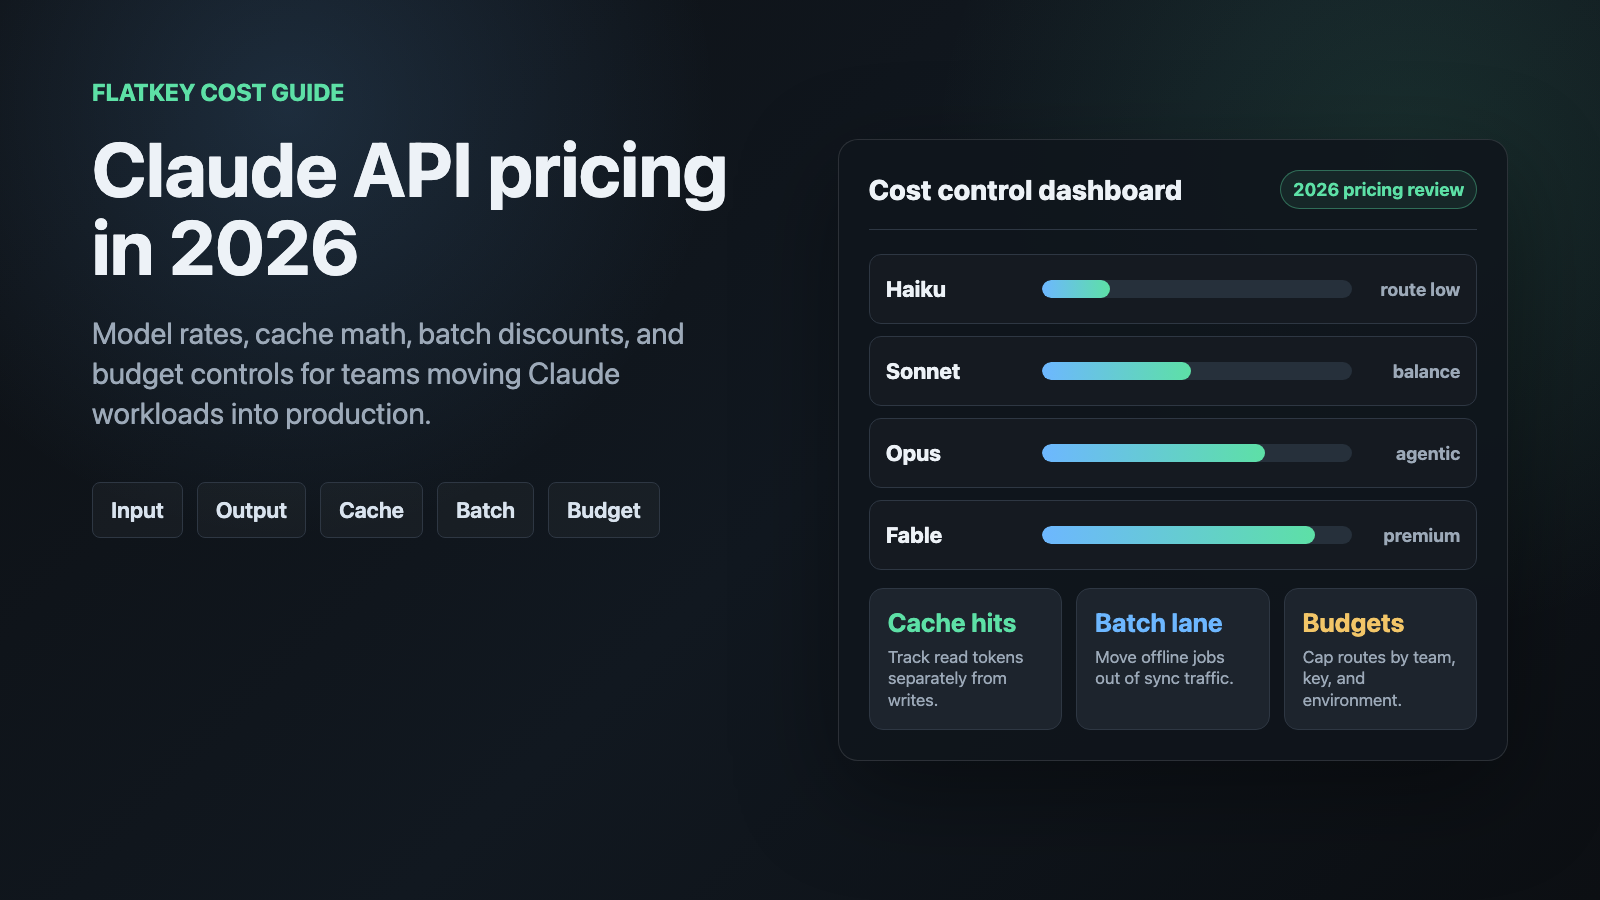
Qual modelo Claude é o melhor para programar? Opus 5.5 vs Sonnet 5.5 vs Haiku 5.5 vs Fable 5.1 (2026)
Qual modelo Claude usar para programar em 2026? Um guia por tarefa para Opus 5.5, Sonnet 5.5, Haiku 5.5 e Fable 5.1, com preços oficiais, cálculos de custo por sessão, aliases do Claude Code e exemplos executáveis de uso da API.
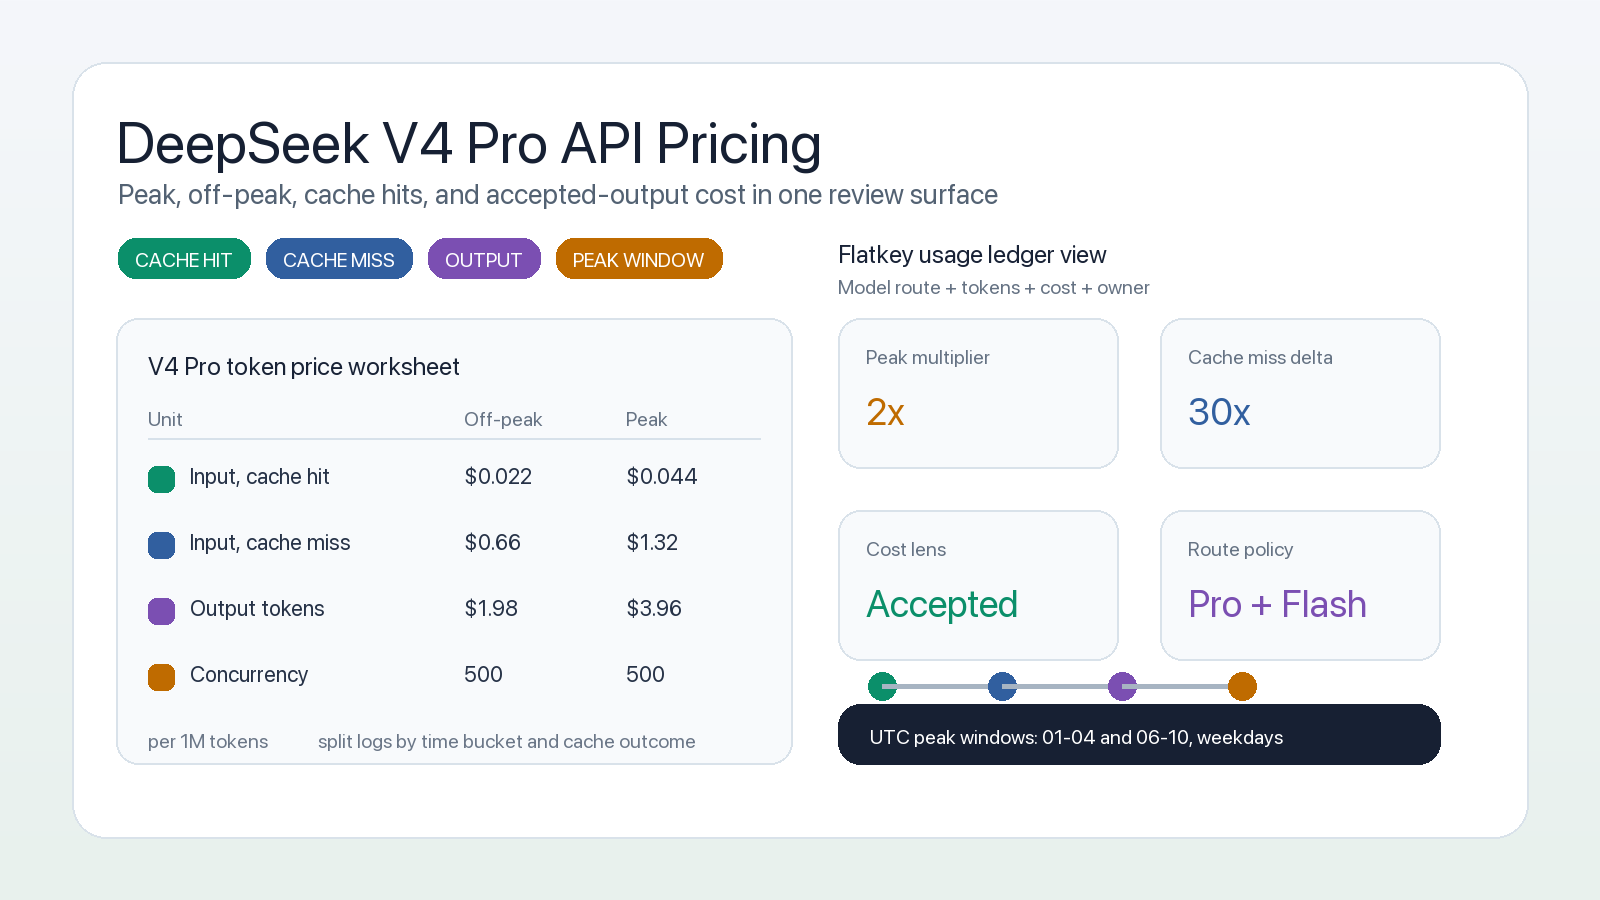
Preços da API DeepSeek V4 Pro: Pico, Fora de Pico e Custos de Cache
Preços atuais da API DeepSeek V4 Pro com tarifas de pico e fora de pico, cálculo de cache hit e uma planilha de controle de custos para desenvolvedores e equipes de compras.
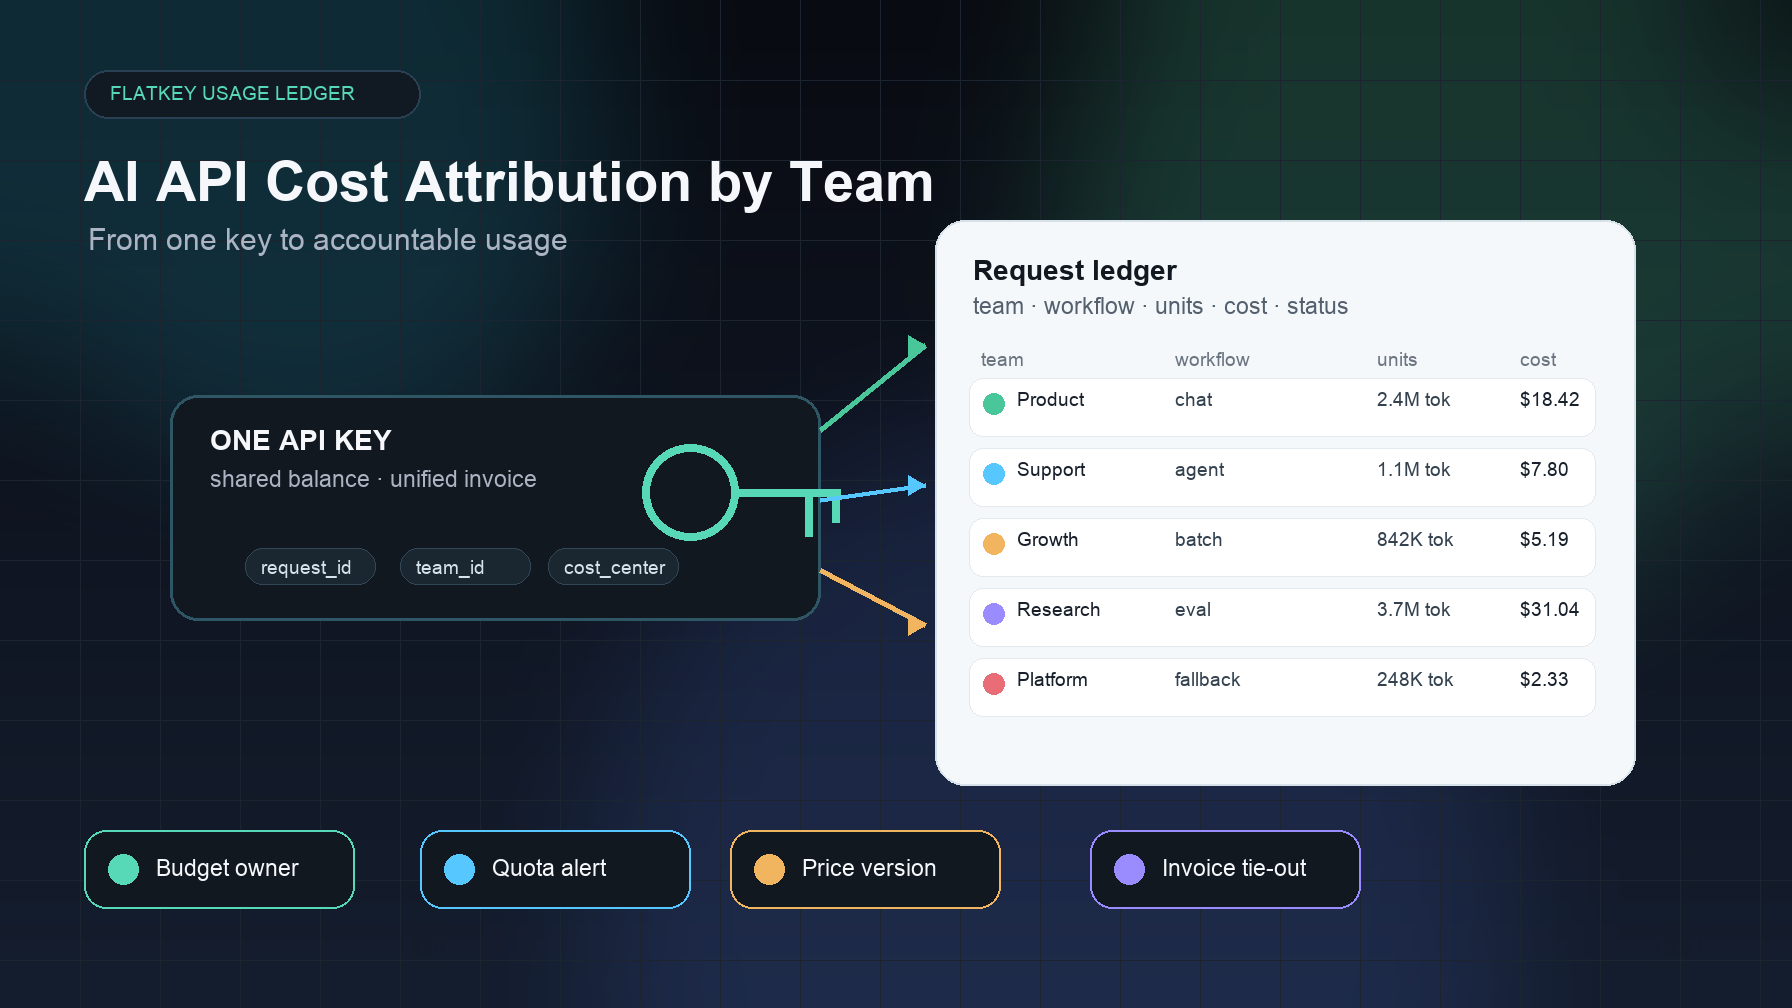
Atribuição de Custos de API de IA por Equipe: De uma Chave Única ao Uso Responsável
Crie a atribuição de custos de API de IA por equipe com tags de requisição, limites por subchave, livros-razão de uso, cotas e revisão financeira mensal.
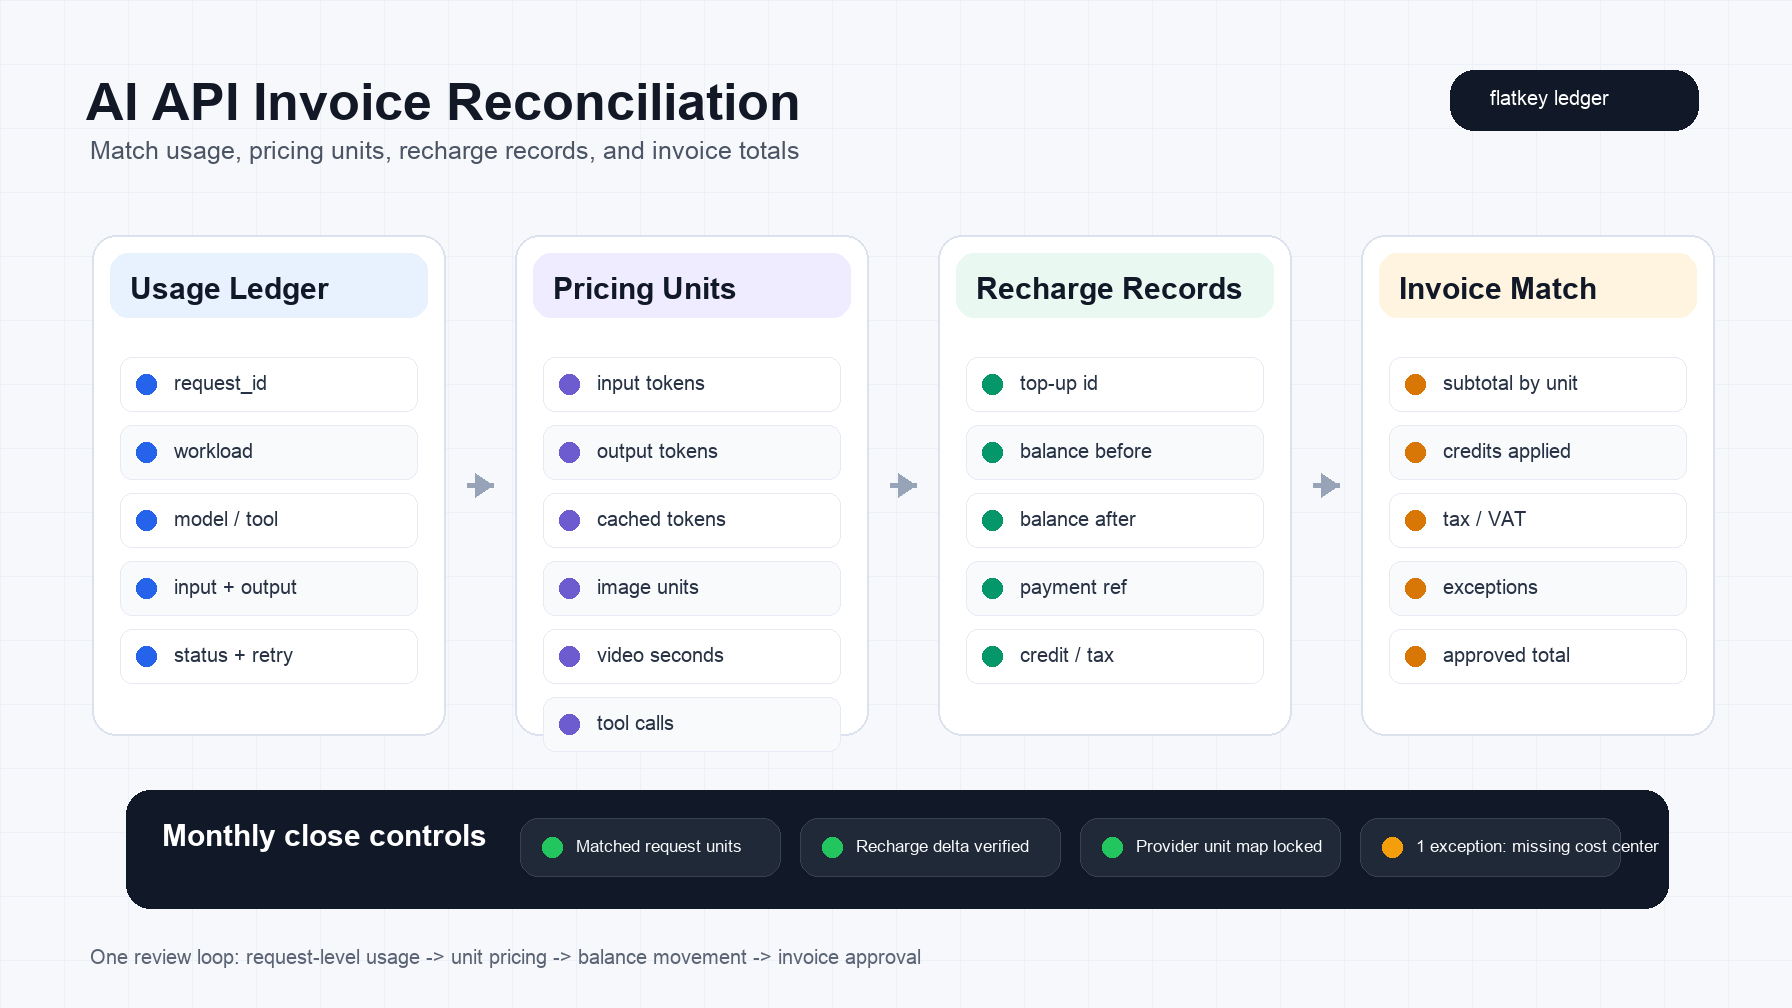
Reconciliação de Faturas da API de IA: Combine Uso, Unidades de Preço e Registros de Recarga
Reconcilie faturas da API de IA combinando registros de uso, unidades de preço, registros de recarga, movimentação de saldo, créditos, impostos e totais da fatura.

Preços da API da Anthropic (outubro de 2026): cada modelo Claude, cache, Batch e cálculo de custos
Todos os preços da API da Anthropic em outubro de 2026, do Haiku 5.5 a US$ 0,10/0,50 ao Fable 5.1 a US$ 10/50, com cache, Batch API, residência de dados, modo rápido, limites de gasto e orçamentos mensais.
Crie mais rápido com um único gateway de IA.
Use a flatkey.ai para gerenciar modelos, chaves, cobrança e observabilidade em uma plataforma de API.
Começar