
Serverless GPU vs Dedicated GPU: Biaya, Cold Start, dan Kontrol
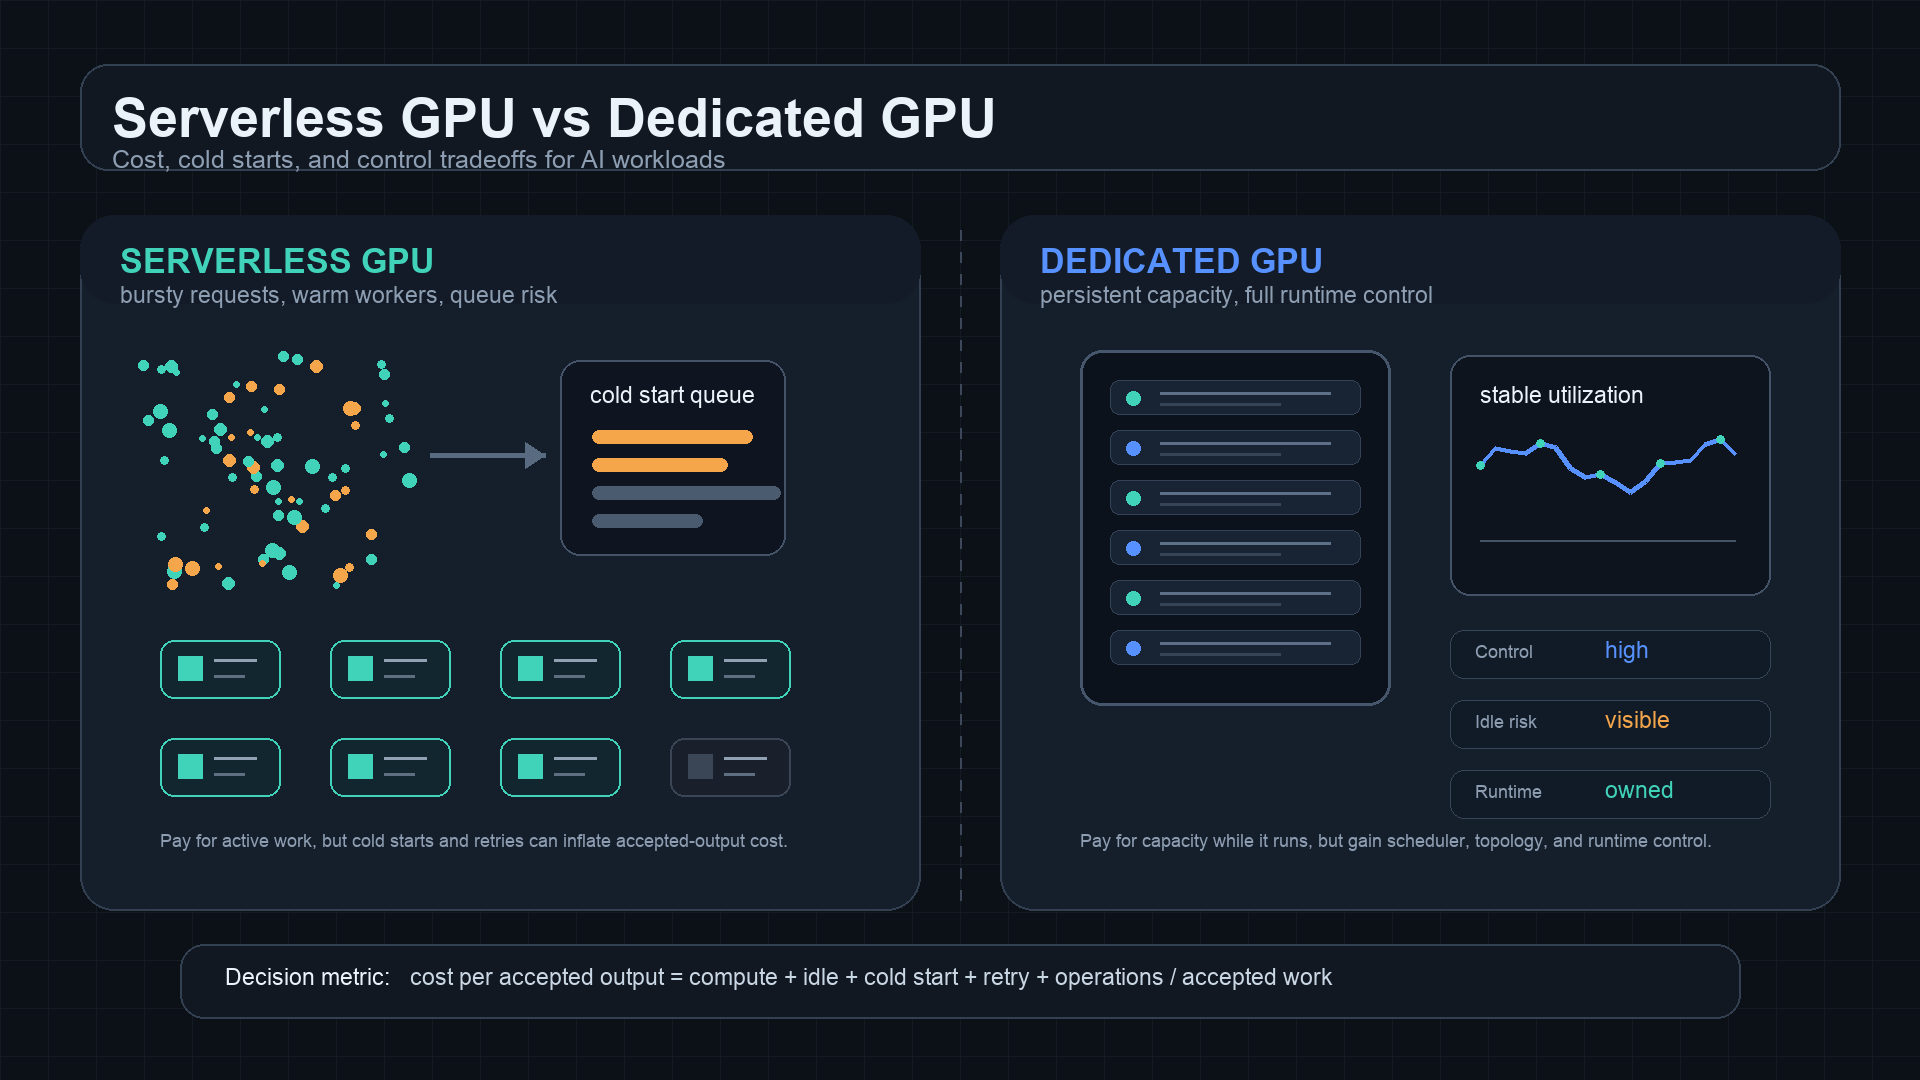
Memilih antara kapasitas serverless GPU vs dedicated GPU sebagian besar adalah soal bentuk beban kerja. Serverless GPU menarik ketika trafik bersifat bursty, eksperimen tidak merata, atau tim ingin menghindari hardware yang menganggur. Dedicated GPU menarik ketika permintaan stabil, latensi startup penting, atau tim membutuhkan kontrol atas driver, scheduler, networking, cache model, dan runtime serving.
Kesalahannya adalah membandingkan harga request serverless GPU dengan harga per jam dedicated GPU seolah-olah keduanya menggambarkan hal yang sama. Tidak demikian. Sebuah endpoint serverless dapat menyembunyikan cold start, delay antrean, batas concurrency, biaya retry, dan overhead per request. Sebuah dedicated GPU dapat menyembunyikan waktu idle, risiko kapasitas terpesan, storage, dukungan, dan pekerjaan platform engineering.
Untuk developer independen dan tim AI kecil, aturan praktisnya adalah:
serverless GPU vs dedicated GPU should be compared by cost per accepted output,
not by the lowest visible GPU rate.
Jika Anda masih memutuskan apakah sewa GPU langsung memang diperlukan, baca juga panduan Flatkey tentang GPU cloud vs model API, harga sewa GPU, dan biaya tersembunyi cloud GPU. Artikel ini berfokus pada pilihan serverless GPU vs dedicated GPU setelah GPU sudah masuk dalam set evaluasi.
Serverless GPU vs dedicated GPU: jawaban singkat
Gunakan tabel ini sebagai filter pertama.
| Decision point | Serverless GPU usually fits | Dedicated GPU usually fits |
|---|---|---|
| Traffic pattern | Bursty, queued, experimental, or uneven | Steady, high-volume, latency-sensitive, or capacity-planned |
| Billing shape | Pay mainly when workers run or requests execute, depending on provider | Pay while the instance, pod, node, cluster, or reservation exists |
| Startup risk | Cold starts, model loading, container pull, worker warmup, and queue delay | Less cold-start exposure after warmup, but idle capacity is billable |
| Operational control | Lower control over host, scheduler, runtime, topology, and caching | More control over drivers, serving stack, caches, topology, and observability |
| Reliability model | Provider-managed scaling with endpoint limits and possible cold paths | Team-managed uptime, autoscaling, failover, patches, and incident response |
| Best first use | Demos, image/video jobs, batch inference, sporadic APIs, prototypes | Stable inference endpoints, long-running services, custom runtimes, multi-node work |
Jawaban terbaik sering kali bertahap:
- Mulai dengan serverless GPU untuk permintaan yang belum diketahui.
- Ukur cold start, delay antrean, tingkat retry, dan biaya output yang diterima.
- Pindahkan hanya beban kerja yang stabil dan bervolume tinggi ke kapasitas dedicated GPU.
- Biarkan jalur model API tetap terbuka ketika produk membutuhkan banyak model atau tidak memerlukan kontrol hardware.
Urutan itu lebih aman daripada memesan dedicated GPU sebelum Anda tahu apakah beban kerja dapat membuatnya tetap sibuk.
Apa arti "serverless GPU" dalam praktik
Serverless GPU biasanya berarti penyedia mengabstraksikan kepemilikan server jangka panjang. Anda mengemas model, container, fungsi, atau endpoint; platform memulai worker GPU ketika request datang; dan platform dapat menaikkan atau menurunkan worker berdasarkan permintaan.
Implementasi provider bervariasi. RunPod menjelaskan Serverless seputar endpoint dan worker, dengan harga serverless terpisah dari harga pod. Modal mendokumentasikan fungsi GPU, cold start, dan lifecycle container. Google Cloud Run mendukung service dengan GPU dan memiliki model harga Cloud Run sendiri. Deployment Replicate mengekspos endpoint inferensi produksi yang dapat dikonfigurasi. Produk-produk ini tidak identik, jadi daftar periksa sumber sangat penting.
Dari sudut pandang pembeli, kapasitas serverless GPU berguna ketika:
- Volume request rendah, bursty, atau masih dalam proses ditemukan.
- Job dapat menunggu dalam antrean tanpa merusak pengalaman pengguna.
- Cold start dapat diterima atau dapat disamarkan.
- Tim menginginkan kepemilikan infrastruktur yang lebih sedikit.
- Beban kerja dikemas sebagai job berulang, bukan service yang selalu hangat.
- Bisnis lebih memilih pengeluaran berbasis penggunaan daripada taruhan kapasitas bulanan yang tetap.
Tradeoff tersembunyinya adalah serverless GPU tidak menghapus fisika. Bobot model tetap perlu dimuat. Container tetap perlu start. GPU tetap perlu kapasitas yang tersedia. Delay antrean tetap memengaruhi pengguna. Retry tetap menimbulkan biaya.
Apa arti "dedicated GPU" dalam praktik
Kapasitas dedicated GPU berarti Anda mengontrol instance, pod, server, node, atau cluster yang berjalan selama periode tertentu. Ini bisa berupa on-demand, reserved, committed, bare metal, kapasitas marketplace, atau cluster privat. Ciri umumnya adalah GPU dialokasikan untuk beban kerja Anda, bukan hanya dinyalakan di sekitar sebuah request.
Kapasitas dedicated GPU berguna ketika:
- Endpoint harus tetap hangat.
- Lalu lintas cukup dapat diprediksi untuk menjaga GPU tetap sibuk.
- Anda membutuhkan driver kustom, versi CUDA, kernel, server model, atau jaringan.
- Anda membutuhkan kondisi benchmark yang konsisten.
- Cold start akan mengganggu latensi atau pengalaman pengguna.
- Beban kerja bersifat multi-node, sensitif terhadap topologi, atau sensitif terhadap lokalitas data.
- Anda ingin menjalankan vLLM, SGLang, TensorRT-LLM, Triton, Ray Serve, Kubernetes, Slurm, atau infrastruktur serving kustom secara langsung.
Trade-off tersembunyi adalah kapasitas yang menganggur. Jika sebuah dedicated GPU berjalan selama 730 jam dalam sebulan tetapi hanya melakukan pekerjaan berguna selama 180 jam, harga per jam yang tercantum bukanlah harga per jam berguna yang sebenarnya. Jam-jam menganggur adalah bagian dari biaya workload.
Rumus biaya yang membuat perbandingan menjadi adil
Gunakan satu penyebut untuk kedua sisi:
biaya per output yang diterima =
  compute
  + storage
  + bandwidth
  + waktu menganggur
  + pemborosan cold start
  + pemborosan retry dan job gagal
  + dukungan
  + overhead engineering
  / output, record, token, gambar, klip, atau job yang diterima
Untuk serverless GPU:
biaya serverless GPU per output yang diterima =
  biaya worker/request yang ditagihkan
  + pemborosan cold start dan antrean
  + biaya request gagal dan retry
  + storage dan transfer artefak
  + overhead integrasi platform
  / output yang diterima
Untuk dedicated GPU:
biaya dedicated GPU per output yang diterima =
  biaya kapasitas GPU yang berjalan
  + storage dan jaringan
  + kapasitas menganggur
  + operasi stack serving
  + dukungan dan pekerjaan insiden
  + pemborosan kegagalan dan redeploy
  / output yang diterima
Di sinilah perbandingan serverless GPU vs dedicated GPU sering berbalik. Serverless bisa terlihat mahal per detik tetapi lebih murah secara keseluruhan jika menghindari GPU yang menganggur. Dedicated bisa terlihat mahal per bulan tetapi lebih murah secara keseluruhan jika workload menjaga akselerator tetap sibuk dan menghindari pemborosan cold start.
Cold start adalah pajak serverless GPU
Cold start adalah risiko serverless GPU yang paling penting. Cold start dapat mencakup:
- Mencari kapasitas GPU.
- Menarik atau me-mount image container.
- Mengimpor dependensi.
- Memuat bobot model.
- Memindahkan model ke memori GPU.
- Menghangatkan kernel atau jalur kompilasi.
- Membangun ulang cache.
- Menunggu di belakang request yang telah lebih dulu masuk antrean.
Dokumentasi cold-start Modal berguna karena memisahkan pekerjaan startup container, import, dan inisialisasi aplikasi. Mekanisme pastinya berbeda tergantung penyedia, tetapi pelajarannya tetap sama: waktu startup adalah bagian dari pengalaman pengguna dan model biaya.
Cold start paling penting ketika:
| Workload | Mengapa cold start merugikan |
|---|---|
| Chat interaktif atau agent | Pengguna menyadari latensi token pertama yang lambat. |
| Pengeditan gambar realtime | Request pertama bisa terasa rusak meskipun request berikutnya cepat. |
| Webhook atau API yang menghadap pengguna | Timeout dari upstream dapat mengubah cold start menjadi job gagal. |
| Antrian batch dengan SLA ketat | Keterlambatan antrean dapat melanggar jendela pengiriman. |
| Model besar | Pemuatan bobot dapat mendominasi jalur request. |
Serverless GPU tetap bisa menjadi pilihan yang tepat jika aplikasi dapat menyerap penundaan ini. Misalnya, job gambar offline, antrian evaluasi malam hari, inferensi batch asinkron, dan eksperimen internal sering kali lebih toleran terhadap warmup dibanding chat yang dihadapi pelanggan.
Dedicated GPU menukar cold start dengan risiko menganggur
Dedicated GPU biasanya mengurangi paparan cold start karena layanan dapat tetap hangat. Bobot model tetap termuat, cache tetap panas, dan routing request dapat menuju endpoint yang diketahui.
Namun kapasitas dedicated menciptakan pajak yang berbeda:
porsi pemborosan menganggur =
  1 - waktu GPU aktif yang berguna / waktu berjalan yang dapat ditagihkan
Jika porsi GPU aktif yang berguna adalah 30%, tarif per jam yang tercantum lebih rendah pun masih bisa menjadi mahal. Dedicated GPU mungkin secara teknis siap, tetapi secara finansial menganggur.
Dedicated GPU bekerja paling baik ketika Anda dapat membuktikan:
- Volume request dasar.
- Utilisasi GPU tinggi setelah batching dan antrean.
- Pilihan model yang stabil.
- Kebutuhan memori yang dapat diprediksi.
- Stack serving yang bisa dioperasikan tim.
- Rencana untuk rolling deploy, monitoring, alert, dan fallback.
Jika input tersebut belum diketahui, serverless GPU atau model API sering kali menjadi langkah awal yang lebih bersih.
Kontrol: apa yang diberikan kembali oleh dedicated GPU
Argumen terkuat untuk kapasitas dedicated GPU tidak selalu soal harga. Ini soal kontrol.
Kapasitas dedicated memberi tim lebih banyak kendali atas:
- Model GPU, memori, dan jumlah.
- Region dan lokalitas data.
- Versi CUDA, driver, kernel, dan image.
- vLLM, SGLang, TensorRT-LLM, Triton, Ray Serve, atau pengaturan runtime kustom.
- Continuous batching, perilaku KV cache, quantization, speculative decoding, dan tuning scheduler.
- Cache model lokal dan bobot yang sudah dimuat sebelumnya.
- Topologi jaringan, private link, desain VPC, load balancer, dan ingress.
- Observability, trace, log, dan respons insiden.
Kontrol itu bernilai ketika beban kerja cukup penting untuk membenarkan kepemilikan. Ini mahal ketika tim hanya membutuhkan output model yang andal.
Ini adalah batas yang sama yang dibahas dalam artikel Flatkey GPU terbaik untuk inferensi LLM, panduan deployment vLLM, dan vLLM vs SGLang. Jika Anda sedang men-tune runtime itu sendiri, kapasitas GPU dedicated mungkin menjadi lapisan yang tepat. Jika Anda meluncurkan fitur produk di banyak model, jalur API terkelola mungkin lebih cepat.
Matriks keputusan beban kerja
Gunakan matriks ini sebelum membuat spreadsheet.
| Beban kerja | Titik awal yang lebih baik | Alasannya |
|---|---|---|
| Fitur produk AI baru dengan permintaan yang belum diketahui | Serverless GPU atau API model | Menghindari pembelian kapasitas yang menganggur sebelum traffic diketahui. |
| Antrian generasi gambar asinkron | Serverless GPU | Penundaan antrian mungkin dapat diterima, dan lonjakan tidak memerlukan GPU yang selalu aktif. |
| Demo atau prototipe singkat | Serverless GPU | Pengaturan cepat dan penagihan berdasarkan pola penggunaan biasanya lebih penting daripada kontrol runtime. |
| Inferensi LLM stabil dengan volume tinggi | Dedicated GPU | Pemanfaatan yang berkelanjutan dapat mengamortisasi stack serving. |
| Endpoint pelanggan yang sensitif terhadap latensi | Dedicated GPU atau API model | Cold start dan penundaan antrian lebih sulit disembunyikan. |
| Model besar dengan pemuatan bobot yang lambat | Dedicated GPU | Menjaga bobot tetap hangat bisa lebih baik daripada startup serverless berulang. |
| Suite evaluasi periodik | Serverless GPU, spot GPU, atau batch model API | Job dapat dicoba ulang dan dapat berjalan di belakang antrian. |
| Kernel CUDA kustom atau riset runtime | Dedicated GPU | Tim membutuhkan kontrol tingkat rendah. |
| Pelatihan multi-node atau inferensi terdistribusi | Cluster dedicated | Topologi, fabric jaringan, dan domain kegagalan menjadi faktor utama. |
| Produk yang membutuhkan banyak model frontier | API model atau gateway | Kepemilikan GPU secara langsung tidak menyelesaikan akses model lintas penyedia. |
Untuk perencanaan kapasitas yang lebih luas, padukan ini dengan panduan Flatkey GPU on-demand vs spot, TCO cluster GPU, dan sewa cluster GPU.
Jebakan biaya serverless GPU
Ekonomi serverless GPU bisa mengecewakan ketika tim mengabaikan field-field ini.
| Jebakan | Yang terjadi | Kontrol |
|---|---|---|
| Pemuatan model yang lambat | Setiap worker cold menghabiskan waktu yang ditagihkan sebelum pekerjaan berguna dimulai | Prepackage artefak, perkecil image, cache bobot, ukur warmup secara terpisah |
| Ketidaksesuaian timeout | Cold start memicu timeout upstream dan retry | Atur timeout yang realistis, antrian asinkron, ID job idempotent |
| Opasitas antrian | Pengguna melihat penundaan tetapi dashboard hanya menampilkan request yang selesai | Lacak waktu tunggu antrian, waktu cold start, waktu aktif worker, dan latensi output yang diterima |
| Job kecil di GPU besar | Overhead per request mendominasi komputasi yang berguna | Batch pekerjaan atau gunakan model yang lebih kecil/rute API |
| Batas concurrency saat lonjakan | Request menumpuk selama jendela peluncuran | Load test concurrency endpoint sebelum peluncuran |
| Amplifikasi retry | Job yang gagal memperbanyak percobaan yang ditagihkan | Lacak output yang diterima, bukan output yang dicoba |
| Transfer data | Input, bobot, dan output berpindah berulang kali | Jaga artefak tetap dekat dengan worker dan hapus file sementara |
Pertanyaan pengadaan bukanlah "apakah penyedia mendukung serverless GPU?" Melainkan "apa yang terjadi pada biaya per output yang diterima ketika worker cold, antrian penuh, dan retry terjadi?"
Jebakan biaya dedicated GPU
Ekonomi dedicated GPU bisa mengecewakan ke arah sebaliknya.
| Jebakan | Yang terjadi | Kontrol |
|---|---|---|
| Endpoint menganggur | GPU tetap hangat untuk request yang jarang | Autoscale, konsolidasikan beban kerja, atau gunakan serverless/API model untuk volume rendah |
| Memori yang overprovisioned | GPU besar menjalankan beban kerja yang muat di hardware lebih kecil | Benchmark memori model dan throughput sebelum berkomitmen |
| Ketidaksesuaian reservasi | Kontrak mengasumsikan permintaan yang tidak pernah muncul | Reservasi berdasarkan baseline terukur, bukan proyeksi peluncuran |
| Kepemilikan stack serving | Engineer memelihara runtime alih-alih fitur produk | Hitung pekerjaan platform dalam TCO |
| Baris cloud tersembunyi | Storage, egress, support, dan networking berada di luar tarif GPU | Gunakan worksheet biaya tersembunyi cloud GPU yang lengkap |
| Perubahan model | Family model baru mengubah memori, presisi, atau kebutuhan runtime | Tetap buka jalur keluar |
| Beban insiden | Uptime menjadi masalah tim Anda | Definisikan alert, fallback, dan cakupan dukungan penyedia |
Kontrol dedicated GPU bernilai hanya ketika tim dapat memanfaatkannya. Jika beban kerja tidak cukup stabil untuk ditune, kontrol tambahan itu bisa menjadi beban operasional.
Contoh terapan: mengapa jawabannya berubah dengan utilisasi
Asumsikan sebuah tim menjalankan fitur generasi media asinkron. Tarif persisnya bersifat hipotetis; gantikan dengan harga penyedia yang sudah diverifikasi sebelum membeli.
| Bidang | Serverless GPU | Dedicated GPU |
|---|---|---|
| Job yang diterima per bulan | 120,000 | 120,000 |
| Compute yang tercantum | Berbentuk penggunaan | Kapasitas bulanan tetap |
| Cold start dan pemborosan antrian | Lebih tinggi | Lebih rendah |
| Kapasitas menganggur | Lebih rendah | Lebih tinggi |
| Kontrol runtime | Lebih rendah | Lebih tinggi |
| Risiko terbaik | Permintaan tidak diketahui | Permintaan stabil |
Jika sebagian besar job datang dalam ledakan singkat dan sisa hari relatif sepi, serverless GPU bisa unggul karena menghindari kapasitas dedicated yang menganggur. Jika job datang stabil sepanjang hari dan model memiliki jalur warmup yang lambat, dedicated GPU bisa unggul karena worker tetap hangat dan throughput lebih mudah diatur.
Sekarang ubah beban kerja menjadi inferensi LLM yang berhadapan langsung dengan pelanggan dengan latensi ketat. Keputusan bisa berbalik bahkan jika serverless terlihat lebih murah pada trafik rendah, karena jalur cold-start dan penundaan antrean menciptakan risiko produk. Dalam kasus itu, dedicated GPU atau API model terkelola dengan kontrol latensi yang sudah mapan mungkin lebih aman.
Poinnya bukan bahwa satu model selalu menang. Poinnya adalah serverless GPU vs dedicated GPU harus diputuskan berdasarkan bentuk beban kerja yang terukur.
Rencana benchmark sebelum memilih
Jalankan beban kerja yang sama melalui kedua jalur untuk jendela pengujian yang representatif. Lacak metrik berikut.
| Metrik | Jalur serverless GPU | Jalur dedicated GPU |
|---|---|---|
| Output yang diterima | Hitung output berhasil setelah filter kualitas | Penyebut yang sama |
| Output yang dicoba | Sertakan job yang gagal dan diulang | Sertakan job yang gagal dan diulang |
| Latensi p50 / p95 / p99 | Sertakan waktu antre dan cold-start | Sertakan waktu routing dan batching |
| Waktu hingga pekerjaan berguna pertama | Startup worker, pemuatan model, warmup | Mulai deploy, pemuatan model, rollout |
| Porsi cold start | Persentase request yang mengenai worker dingin | Biasanya lebih rendah setelah warmup |
| Waktu tunggu antrian | Delay antre endpoint dan tekanan konkurensi | Antrian scheduler dan tunggu batch |
| Pemanfaatan GPU | Waktu aktif worker jika terekspos | Pemanfaatan komputasi dan memori GPU |
| Biaya menganggur | Biasanya lebih rendah, tetapi periksa minimum | Risiko biaya utama |
| Tingkat retry | Timeout, error worker, error kapasitas | OOM, deploy, runtime, error host |
| Jam engineering | Integrasi dan debugging endpoint | Operasi platform dan pekerjaan insiden |
Pengujian harus mencakup kondisi dingin, kondisi hangat, trafik ledakan, trafik normal, dan pemulihan dari kegagalan. Benchmark yang hanya mengukur throughput hangat bukanlah keputusan serverless GPU vs dedicated GPU; itu hanyalah tes kecepatan parsial.
Daftar periksa sumber penyedia
Gunakan halaman resmi sebagai daftar periksa sumber, bukan kartu tarif yang dibekukan. Periksa ulang pada hari Anda menyetujui pengeluaran.
| Penyedia/kategori | Sumber resmi yang harus diperiksa | Yang perlu dicatat |
|---|---|---|
| RunPod Serverless | Ikhtisar RunPod Serverless, Harga RunPod Serverless | Model endpoint, perilaku worker, basis penagihan, perilaku cold-start, penyimpanan, jaringan, konkurensi, log, batasan |
| RunPod Pods / gaya dedicated | Ikhtisar RunPod Pods, Harga RunPod Pods, Harga RunPod | Model GPU, mode secure/community, penagihan pod, penyimpanan, volume jaringan, ekspektasi uptime |
| Modal | Dokumentasi GPU Modal, Cold start Modal, Harga Modal | Tipe GPU, siklus hidup fungsi, kontrol cold-start, strategi image container, penagihan penggunaan aktif |
| Google Cloud Run dengan GPU | Konfigurasi GPU Cloud Run, Harga Cloud Run | Batasan layanan GPU, min instances, konkurensi, penagihan CPU/memori/GPU, dampak latensi request |
| Google Compute Engine GPU | Harga GPU Compute Engine | Tipe GPU, region, biaya VM, disk, jaringan, reservasi, diskon committed use |
| Instans GPU AWS EC2 | Harga Amazon EC2 | On-Demand, Spot, Savings Plans, Reserved Instances, capacity block, penyimpanan, transfer data, dukungan |
| Lambda Cloud | Lambda GPU Cloud | Tipe instans, ketersediaan, ketentuan on-demand/reserved, penyimpanan, jaringan, cakupan dukungan |
| Deployment Replicate | Dokumentasi deployment Replicate | Pengaturan deployment, perilaku scaling, opsi hardware, jumlah instans minimum/maksimum, kesesuaian endpoint produksi |
Untuk artikel ini, daftar periksa sumber telah ditinjau pada 13 Oktober 2026.
Pertanyaan pengadaan sebelum Anda berkomitmen
Tanyakan ini sebelum memilih serverless GPU vs dedicated GPU.
| Pertanyaan | Mengapa ini penting |
|---|---|
| What is the accepted-output denominator? | Mencegah perbandingan antara percobaan request dan hasil bisnis yang berhasil. |
| How often will the endpoint be cold? | Cold start dapat mendominasi latensi dan biaya untuk beban kerja yang sporadis. |
| How long does model loading take? | Bobot model yang besar dapat menghapus penghematan serverless. |
| What happens at burst concurrency? | Antrian serverless dan autoscaler dedicated sama-sama perlu diuji stres. |
| What is the dedicated GPU idle rate? | Kapasitas menganggur adalah kebocoran biaya tetap utama. |
| Can jobs retry safely? | Workflow serverless dan seperti spot membutuhkan idempotensi. |
| Do we need custom runtime control? | Jika tidak, kepemilikan dedicated GPU mungkin tidak diperlukan. |
| Are storage, egress, logs, and support included? | Komputasi GPU hanya satu bagian dari tagihan. |
| Can the workload move to a model API? | Produk dengan utilisasi rendah atau multi-model mungkin tidak membenarkan operasi GPU. |
| What is the exit path if the model changes? | Komitmen perangkat keras menjadi berisiko ketika arsitektur model berubah. |
Paket pengadaan terbaik mencakup hasil benchmark, lembar kerja biaya per accepted output, dan alasan yang jelas mengapa tim membutuhkan kapasitas serverless GPU berbasis penggunaan atau kapasitas dedicated GPU yang terkontrol.
Kapan model API mengalahkan keduanya
Baik serverless GPU maupun dedicated GPU mengasumsikan bahwa beroperasi di lapisan GPU itu bermanfaat. Terkadang tidak.
Model API atau gateway yang dikelola bisa lebih baik ketika:
- Permintaan tidak diketahui atau bersifat bursty.
- Produk membutuhkan beberapa model, bukan satu model self-hosted yang stabil.
- Tim membutuhkan model frontier atau proprietary.
- Keandalan, fallback, dan keberagaman provider lebih penting daripada kontrol host.
- Keuangan membutuhkan pembukuan penggunaan, anggaran, dan satu invoice.
- Waktu engineering lebih baik dipakai untuk perilaku produk daripada operasi GPU.
Flatkey cocok untuk sisi keputusan ini. Ini memberi tim satu jalur yang kompatibel dengan OpenAI, satu key, satu saldo, satu invoice, visibilitas penggunaan, dan akses ke endpoint model resmi lintas provider. Jika lembar kerja serverless GPU vs dedicated GPU menunjukkan utilisasi rendah, pemborosan cold start yang tinggi, atau overhead operasional yang terlalu besar, bandingkan jalur itu dengan perbandingan harga model AI, perbandingan harga API AI, dan manajemen pengeluaran API AI sebelum berkomitmen pada infrastruktur GPU.
Rekomendasi akhir
Gunakan urutan ini untuk keputusan serverless GPU vs dedicated GPU:
- Gunakan serverless GPU untuk prototipe, job bursty, antrean async, dan permintaan yang belum diketahui.
- Ukur cold start, delay antrean, tingkat retry, dan biaya per accepted output.
- Pindahkan beban kerja yang stabil, bervolume tinggi, dan sensitif latensi ke kapasitas dedicated GPU hanya setelah utilisasi terbukti.
- Biarkan jalur model API tetap terbuka ketika pilihan model sering berubah, kontrol hardware tidak diperlukan, atau tim membutuhkan penagihan dan fallback yang lebih rapi.
Serverless GPU vs dedicated GPU bukanlah pilihan universal yang menang mutlak. Serverless GPU membeli fleksibilitas dan risiko idle yang lebih rendah. Dedicated GPU membeli kontrol dan kapasitas yang lebih hangat. Jawaban yang tepat adalah yang memberi tim Anda biaya per accepted output terendah sambil menempatkan latensi, keandalan, dan risiko operasional di tempat yang benar-benar dapat Anda kelola.
Pertanyaan yang sering diajukan
Apakah serverless GPU lebih murah daripada dedicated GPU?
Serverless GPU lebih murah ketika trafik rendah, bursty, atau tidak pasti sehingga dedicated GPU akan banyak menganggur. Dedicated GPU lebih murah ketika utilisasi tinggi, model tetap hangat, dan tim dapat mengoperasikan serving stack secara efisien.
Apakah serverless GPU selalu mengalami cold start?
Tidak setiap request akan cold, dan provider menawarkan kontrol yang berbeda untuk kapasitas hangat, worker minimum, optimasi image, dan scaling. Namun cold start adalah risiko inti dalam evaluasi serverless GPU karena model dan container yang besar bisa membutuhkan waktu yang berarti sebelum berguna.
Kapan saya harus pindah dari serverless GPU ke dedicated GPU?
Pindah ketika Anda dapat membuktikan permintaan yang stabil, utilisasi tinggi, latensi cold start yang tidak dapat diterima, kebutuhan akan kontrol runtime kustom, atau keunggulan biaya per accepted output setelah menghitung operasi dan waktu idle.
Apakah dedicated GPU lebih baik untuk inferensi LLM?
Dedicated GPU bisa lebih baik untuk inferensi LLM bervolume tinggi yang stabil, terutama ketika Anda men-tuning vLLM, SGLang, TensorRT-LLM, batching, perilaku cache, dan pemuatan model. Untuk produk bervolume rendah, multi-model, atau yang berubah cepat, model API bisa lebih sederhana dan lebih murah.
Apa yang harus saya ukur terlebih dahulu?
Ukur accepted outputs, porsi cold start, waktu tunggu antrean, latensi p95/p99, tingkat retry, utilisasi GPU yang berguna, biaya idle, storage/egress, dan jam engineering. Metrik-metrik tersebut membuat keputusan serverless GPU vs dedicated GPU dapat dipertanggungjawabkan.


