
Blog de flatkey.ai
Ideas, notas de producto y guías de implementación para equipos que crean sobre APIs de IA.
Arquitectura de pasarelas de IA
Últimos artículos en Arquitectura de pasarelas de IA.
Leer másMigración de URL base y SDK
Últimos artículos en Migración de URL base y SDK.
Leer másCostes, facturación y operaciones
Últimos artículos en Costes, facturación y operaciones.
Leer másControles empresariales y confianza
Últimos artículos en Controles empresariales y confianza.
Leer másComparativas de pasarelas
Últimos artículos en Comparativas de pasarelas.
Leer másGuías de modelos y modalidades
Últimos artículos en Guías de modelos y modalidades.
Leer másFiabilidad y enrutamiento
Últimos artículos en Fiabilidad y enrutamiento.
Leer másIntegraciones de herramientas
Últimos artículos en Integraciones de herramientas.
Leer más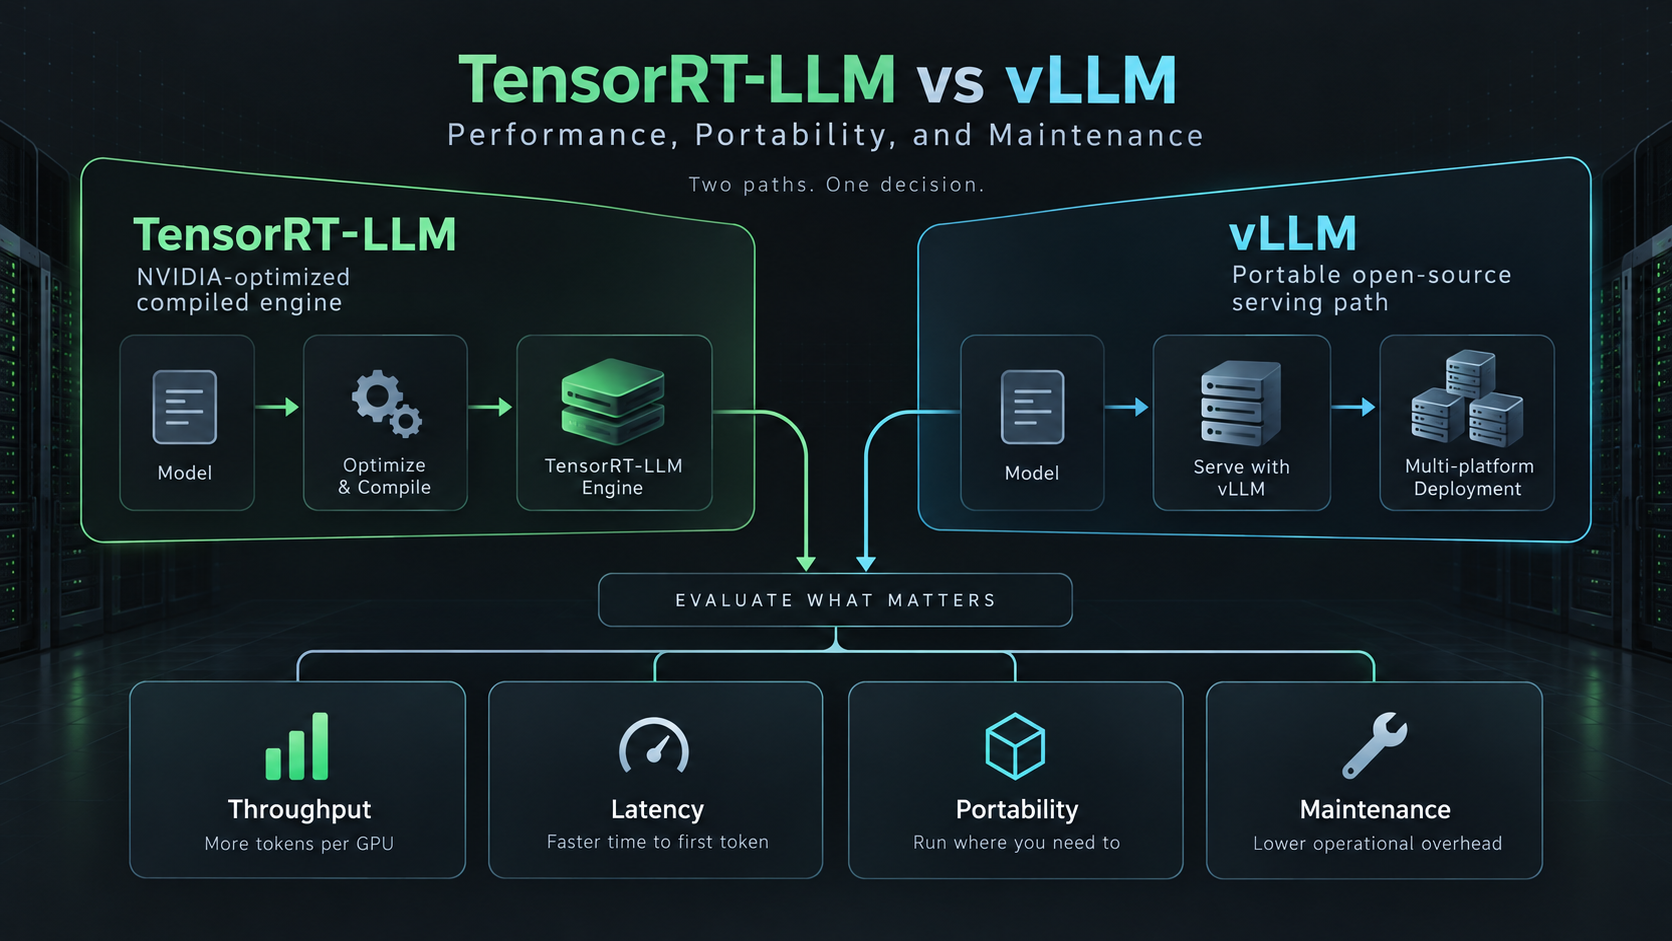
TensorRT-LLM vs vLLM: Rendimiento, portabilidad y mantenimiento
Una comparación práctica de TensorRT-LLM vs vLLM para equipos de infraestructura de IA que eligen un motor de serving de LLM en función del rendimiento, la portabilidad, el mantenimiento y el diseño de benchmarks.
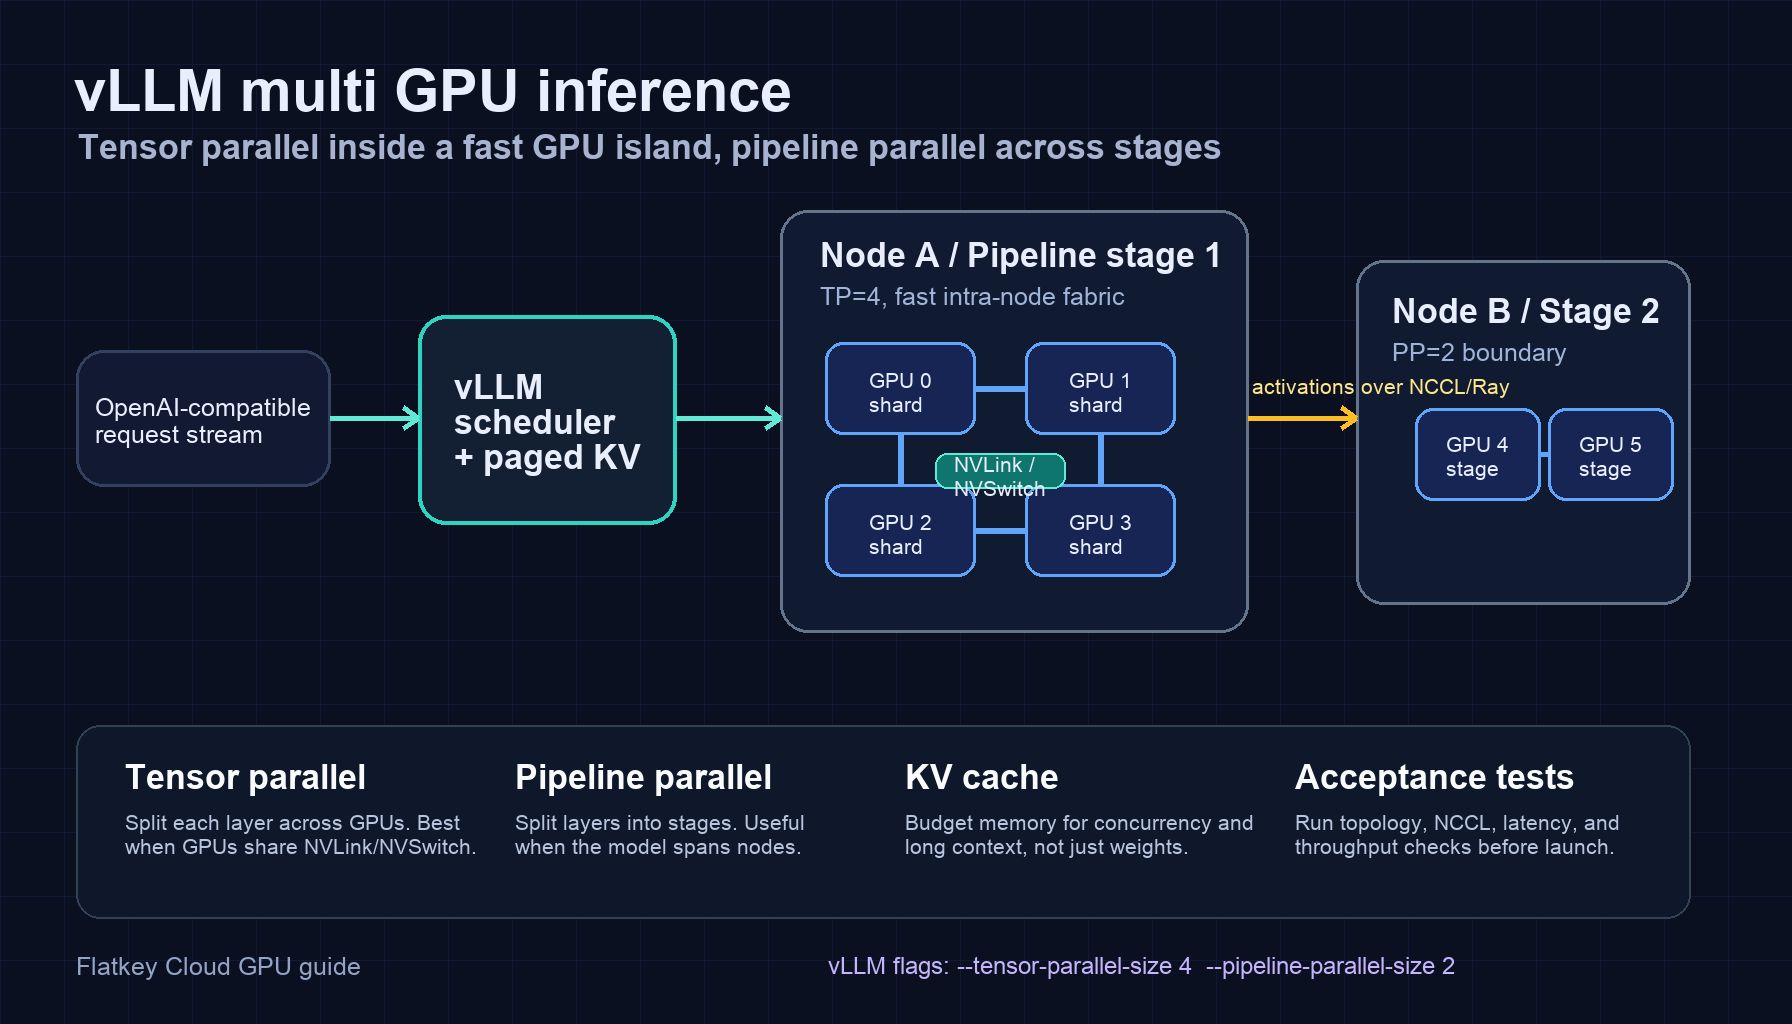
Inferencia multi-GPU de vLLM: configuración de paralelismo tensorial y de canalización
Configura la inferencia multi-GPU con vLLM mediante paralelismo tensorial, paralelismo de canalización, Ray, comprobaciones de topología, ejemplos y pruebas en producción.
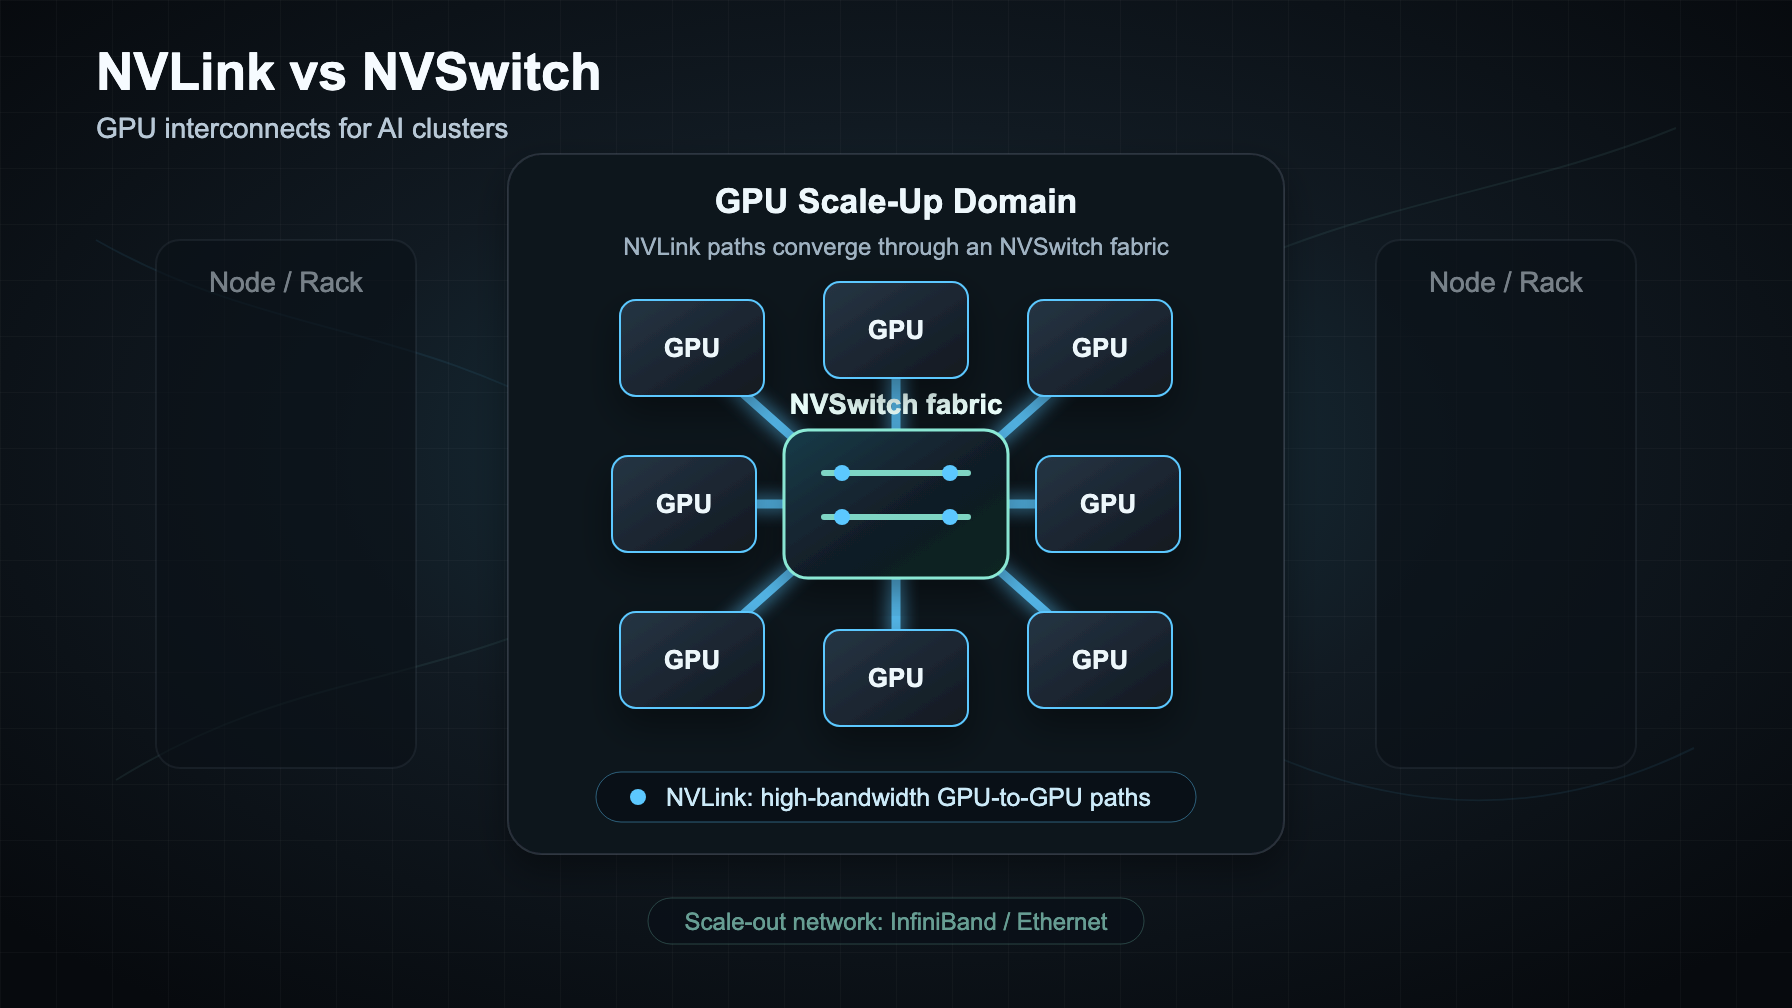
NVLink vs NVSwitch: Interconexiones de GPU explicadas para clústeres de IA
NVLink es el enlace GPU a GPU, NVSwitch es el tejido, e InfiniBand o Ethernet es la red de escalado horizontal. Aquí se explica cómo elegir para clústeres de IA.
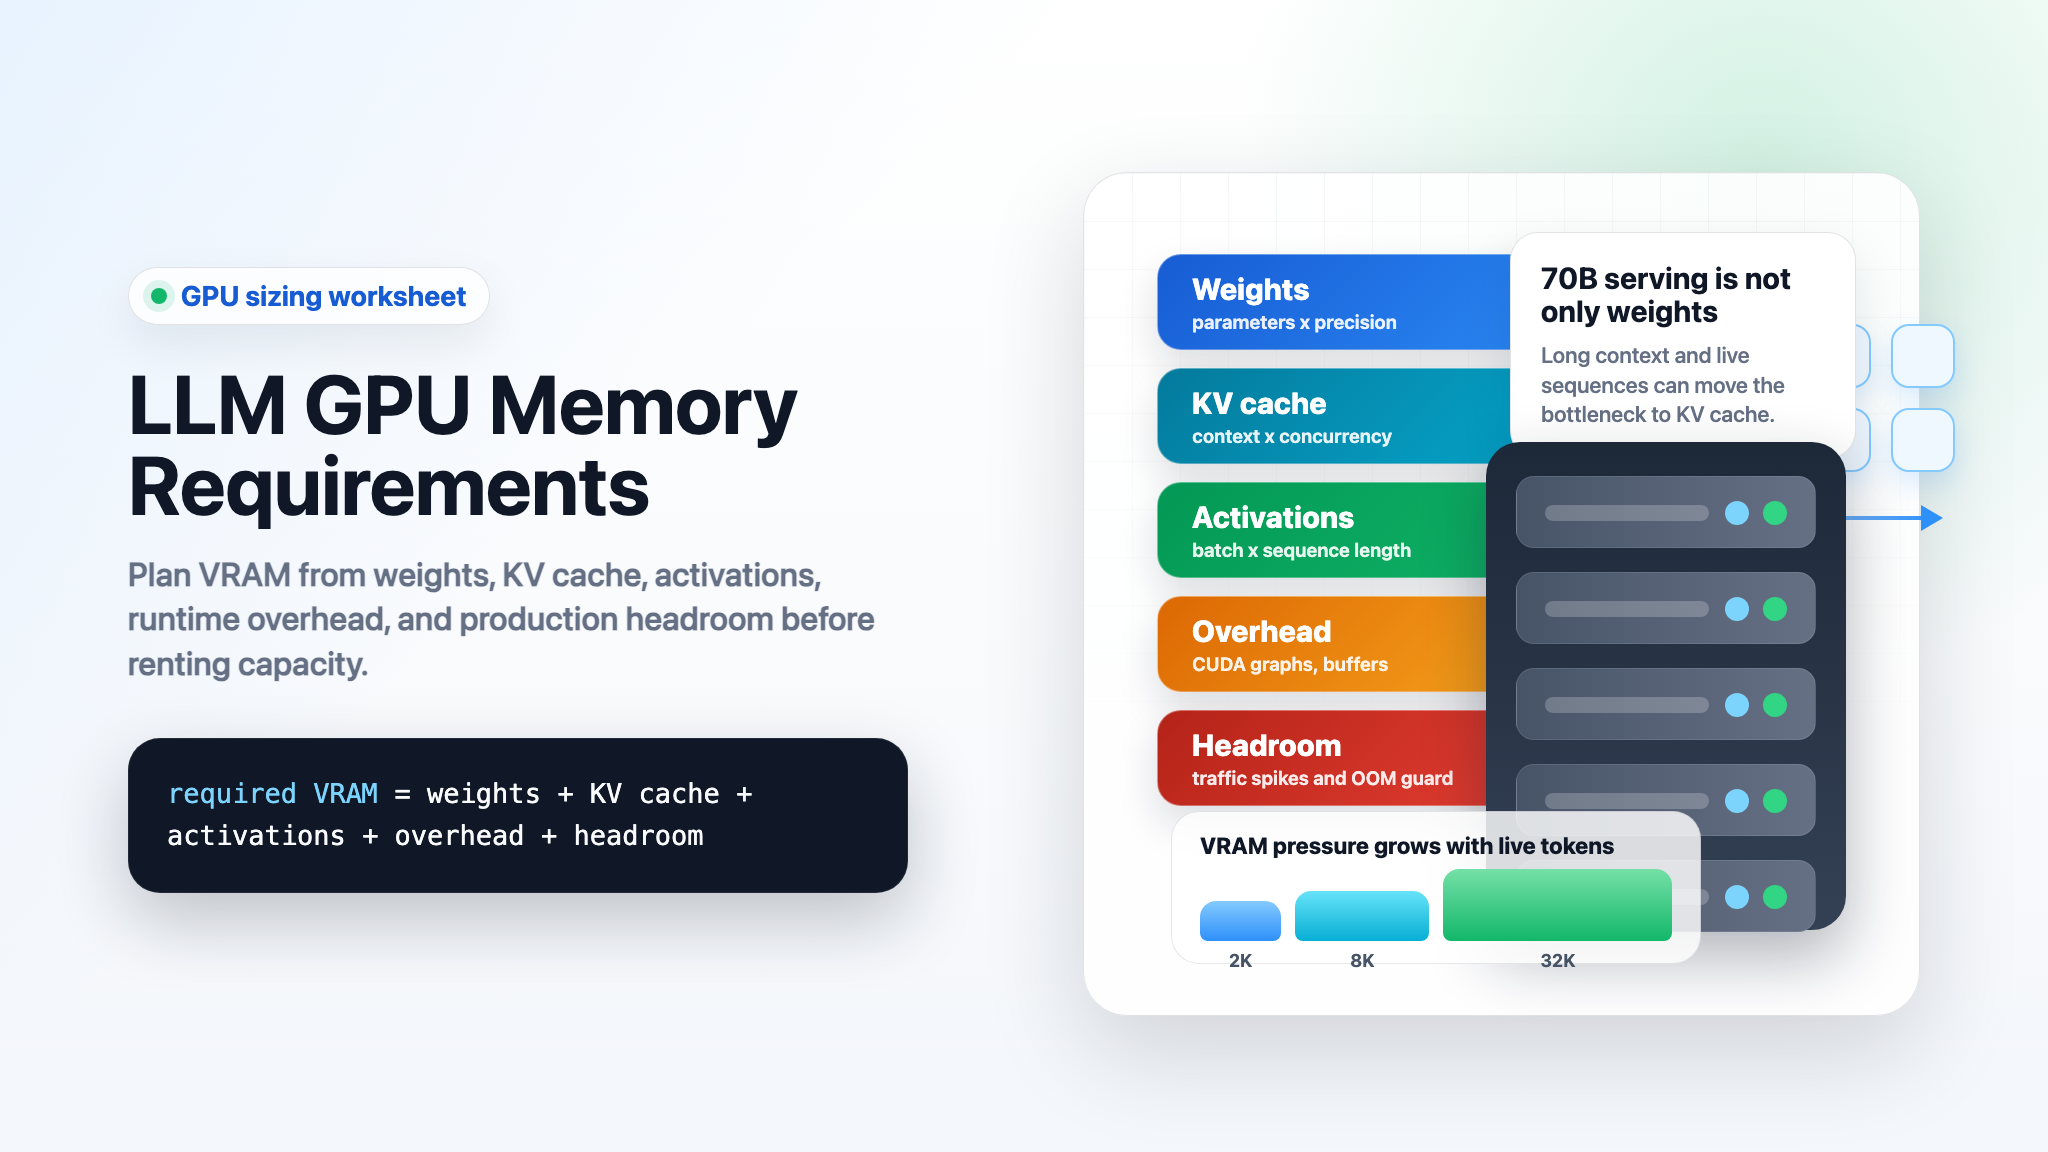
Requisitos de memoria GPU para LLM: pesos, caché KV, activaciones y sobrecarga
Una hoja de trabajo práctica para estimar los requisitos de memoria GPU de LLM en pesos, caché KV, activaciones, sobrecarga de servicio, planificación de vLLM 70B, fine-tuning y entrenamiento.
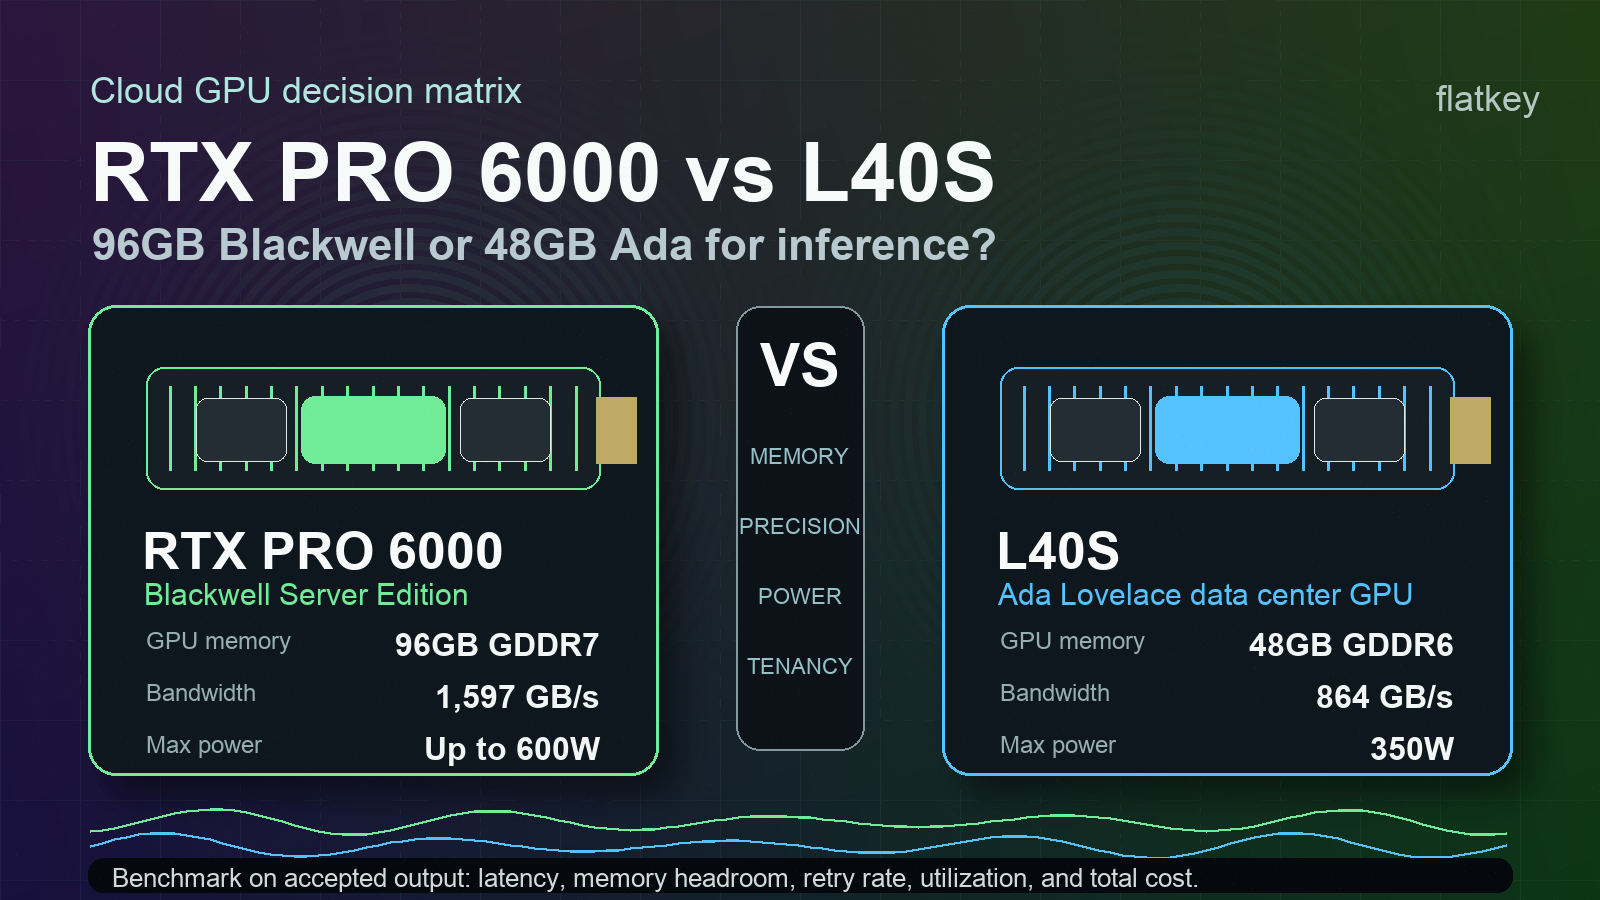
RTX PRO 6000 vs L40S: ¿GPU de inferencia Blackwell de 96 GB o Ada?
Compara NVIDIA L40S vs RTX PRO 6000 Blackwell Server Edition para inferencia de LLM, cargas multimodales, ajuste de memoria, consumo y coste por output aceptado.
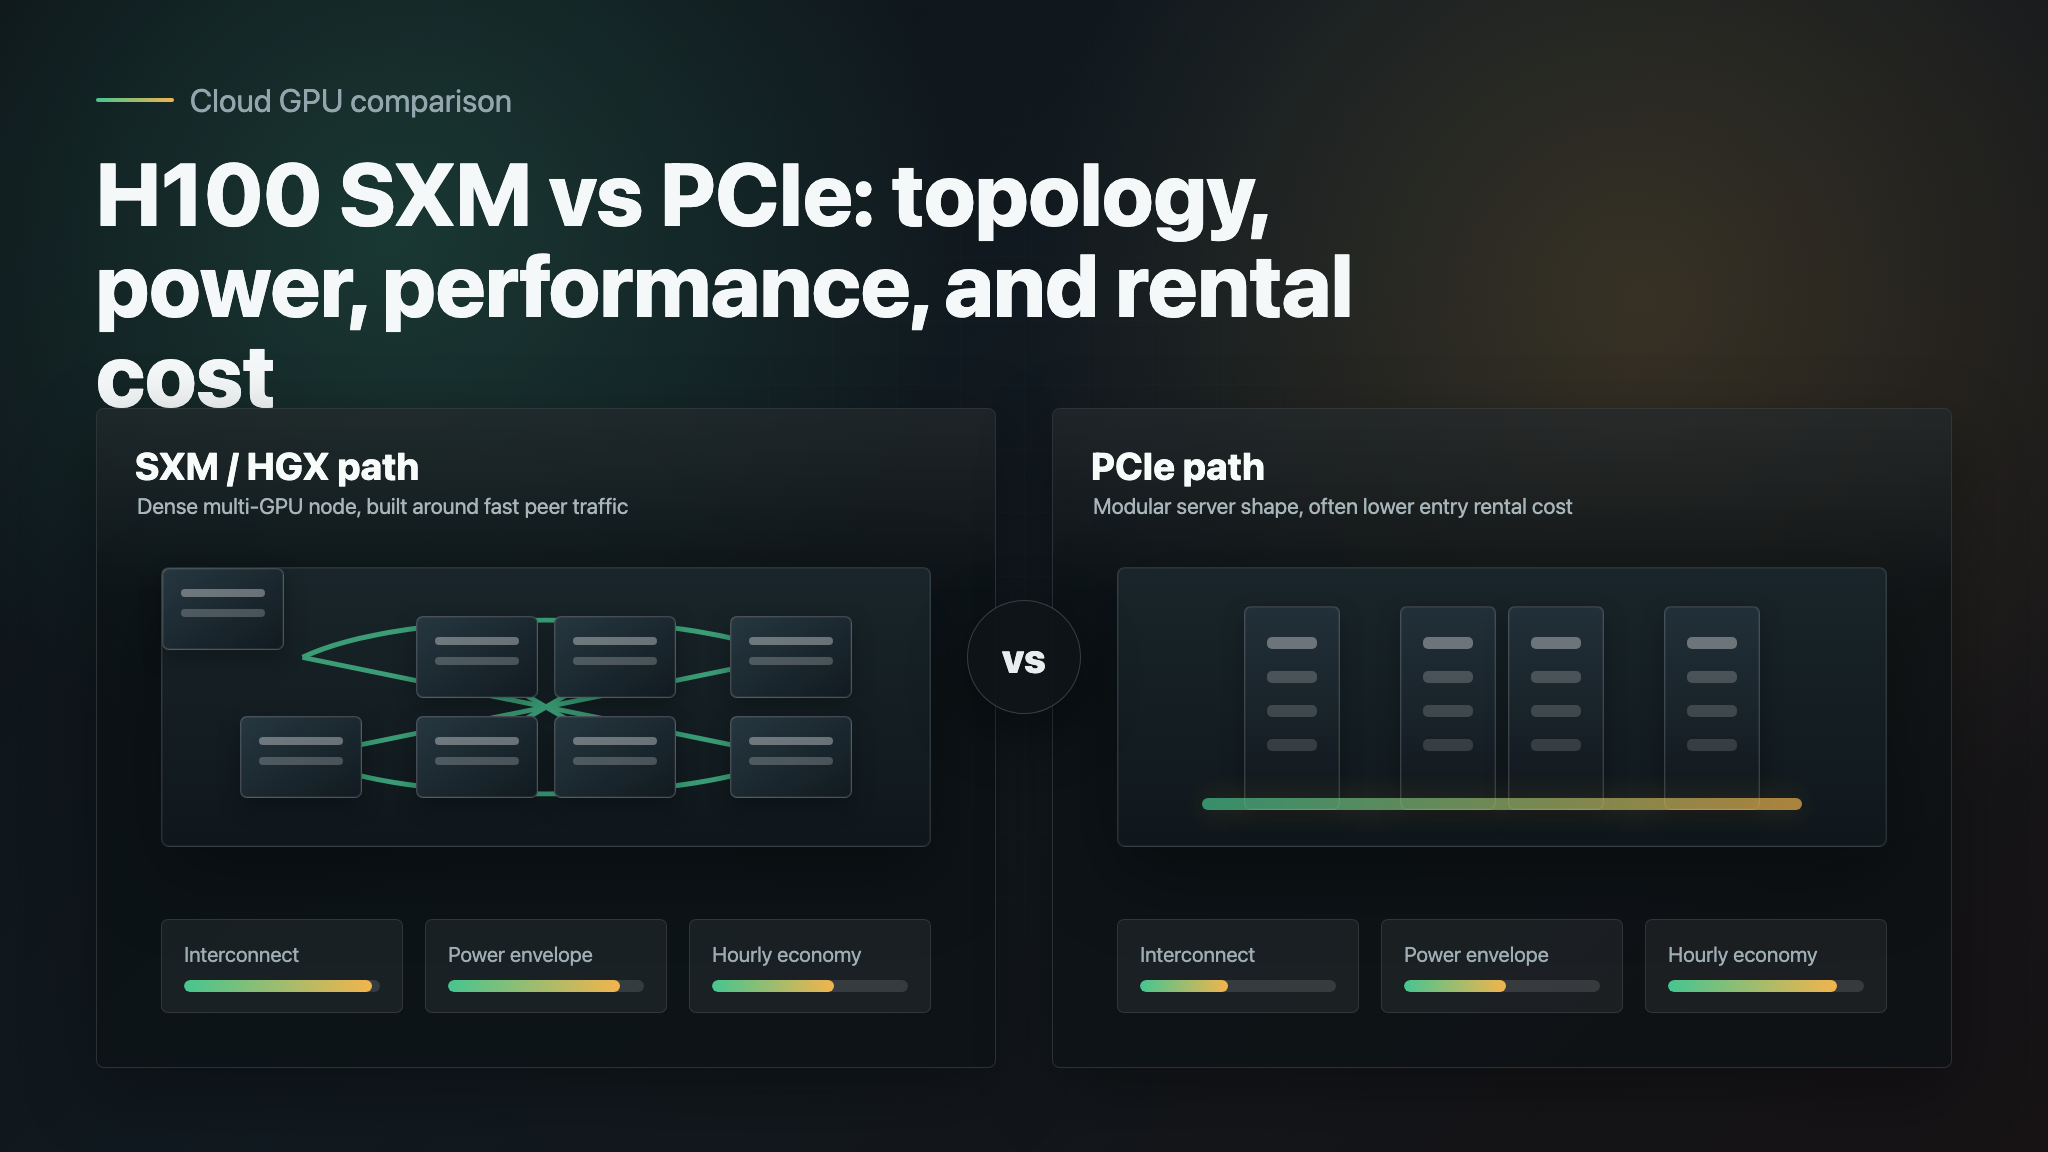
H100 SXM vs PCIe: NVLink, energía, rendimiento y costo de alquiler
Compara H100 PCIe vs SXM en NVLink, consumo de energía, rendimiento de cargas de trabajo y costo de alquiler antes de alquilar GPUs en la nube.
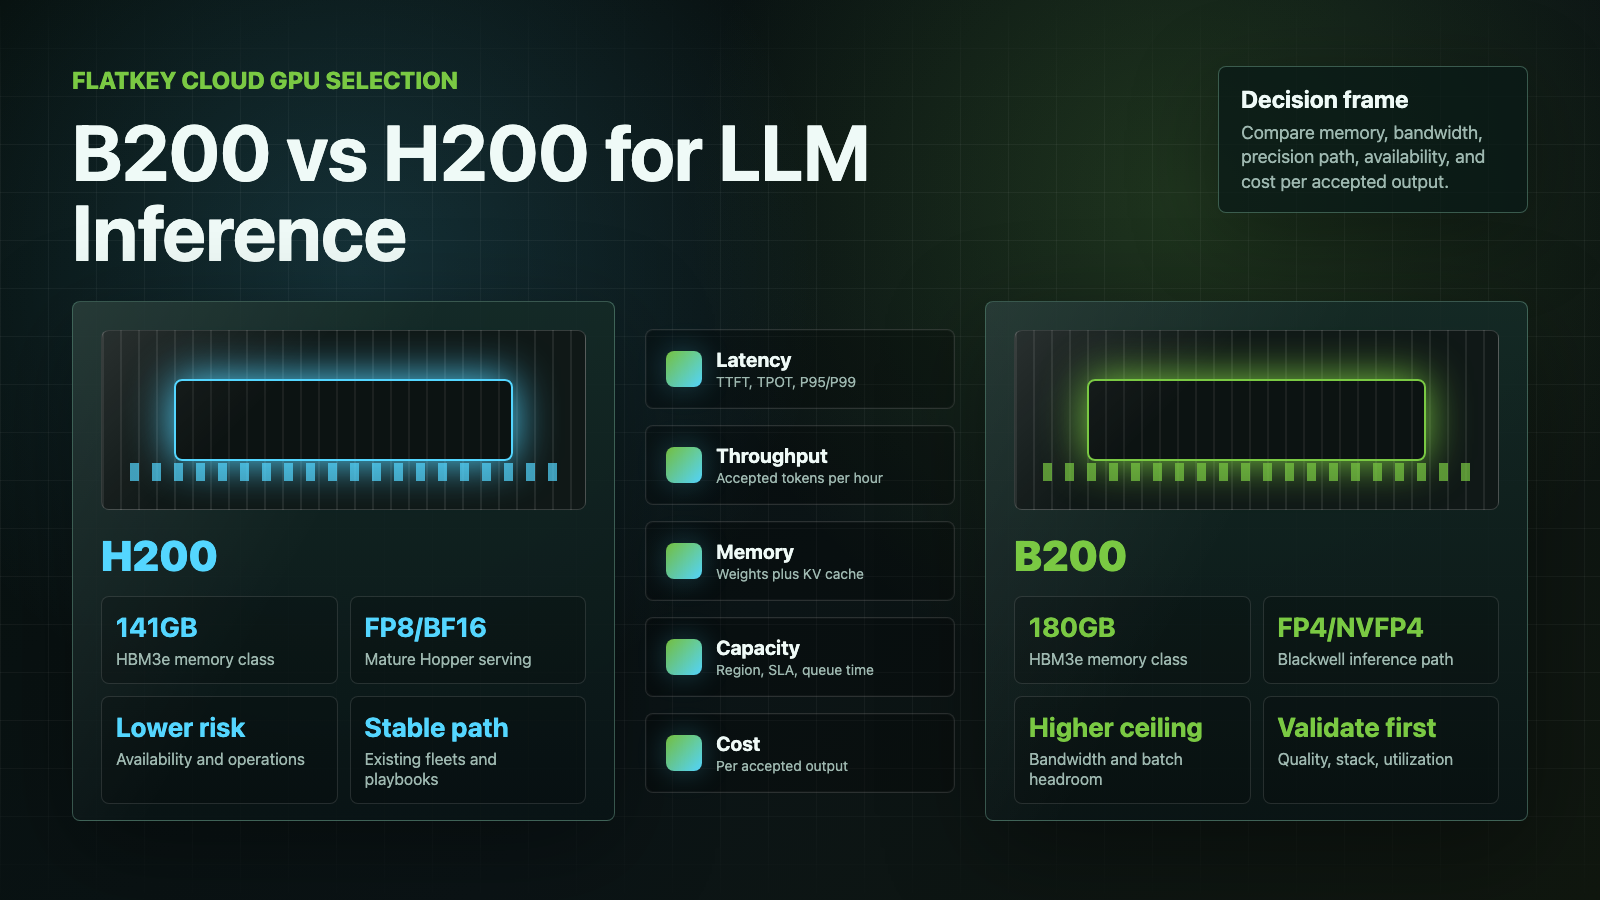
NVIDIA B200 vs H200: ¿Qué GPU es mejor para la inferencia de LLM?
Compara NVIDIA B200 vs H200 para inferencia de LLM por memoria, ancho de banda, soporte de precisión, sistemas DGX, disponibilidad de GPU en la nube y costo por salida aceptada.
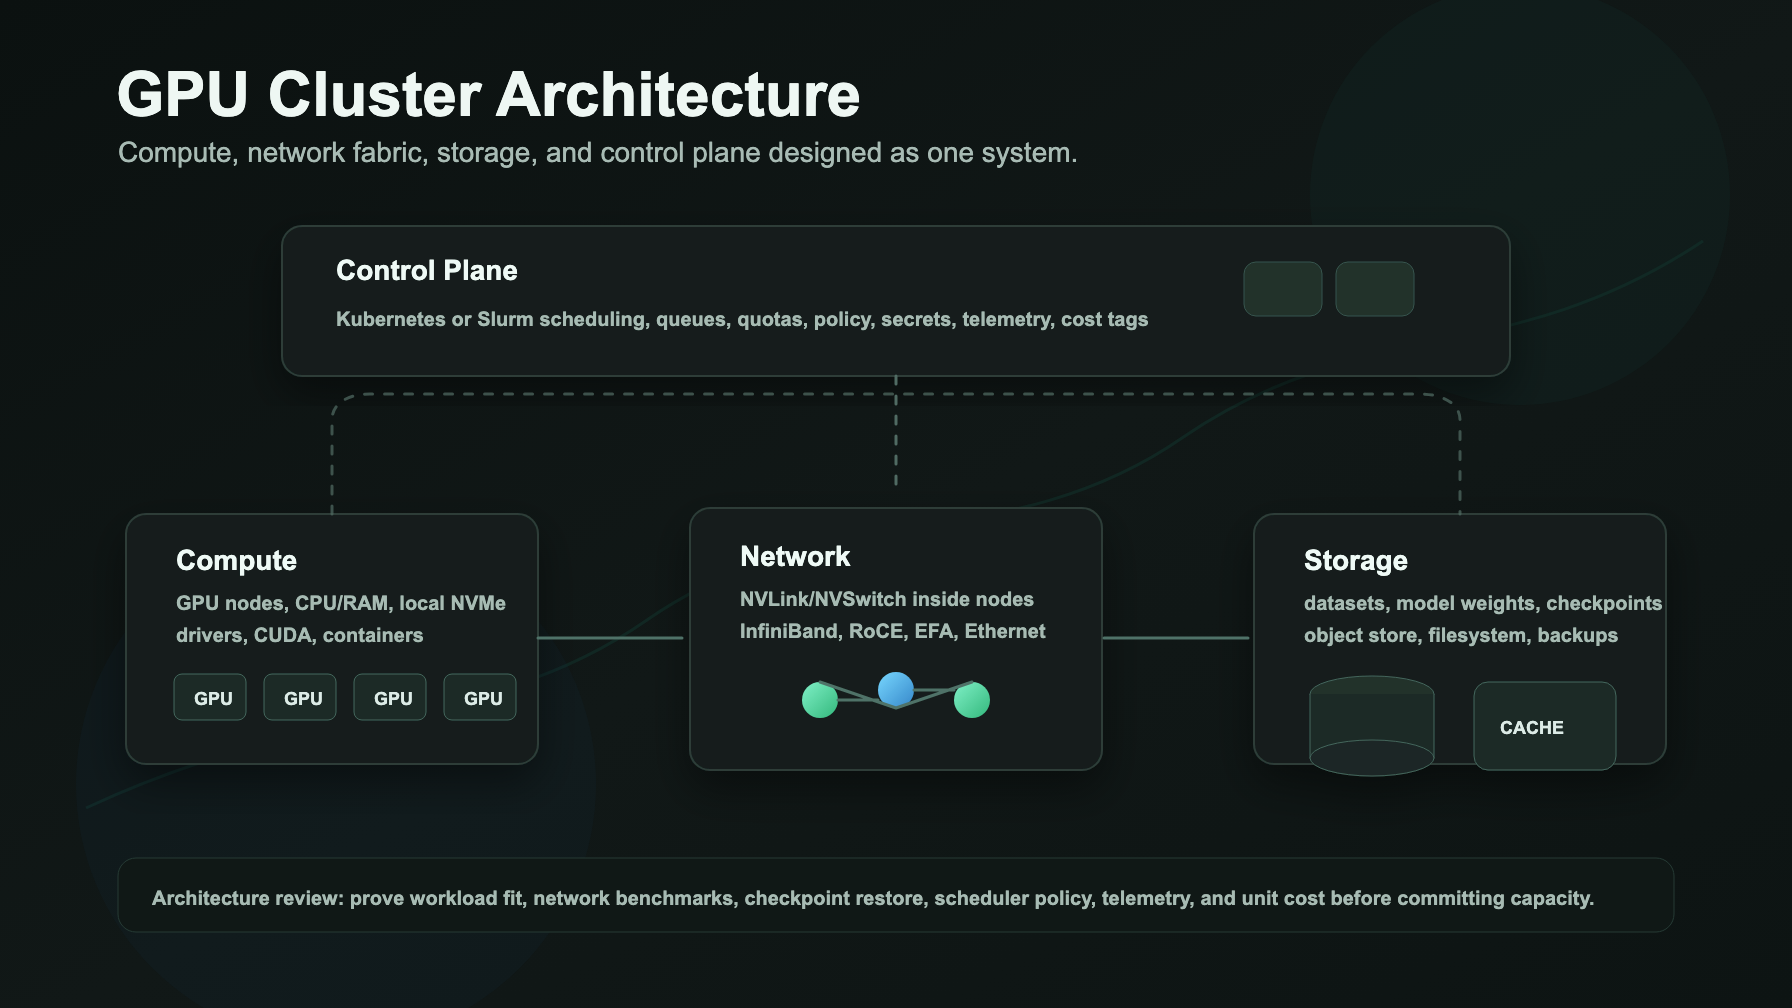
Arquitectura de clúster GPU: cómputo, red, almacenamiento y plano de control
Una guía práctica de arquitectura de clúster GPU para nodos de cómputo, tejido de red, almacenamiento, plano de control de Kubernetes o Slurm, observabilidad y pruebas de aceptación.
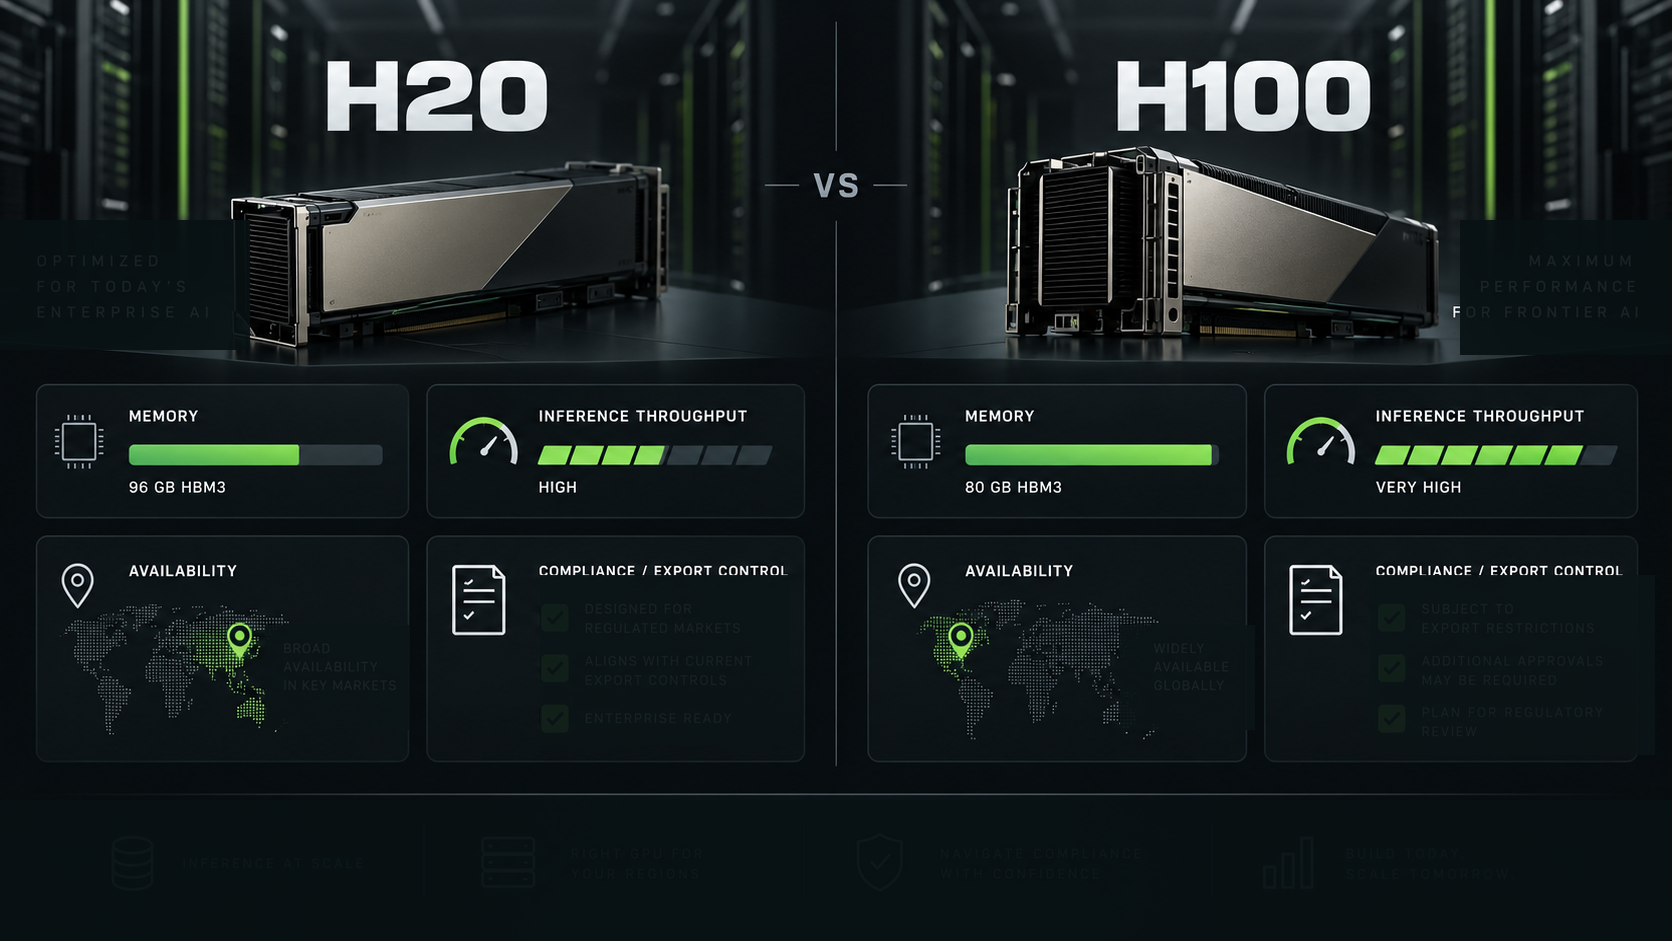
NVIDIA H20 vs H100: inferencia, memoria, disponibilidad y cumplimiento
Una comparación práctica entre H20 y H100 para equipos de IA empresariales, que cubre inferencia, memoria, disponibilidad, riesgo de control de exportaciones y cuándo H200 o las APIs de modelos son mejores referencias.
Mejores plataformas de alquiler de GPU en la nube 2026: precio, capacidad, red y soporte
Una selección práctica de 2026 de plataformas de nube GPU para equipos de IA, comparando precio, capacidad, red, soporte y cuándo una API de modelo es la mejor base.
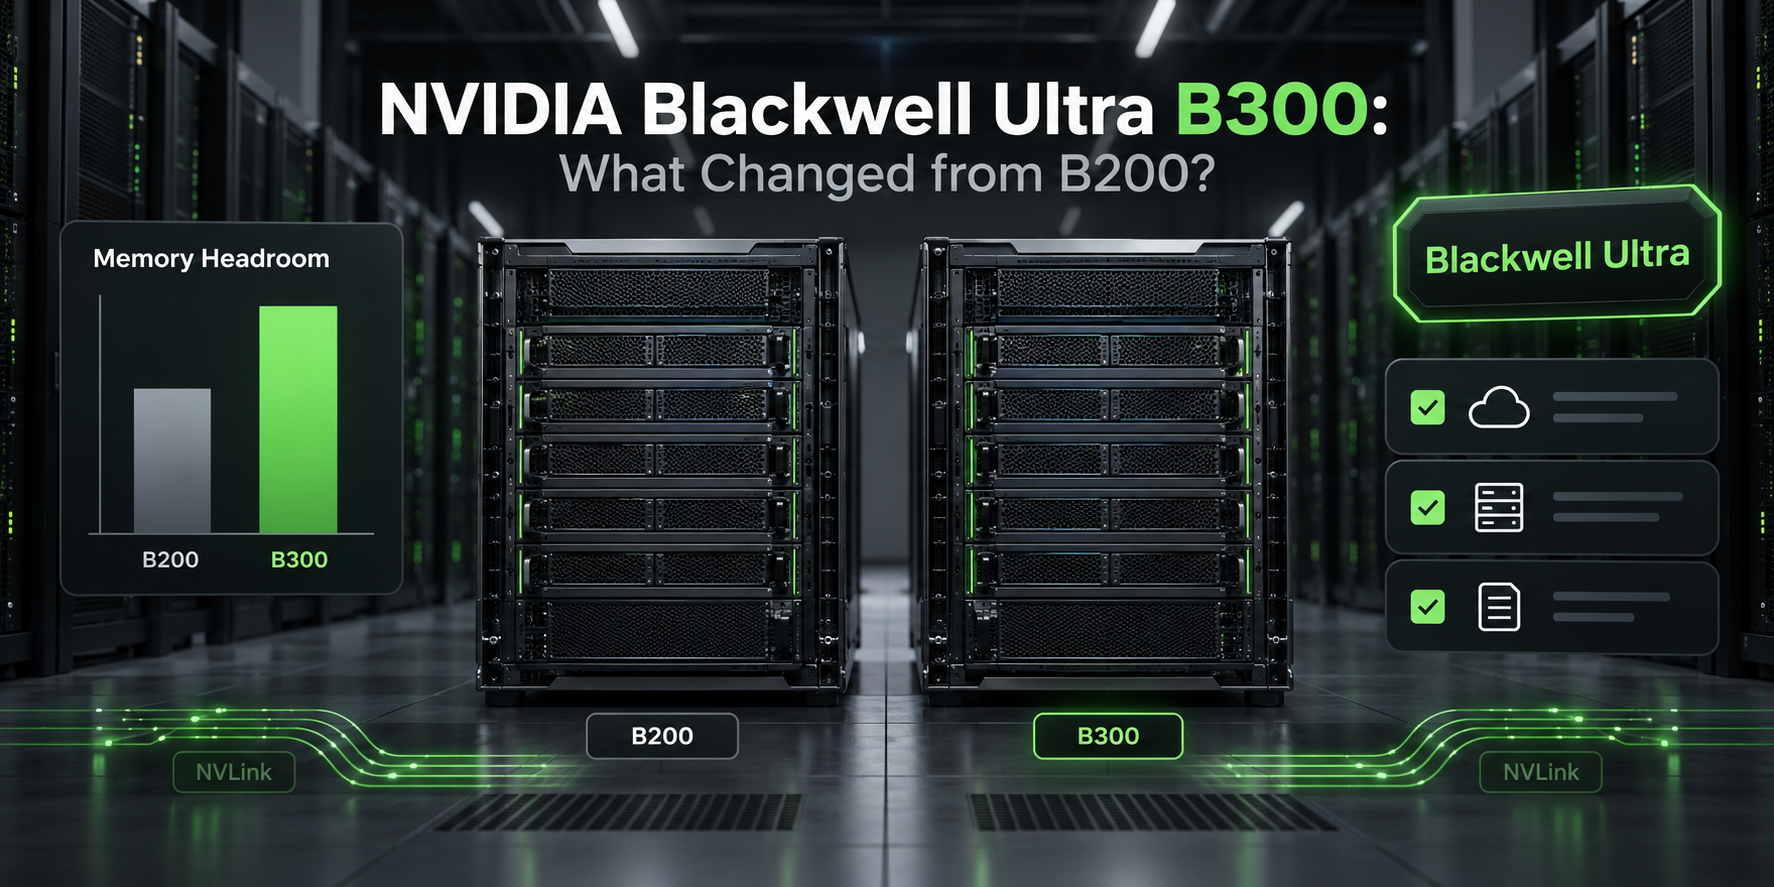
NVIDIA Blackwell Ultra B300: ¿Qué cambió respecto al B200?
Un seguimiento práctico de NVIDIA B300 Blackwell Ultra para equipos de infraestructura de IA, comparando especificaciones del B300, estado de lanzamiento, advertencias sobre el precio y compatibilidad de cargas de trabajo frente al B200.
AMD MI455X y Helios: rastreador de arquitectura, memoria y disponibilidad
Un rastreador orientado al comprador para AMD MI455X y Helios que cubre arquitectura, memoria HBM4, ancho de banda, disponibilidad, preparación para vLLM, dudas sobre proveedores y estrategia de respaldo de modelos/API.
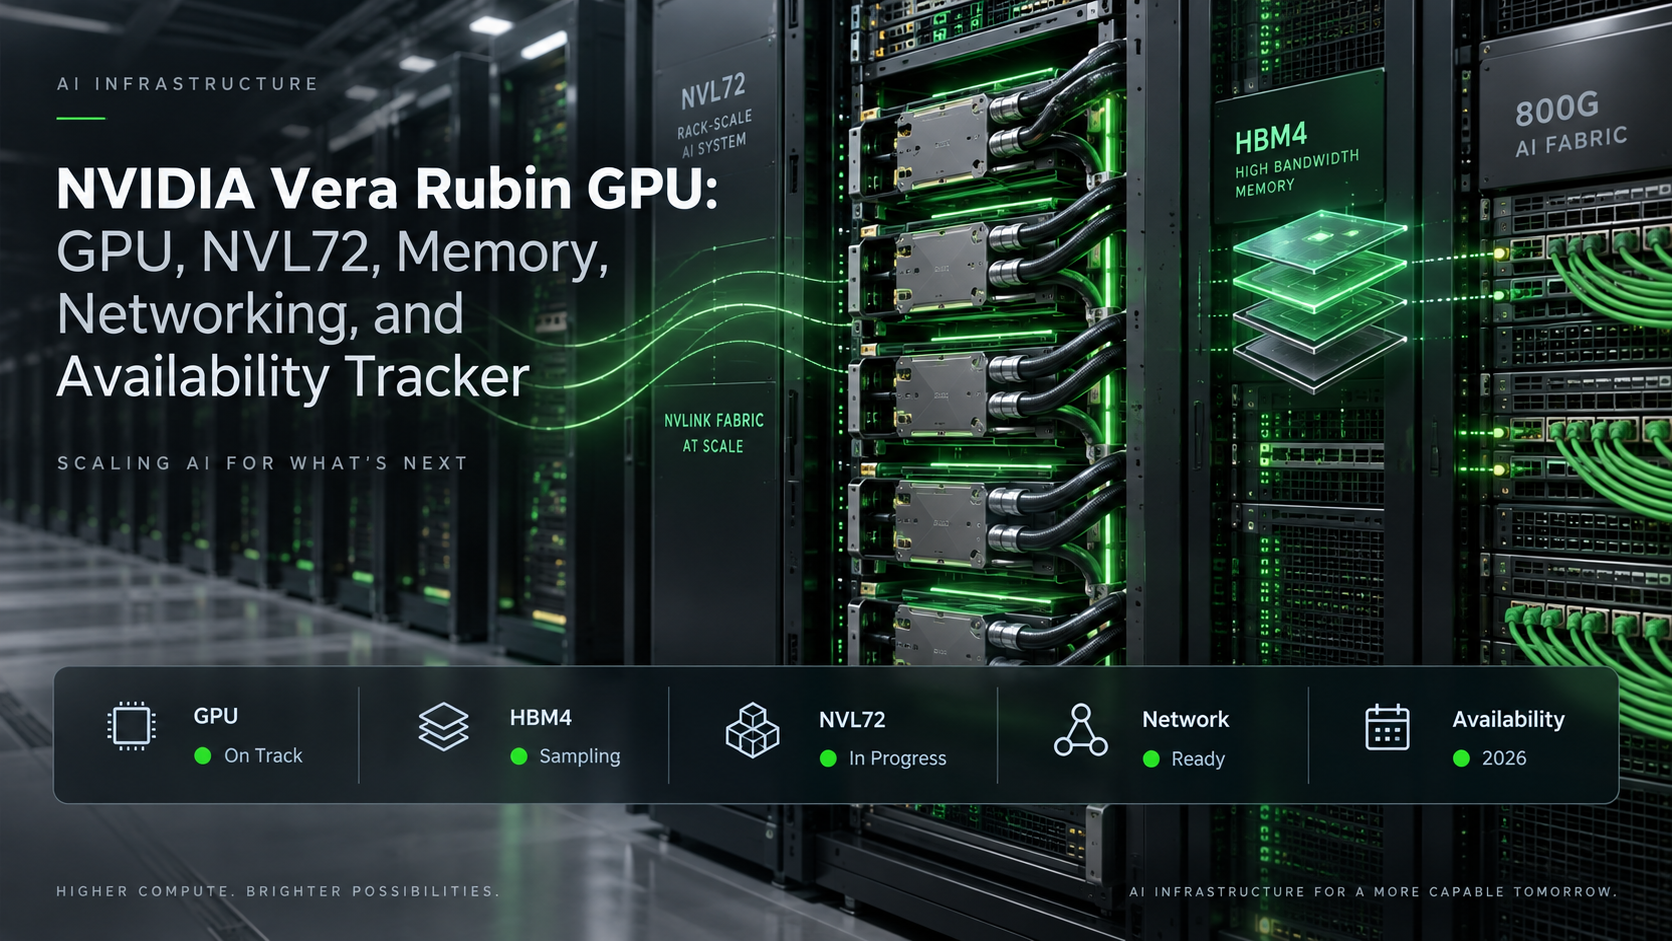
GPU NVIDIA Vera Rubin: rastreador de GPU, NVL72, memoria, redes y disponibilidad
Un rastreador actualizado de las especificaciones de la GPU NVIDIA Vera Rubin, DGX Vera Rubin NVL72, memoria HBM4, redes e hitos de disponibilidad para compradores de GPU en la nube.
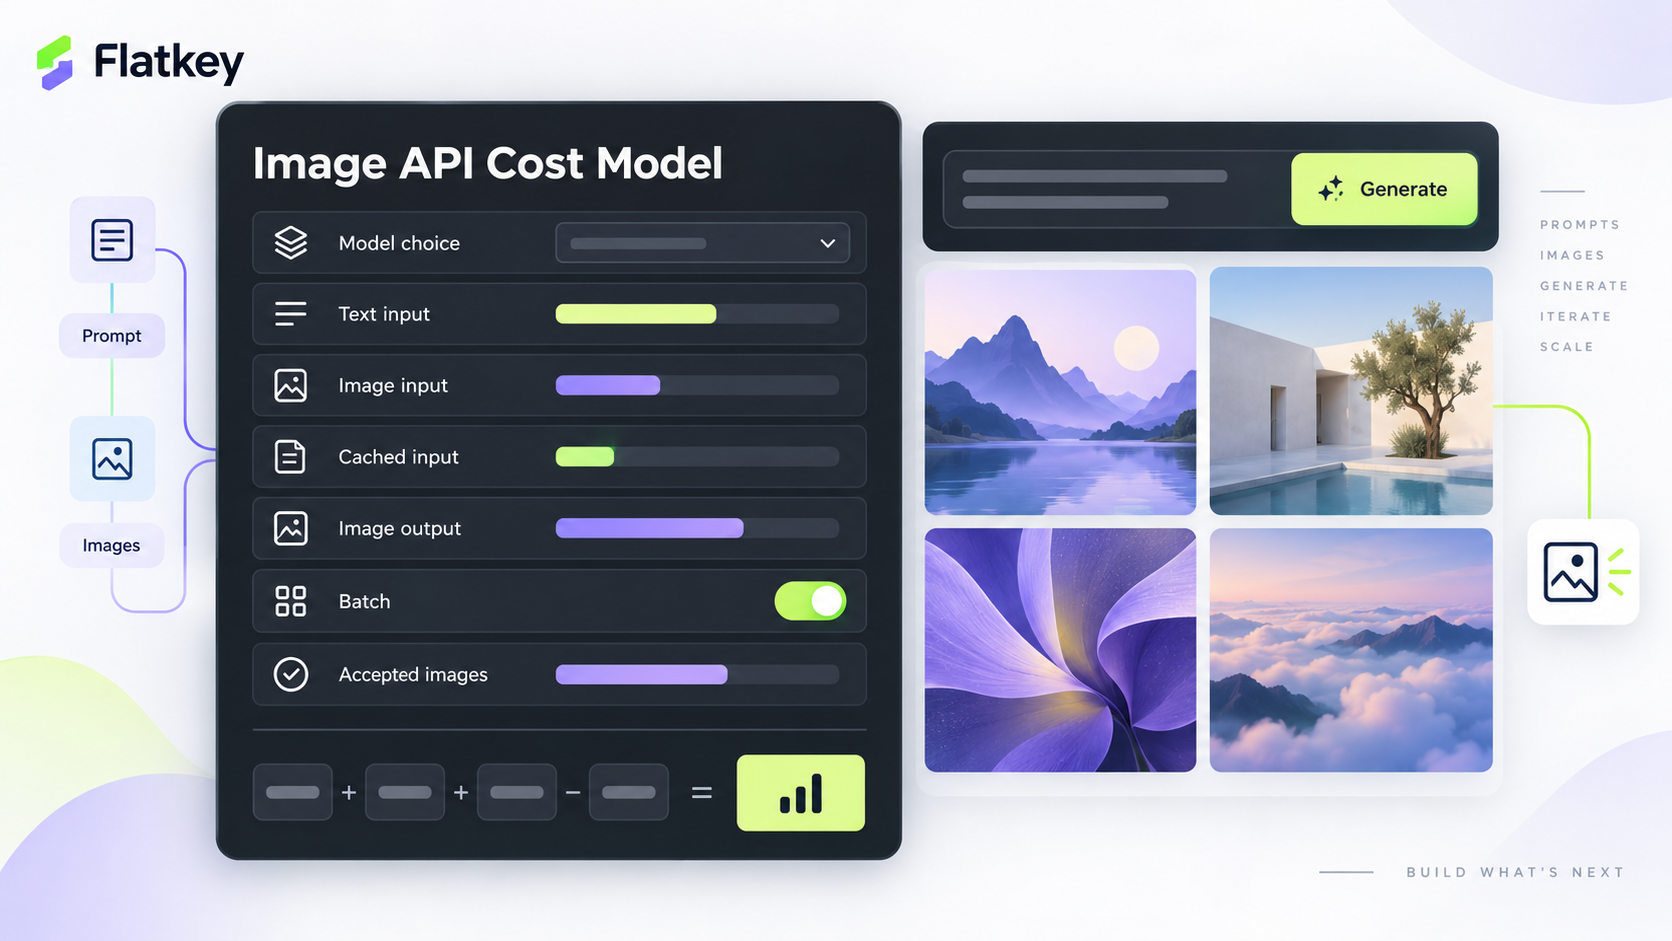
Precios de la API de imágenes de OpenAI: tarifas de GPT Image 2.5, fórmula de coste y controles de presupuesto
Aprende cómo funciona el precio de la API de imágenes de OpenAI para GPT Image 2.5, incluidas las tarifas por token, las reglas de entrada en caché, las imágenes parciales, Batch y el coste por imagen aceptada.
GB200 vs B200: ¿superchip Grace Blackwell o HGX x86?
Compara GB200 vs B200 para la adquisición de infraestructura de IA: sistemas Grace Blackwell NVL72 a escala de rack, nodos B200 HGX/x86, benchmarks y comprobaciones de TCO.
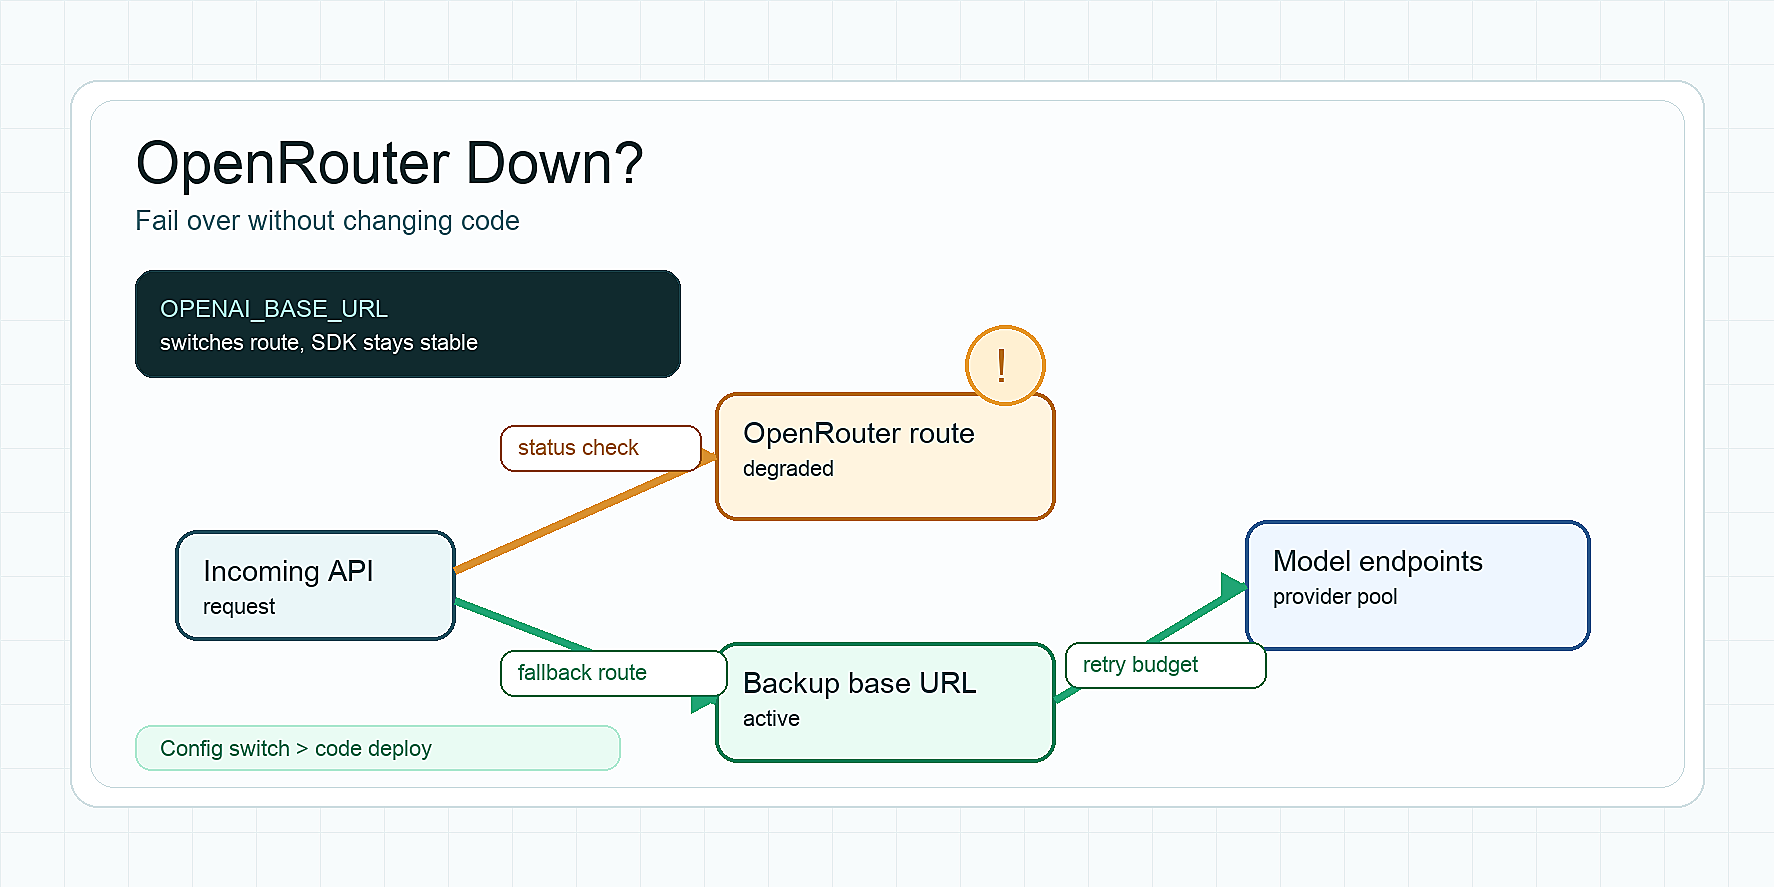
¿OpenRouter no funciona? Cómo hacer failover sin cambiar código
Comprueba si OpenRouter está caído, separa los errores del proveedor de los incidentes de la plataforma y haz failover con base_url, retries, fallback de proveedor y fallback de modelo.
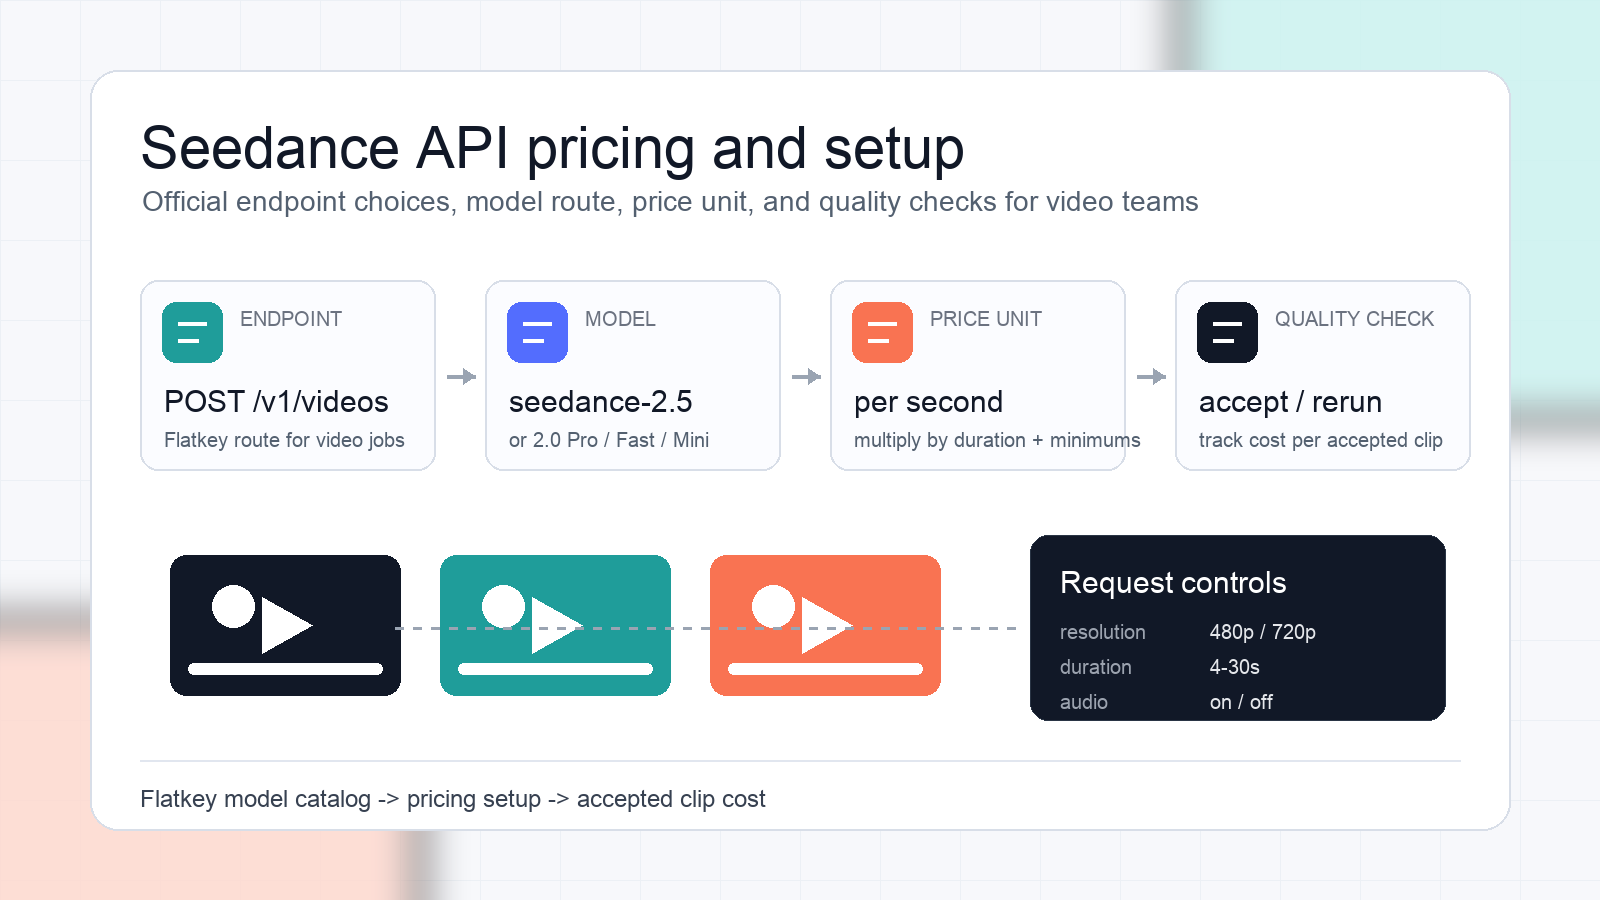
Seedance API: precios, calidad y configuración para los endpoints oficiales
Compara las opciones oficiales de endpoints de la API de Seedance, los precios por segundo de Flatkey, los pasos de configuración y las comprobaciones de calidad para equipos de generación de video.
¿Qué es una fábrica de IA? Clústeres de GPU, datos, modelos y operaciones
Aprende qué es una fábrica de IA, cómo trabajan juntos los clústeres de GPU, las canalizaciones de datos, los modelos, la inferencia, la gobernanza y las operaciones, y cuándo las API de modelos pueden sustituir la propiedad directa de GPU.
Crea más rápido con una sola pasarela de IA.
Usa flatkey.ai para gestionar modelos, claves, facturación y observabilidad desde una plataforma API.
Empezar