
Blog de flatkey.ai
Ideas, notas de producto y guías de implementación para equipos que crean sobre APIs de IA.
Arquitectura de pasarelas de IA
Últimos artículos en Arquitectura de pasarelas de IA.
Leer másMigración de URL base y SDK
Últimos artículos en Migración de URL base y SDK.
Leer másCostes, facturación y operaciones
Últimos artículos en Costes, facturación y operaciones.
Leer másControles empresariales y confianza
Últimos artículos en Controles empresariales y confianza.
Leer másComparativas de pasarelas
Últimos artículos en Comparativas de pasarelas.
Leer másGuías de modelos y modalidades
Últimos artículos en Guías de modelos y modalidades.
Leer másFiabilidad y enrutamiento
Últimos artículos en Fiabilidad y enrutamiento.
Leer másIntegraciones de herramientas
Últimos artículos en Integraciones de herramientas.
Leer más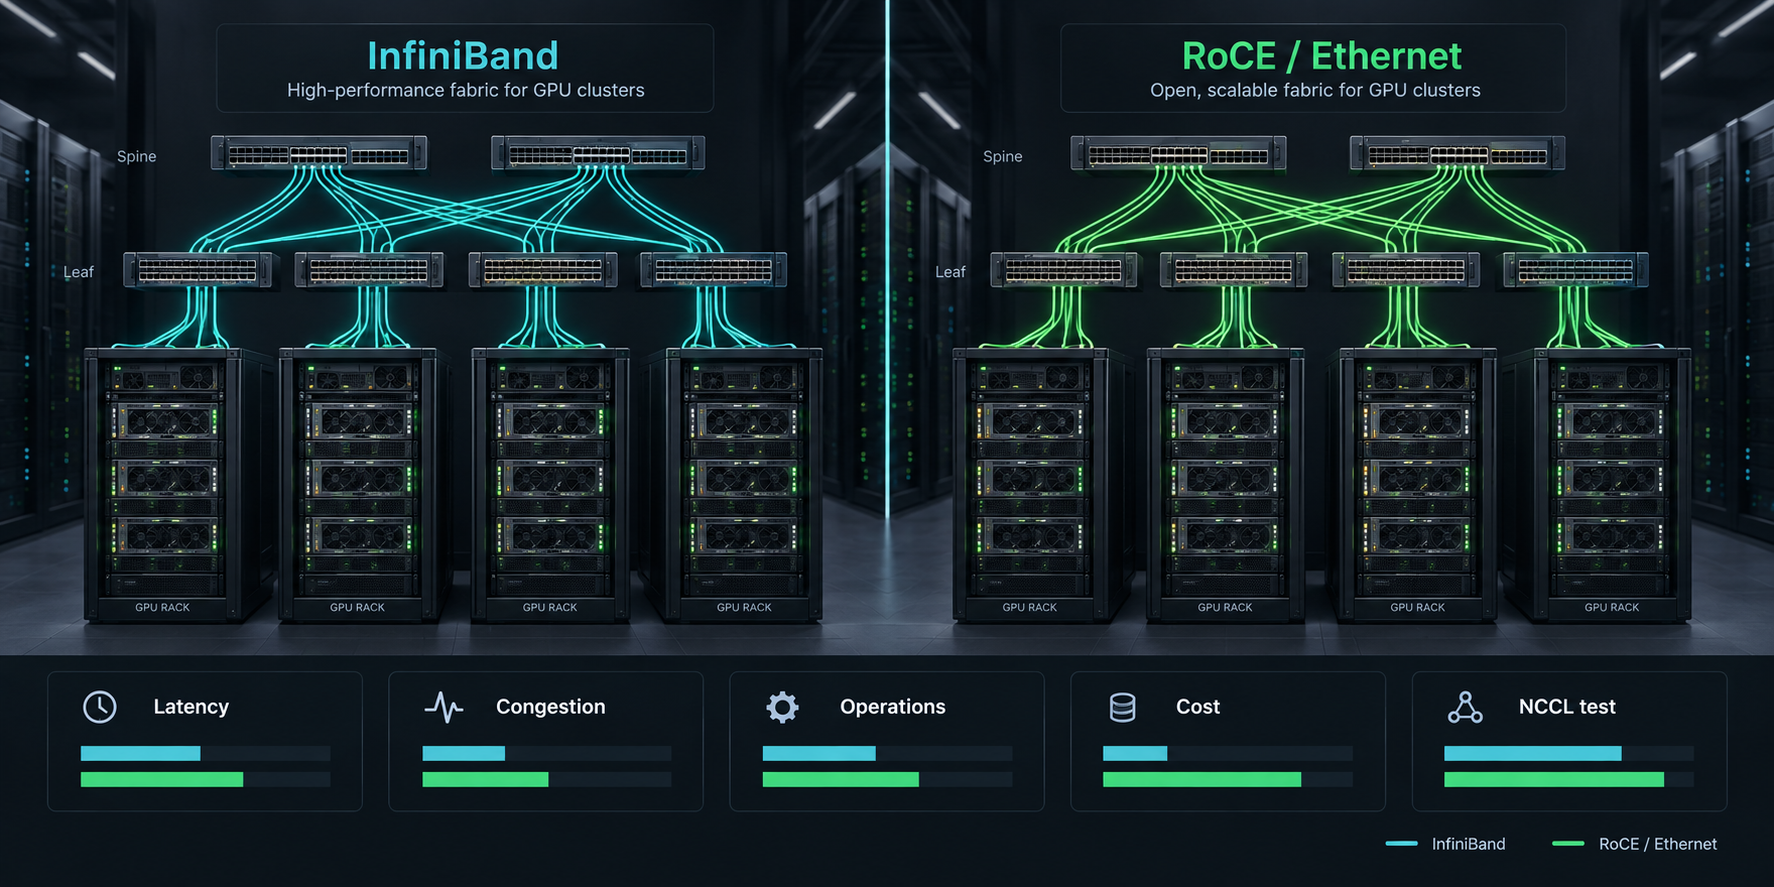
RoCE vs InfiniBand para clústeres de GPU: latencia, operaciones y coste
Compara RoCE e InfiniBand para clústeres de GPU multinodo con una matriz práctica de decisión, una prueba de aceptación de NCCL, un modelo de costes y una lista de verificación de compras.
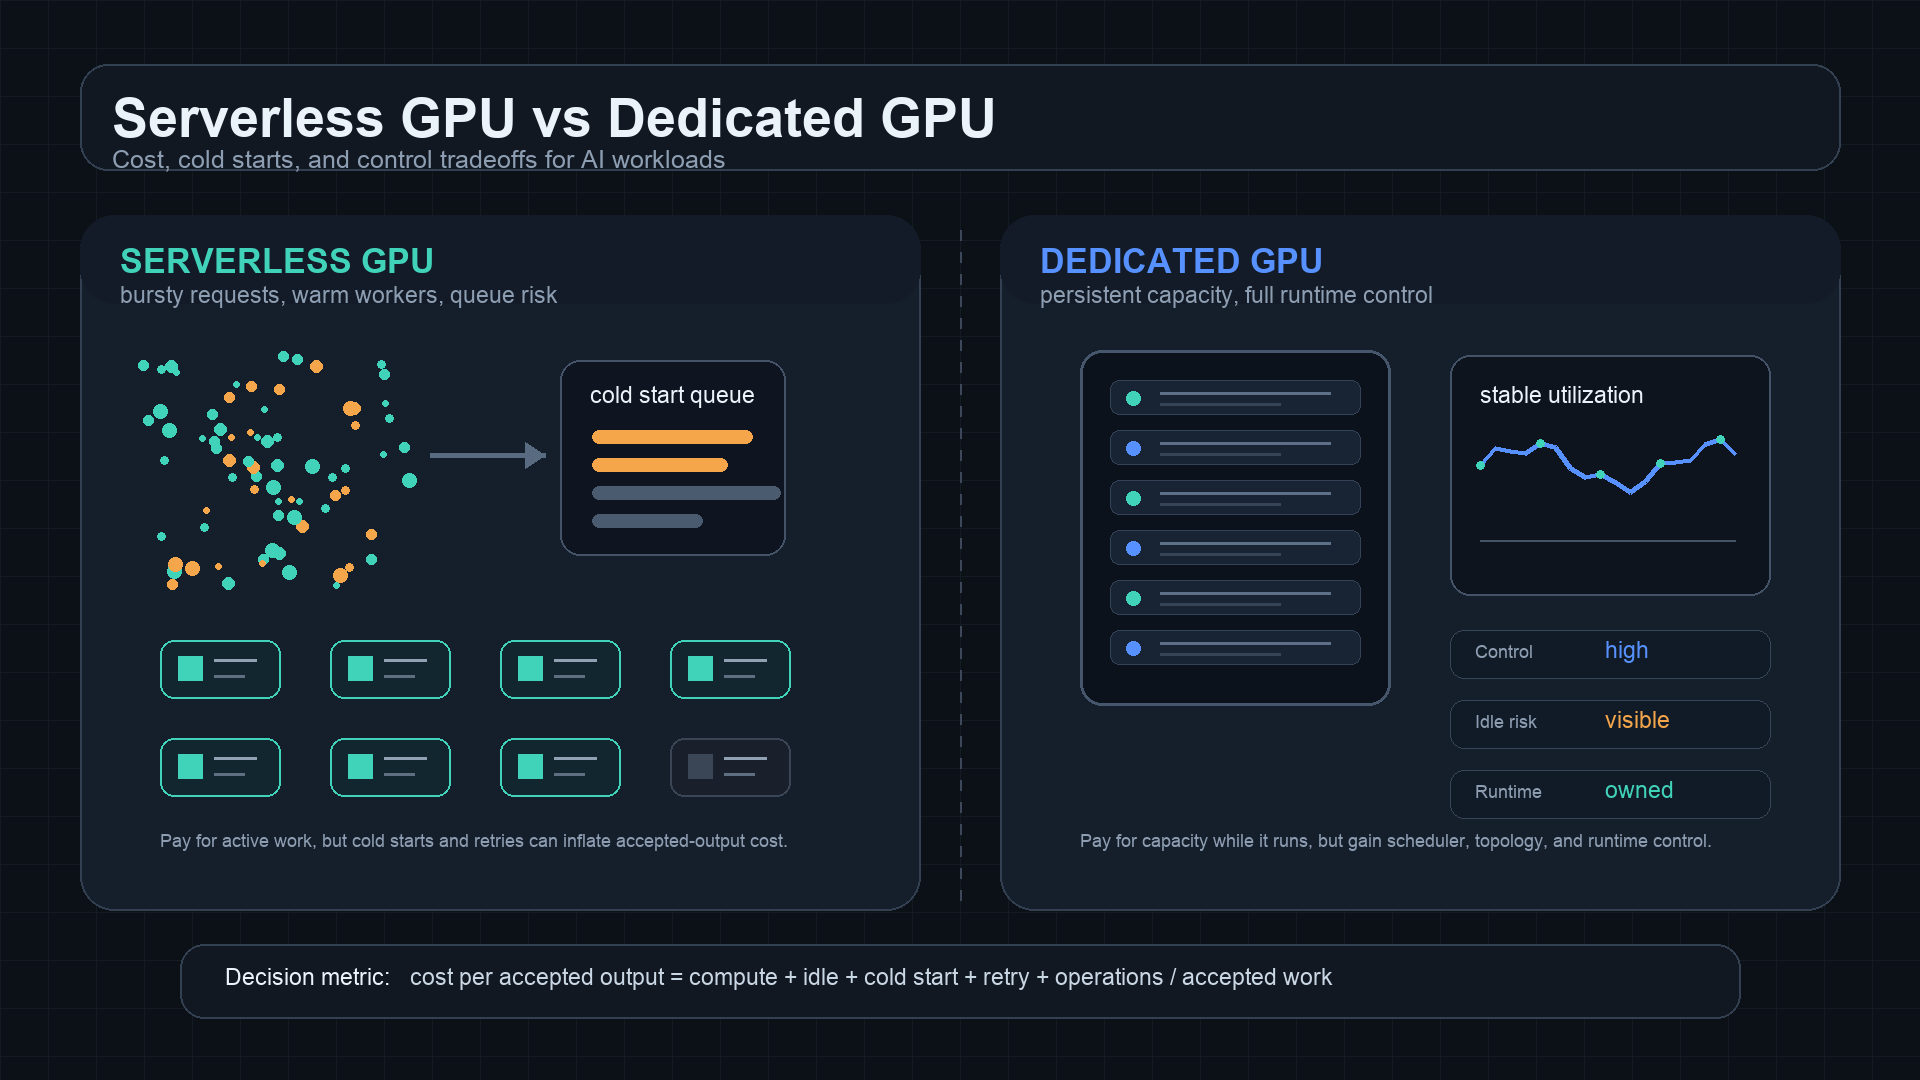
GPU sin servidor vs GPU dedicada: costo, tiempos de arranque en frío y control
Compara GPU sin servidor vs GPU dedicada por costo por salida aceptada, arranques en frío, capacidad ociosa, escalado automático y control operativo.

Comparación de precios de API de generación de imágenes con IA: GPT Image, Gemini, Imagen y fal
Compara los precios de API de generación de imágenes entre GPT Image, Gemini Image, Imagen y fal, normalizando las unidades de facturación en costo por imagen aceptada.
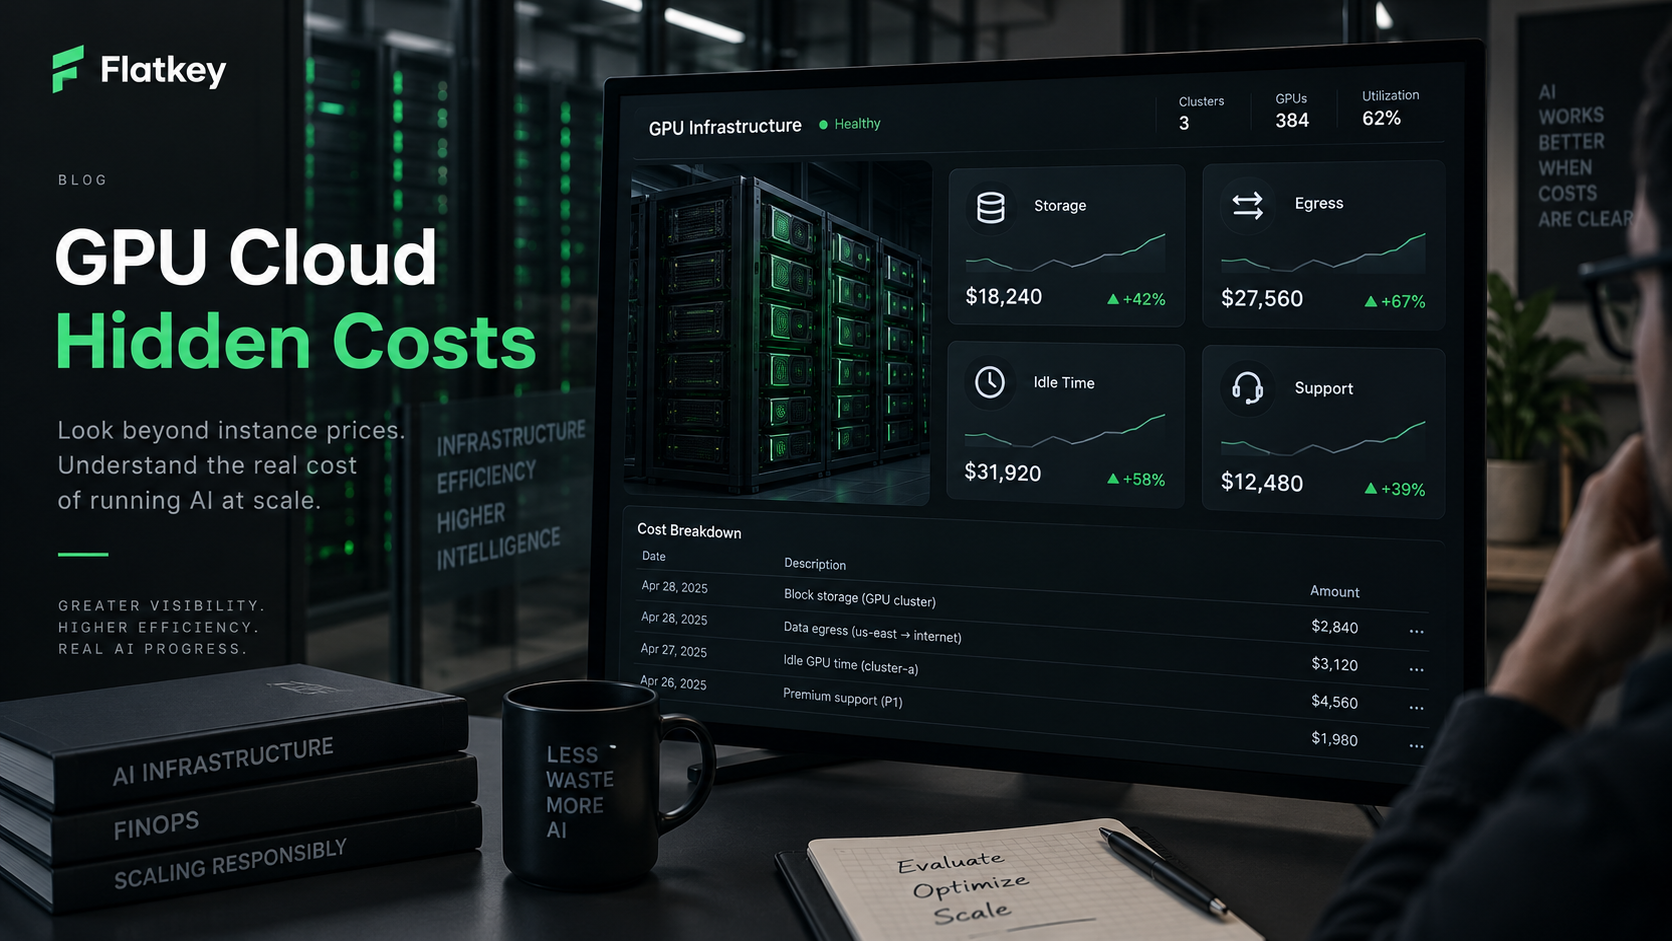
¿Cuáles son los costos ocultos de los servicios de GPU en la nube? Almacenamiento, salida de datos, tiempo inactivo y soporte
Una guía práctica de TCO para GPU en la nube para identificar costos de almacenamiento, salida de datos, tiempo inactivo, trabajos fallidos, soporte, redes y operaciones antes de que llegue la factura.
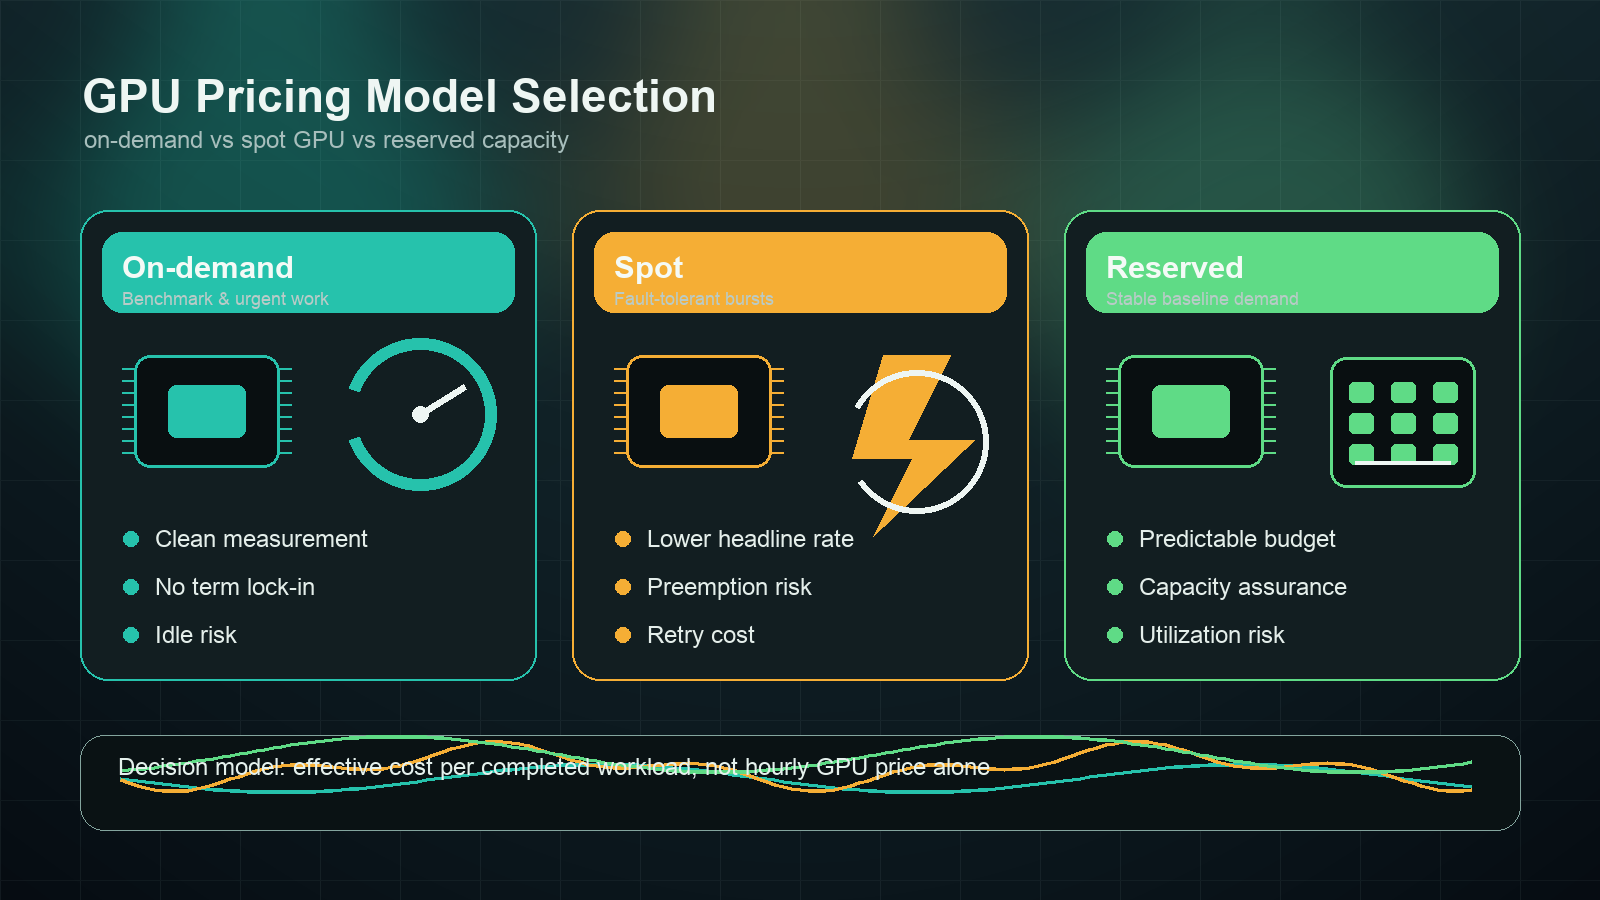
Precios de GPU bajo demanda vs spot vs reservados: ¿qué modelo se adapta a tu carga de trabajo?
Un marco basado en la carga de trabajo para elegir capacidad de GPU bajo demanda, spot o reservada sin confundir la tarifa horaria publicada con el costo de la carga de trabajo completada.
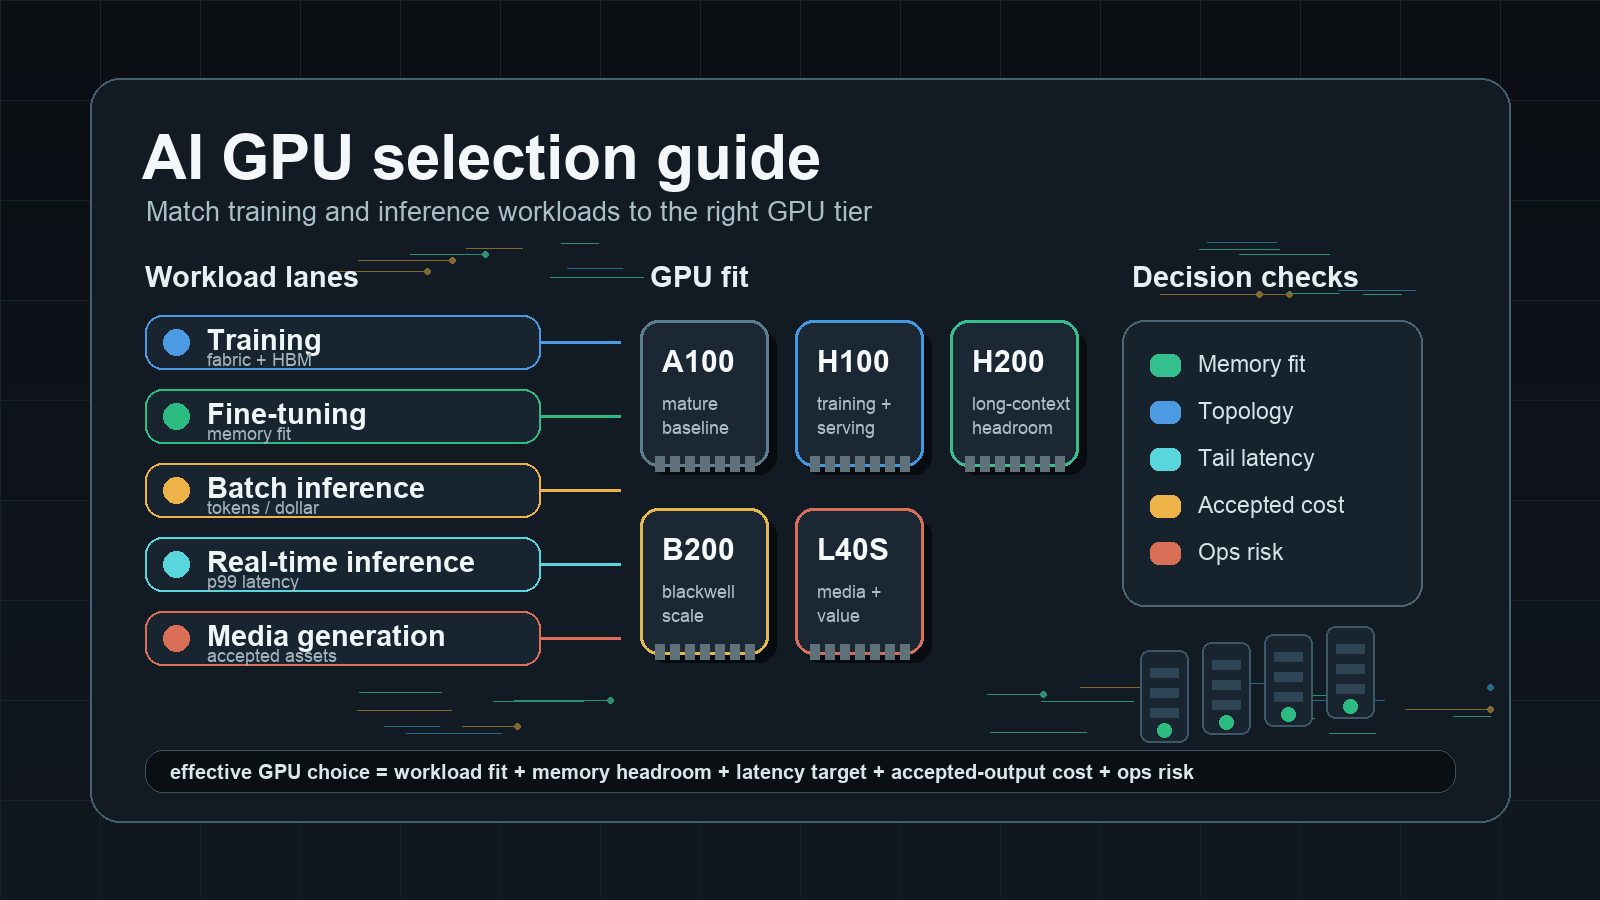
Guía de selección de GPU para IA: adapta las cargas de trabajo de entrenamiento e inferencia a la GPU adecuada
Una guía práctica de selección de GPU para IA para equipos que asignan cargas de trabajo de entrenamiento, ajuste fino, inferencia de LLM, generación de contenido multimedia y evaluación a la GPU y al modelo de capacidad adecuados.
Nube privada de GPU: arquitectura, aislamiento y modelo operativo
Aprende a evaluar la arquitectura de una nube privada de GPU, el aislamiento, la propiedad del scheduler, la evidencia de seguridad, el modelo operativo, el TCO y las pruebas de aceptación.

Guía de despliegue de vLLM: sirve una API de LLM compatible con OpenAI en GPUs
Despliega vLLM como una API compatible con OpenAI en GPUs con Docker, RunPod Serverless, Ray Serve, métricas, controles de despliegue y comprobaciones de coste por salida aceptada.
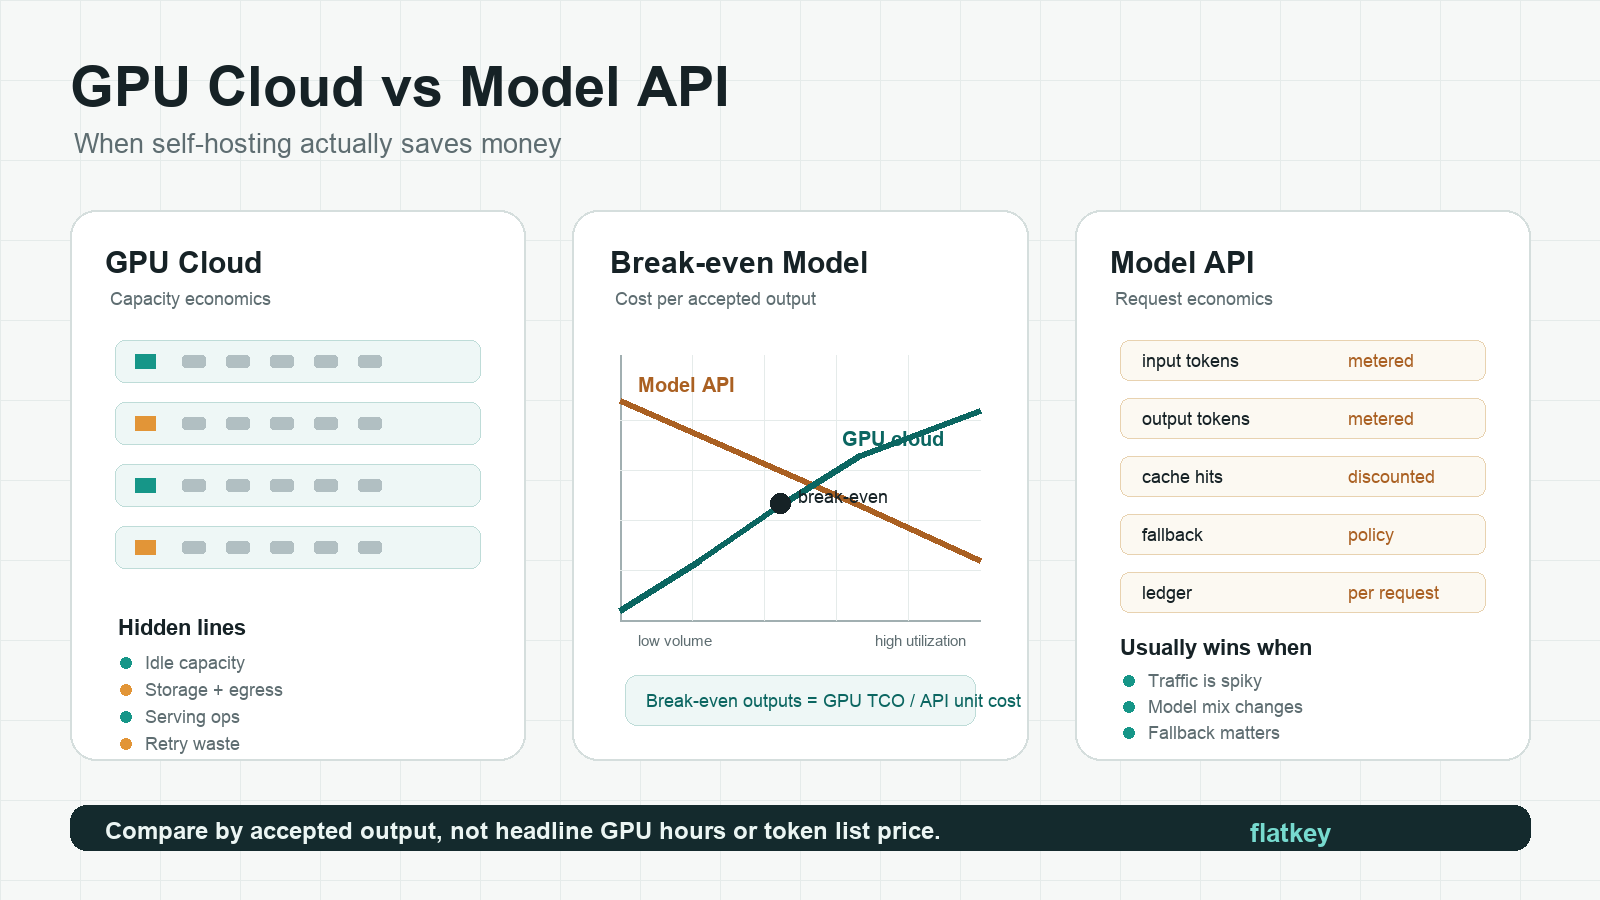
GPU Cloud vs API de modelo: cuándo el autoalojamiento realmente ahorra dinero
Compara la economía de GPU cloud frente a API de modelo con una hoja de cálculo de punto de equilibrio para el coste por salida aceptada, la utilización, los reintentos, la capacidad ociosa y las operaciones de serving.
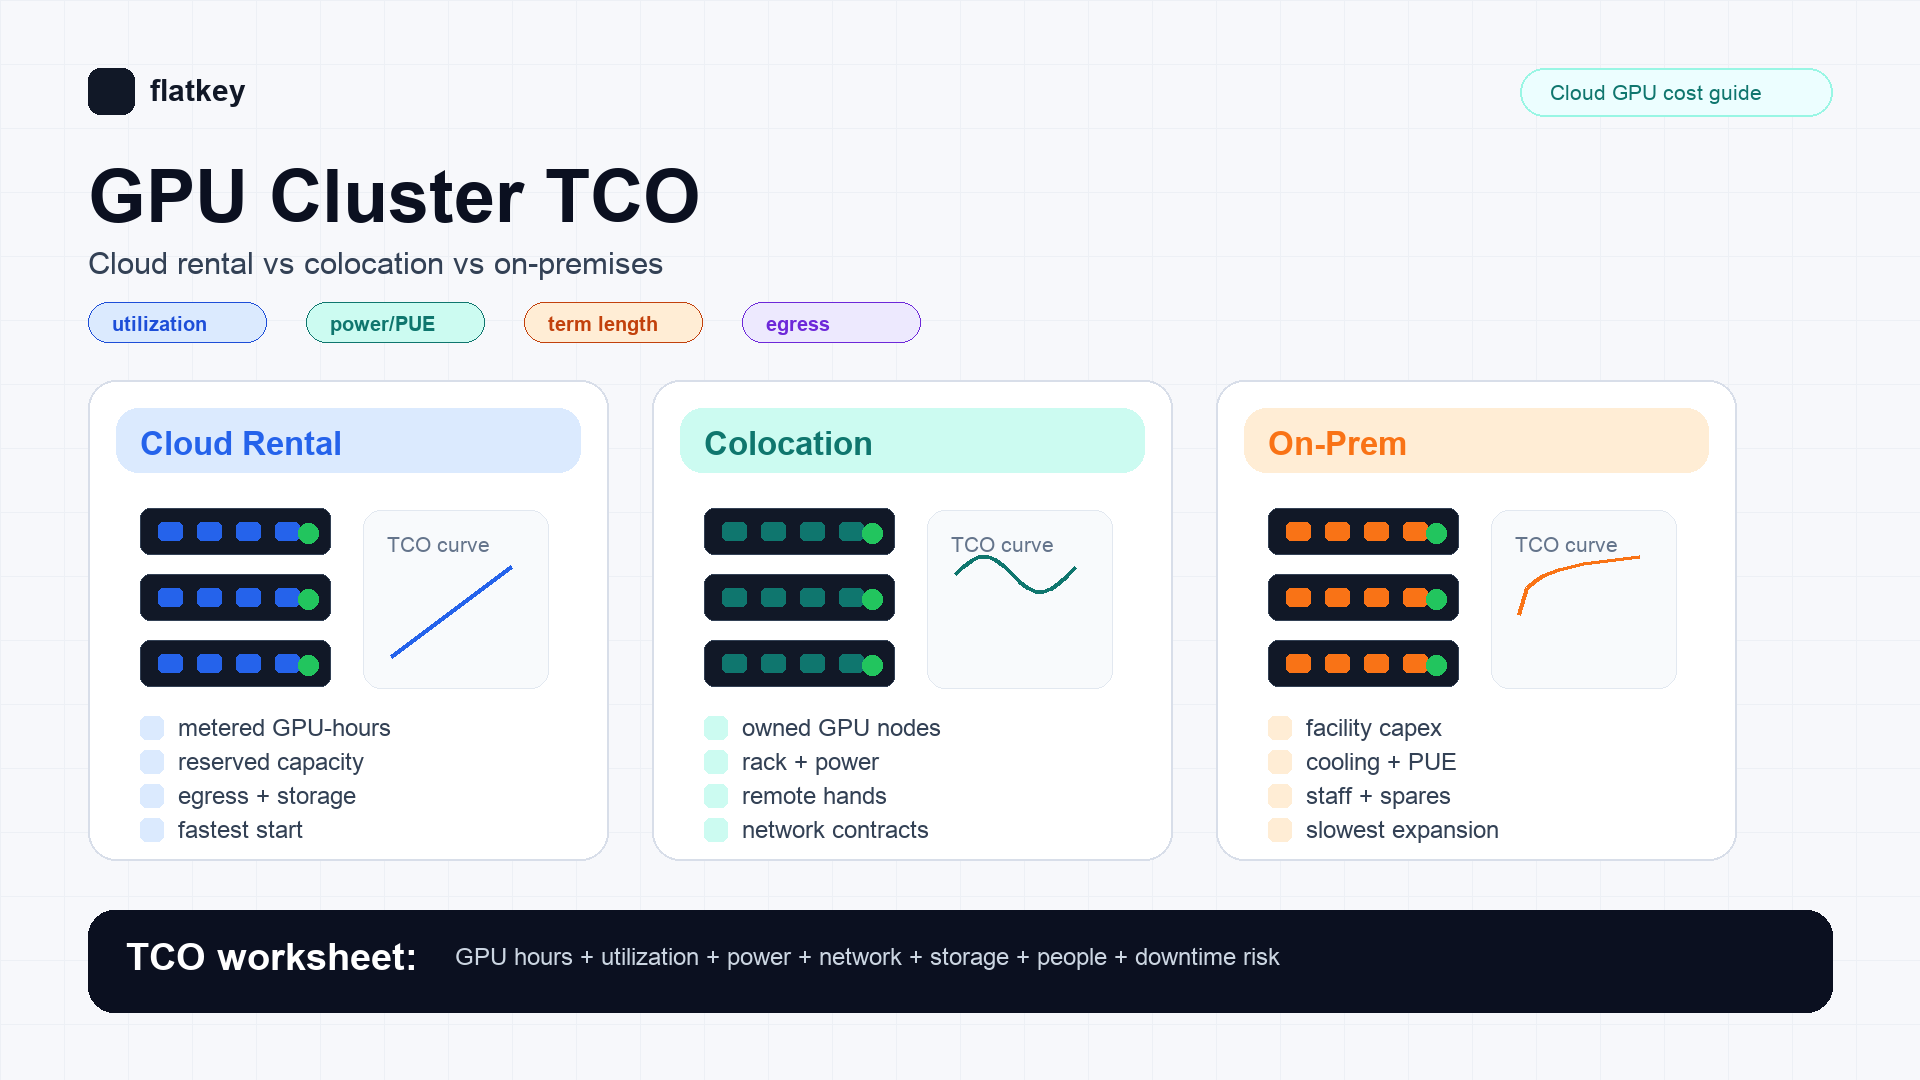
TCO de clústeres GPU: alquiler en la nube vs colocation vs on-premises
Compara el TCO de clústeres GPU entre alquiler en la nube, colocation y on-premises con una hoja de trabajo FinOps práctica para compradores de infraestructura de IA.
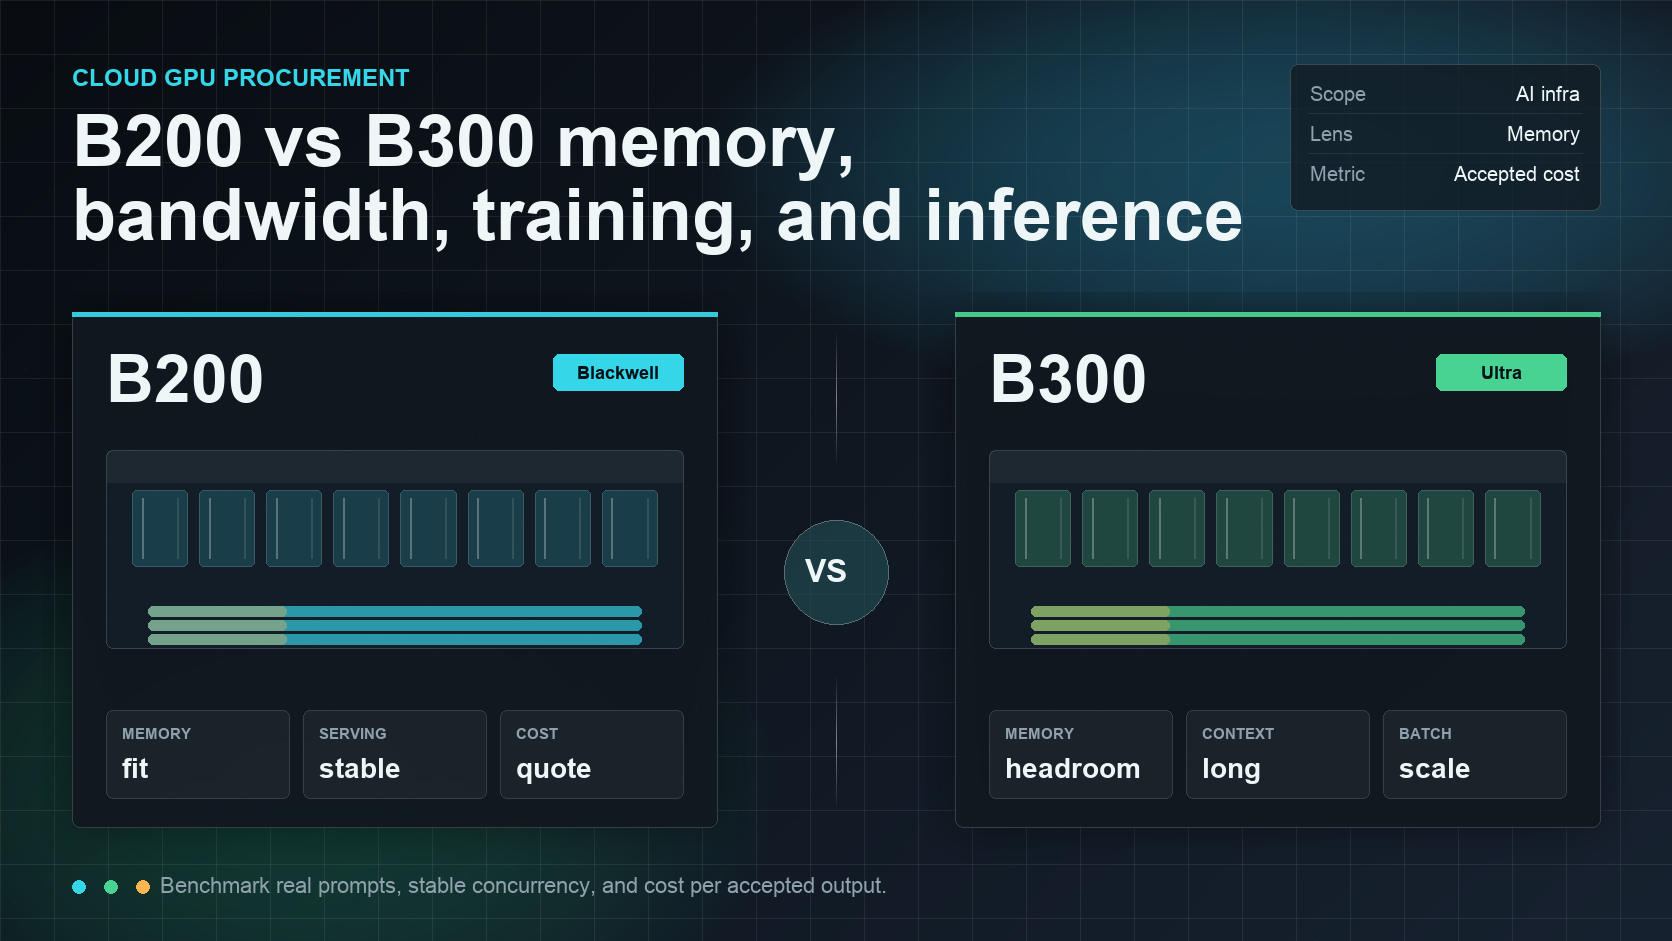
NVIDIA B300 vs B200: Memoria, ancho de banda, entrenamiento e inferencia
Una comparación práctica entre B200 y B300 para equipos de infraestructura de ML que evalúan la memoria, el ancho de banda, el entrenamiento, la inferencia y la economía de adquisición de las GPU NVIDIA Blackwell.
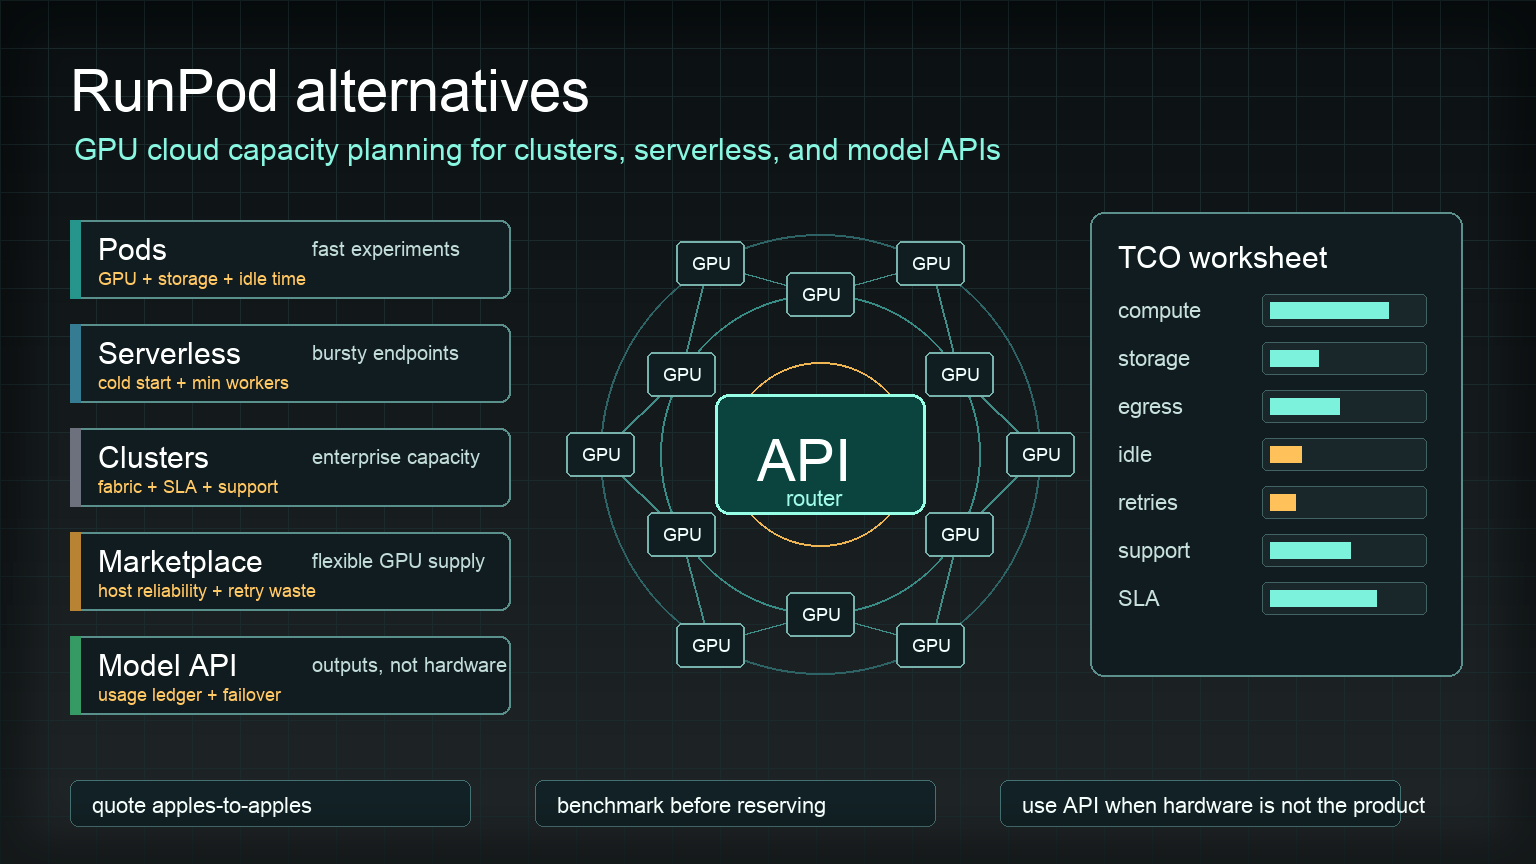
Las 10 mejores alternativas a RunPod en 2026: precios, ventajas y cuál elegir
Compara 10 alternativas a RunPod con precios de GPU de octubre de 2026: los mercados más baratos, nubes GPU estables, plataformas serverless y API de modelos, además de una comparativa de Vast.ai y RunPod, fiabilidad y una lista de pasos para migrar.
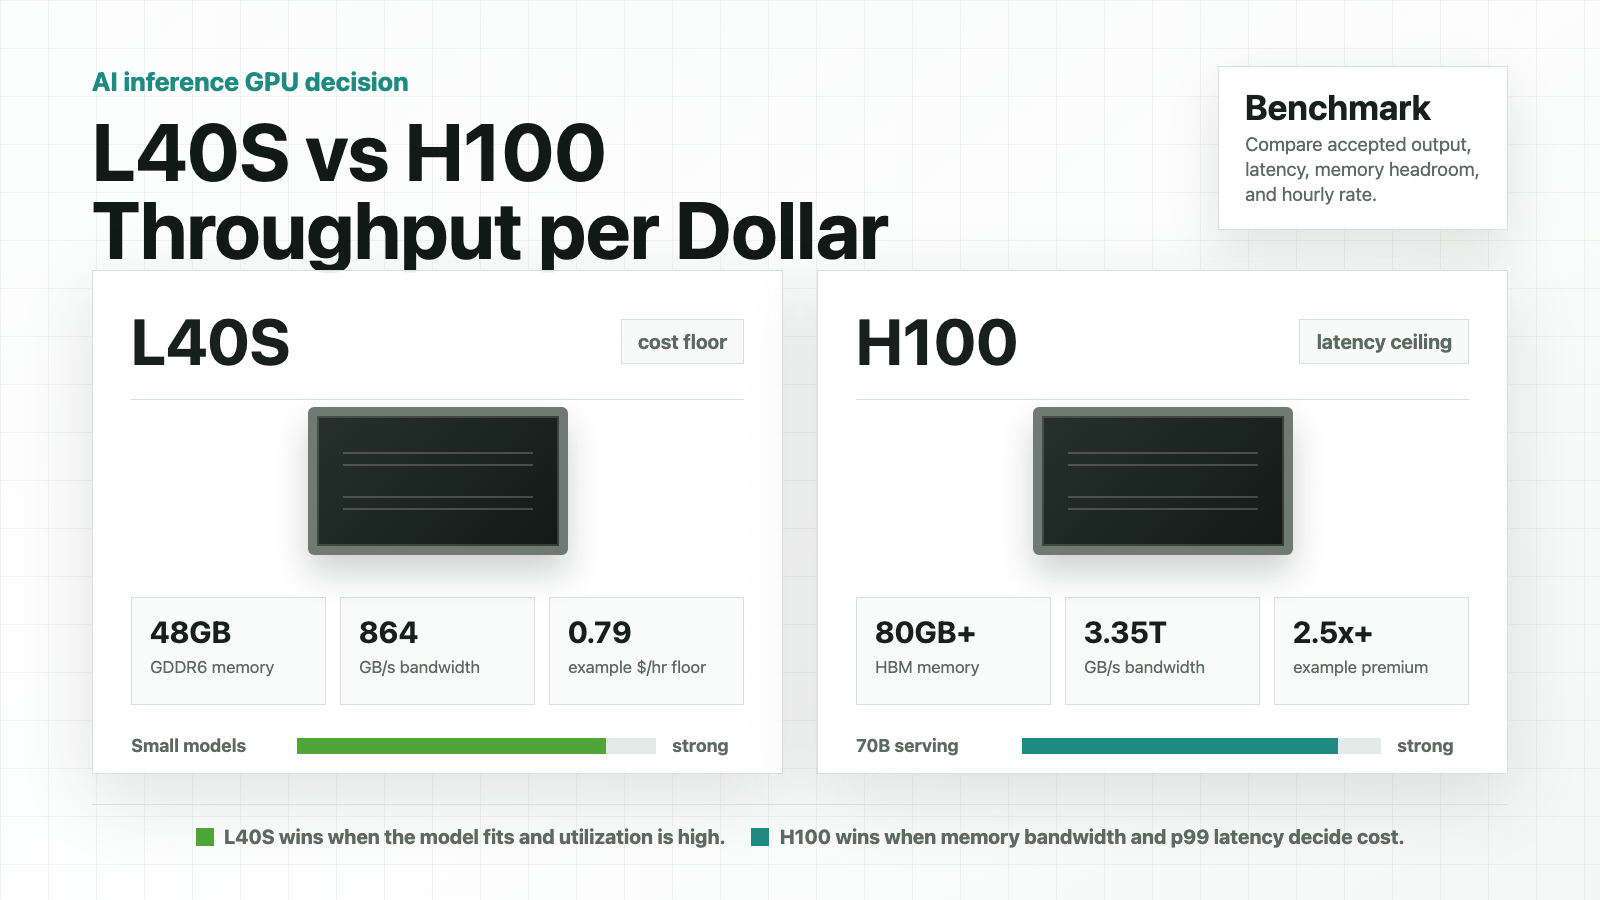
NVIDIA L40S vs H100 para inferencia de IA: rendimiento por dólar
Una comparación práctica entre L40S y H100 para equipos de IA que evalúan rendimiento de inferencia, latencia, ajuste de memoria y coste de GPU en la nube por salida aceptada.
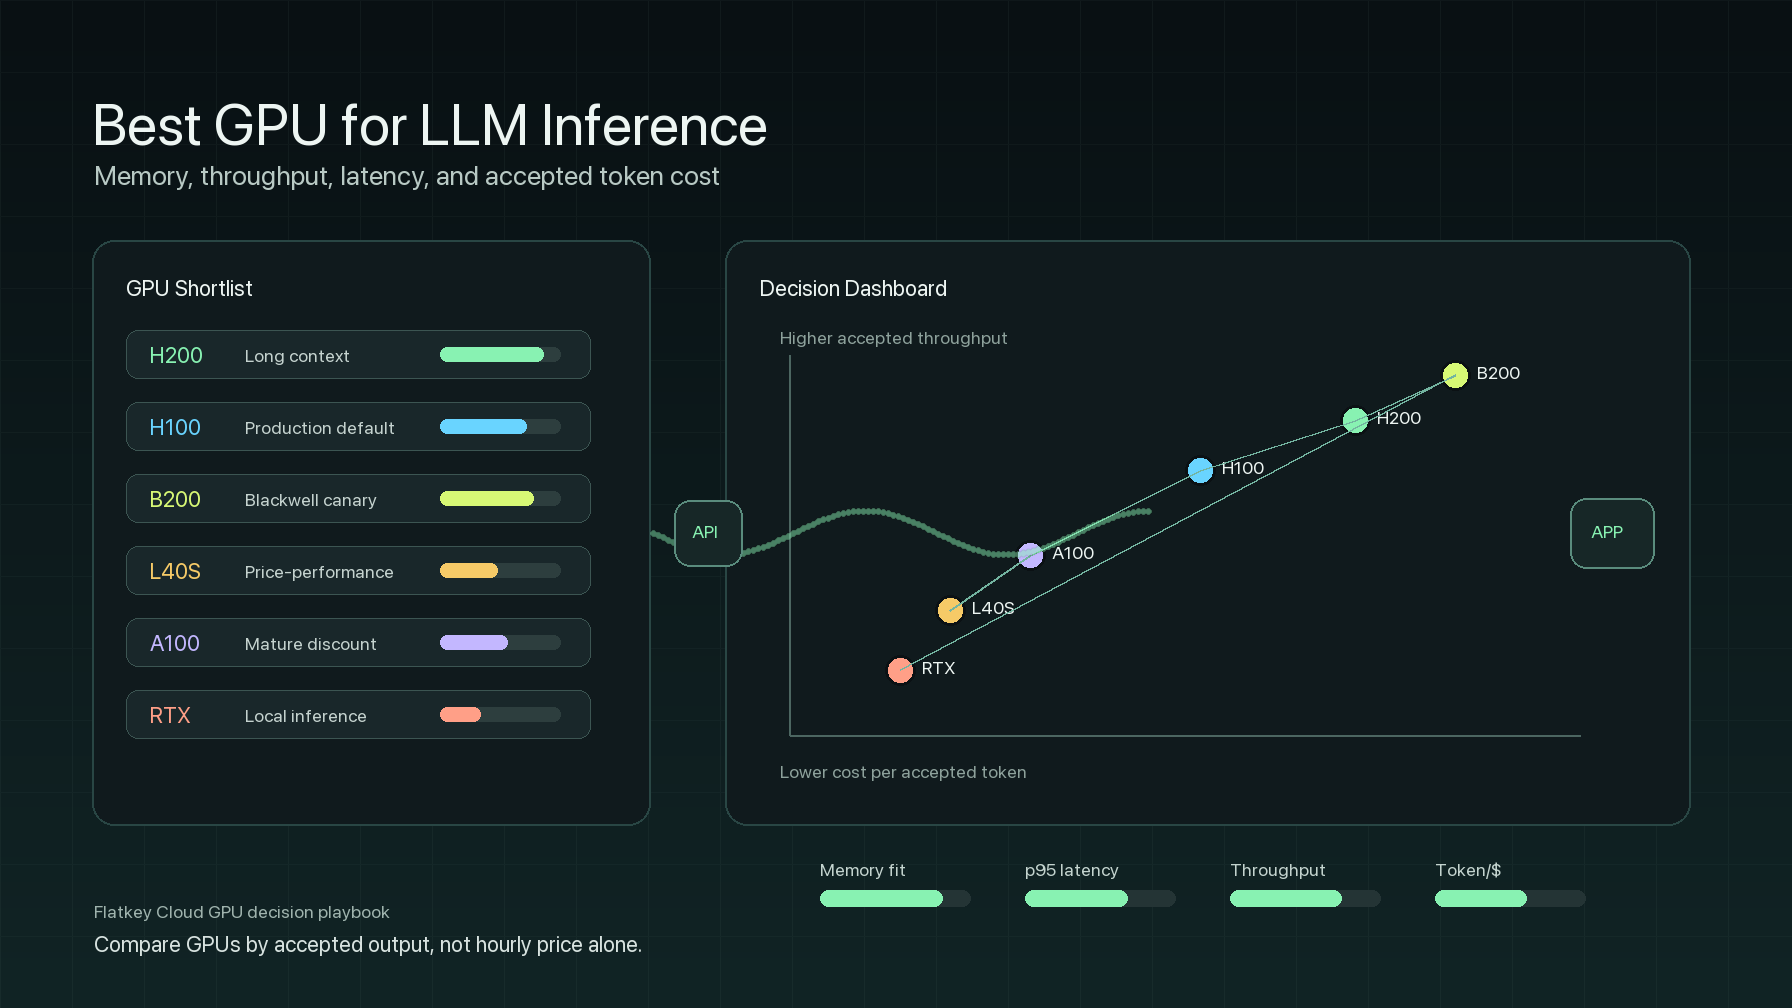
Mejor GPU para Inferencia de LLM: Memoria, Rendimento, Latencia y Costo
Una guía práctica de selección de GPU para equipos empresariales de inferencia de LLM, comparando H100, H200, B200, A100, L40S, GPUs locales de la clase RTX, tokens por dólar, latencia p95, adecuación de memoria y costo por token aceptado.
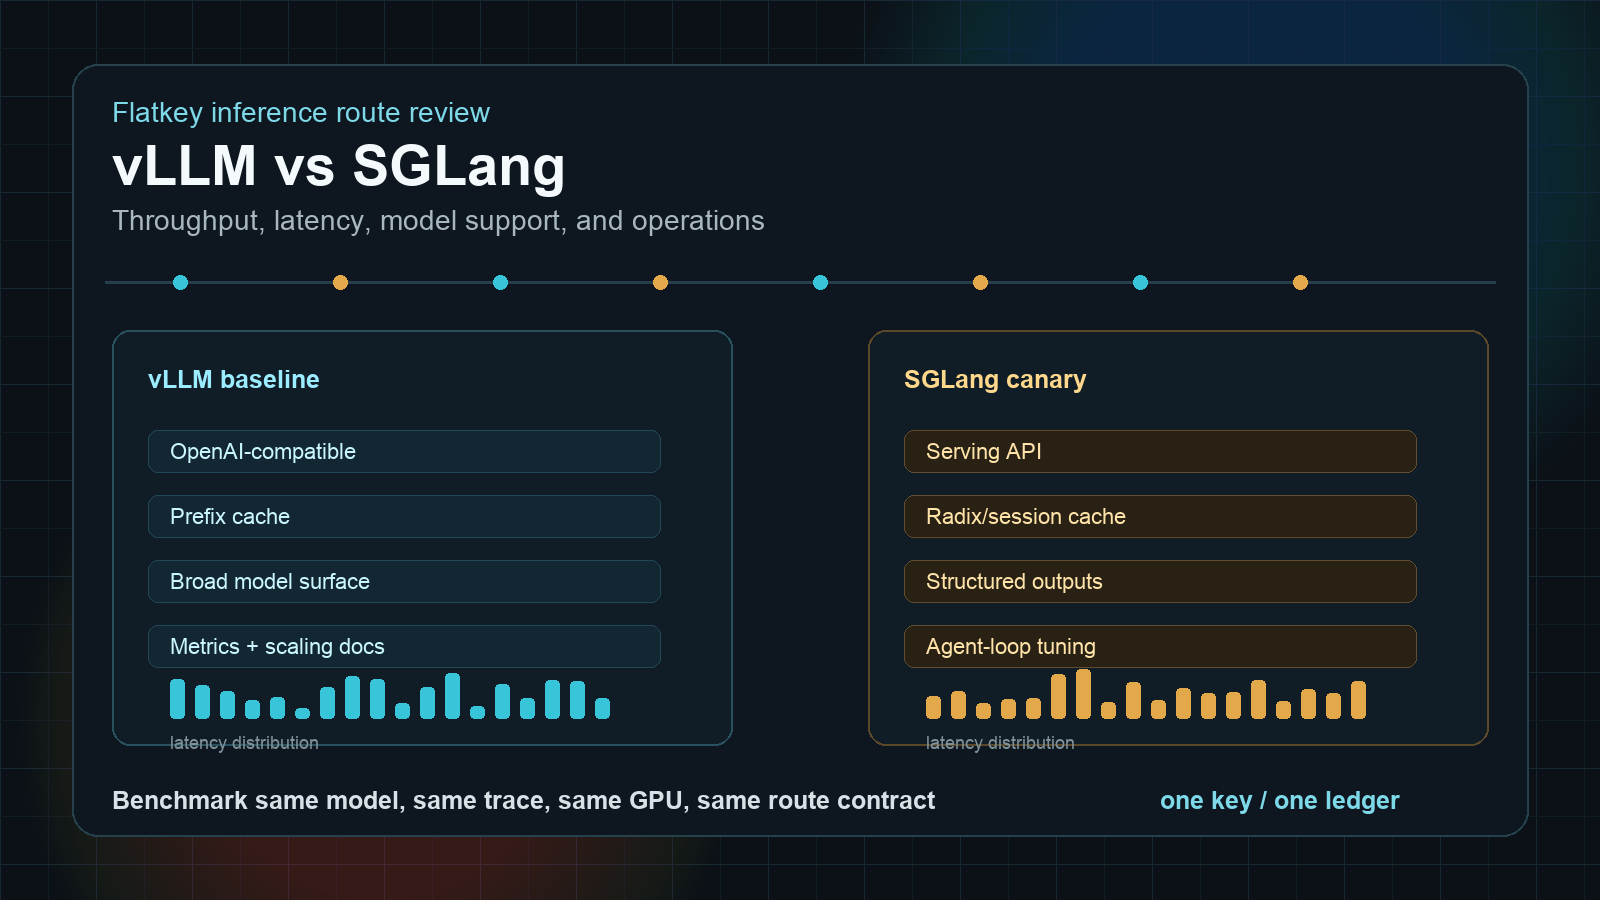
vLLM vs SGLang: rendimiento, latencia, compatibilidad de modelos y operaciones
Compara SGLang y vLLM para inferencia en GPU en la nube: rendimiento, latencia, compatibilidad de modelos, operaciones, benchmarks y cuándo Ollama encaja para pruebas locales.
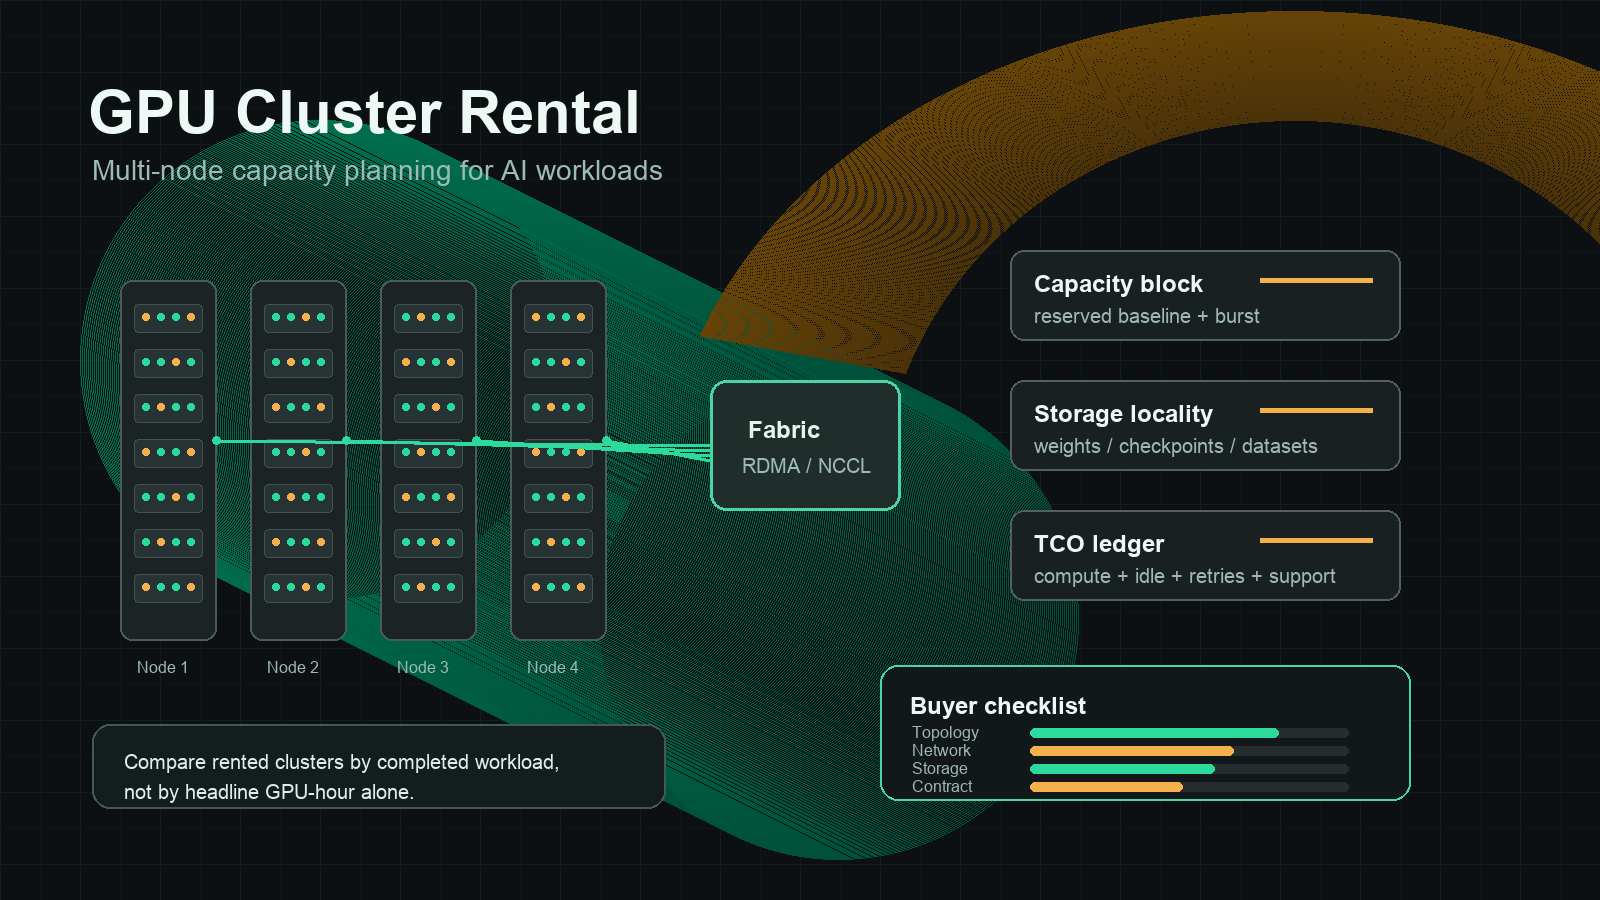
Alquiler de clústeres GPU: guía para compradores sobre capacidad de IA multinodo
Una guía para compradores dirigida a equipos de IA empresariales que evalúan el alquiler de clústeres GPU multinodo, proveedores cloud, capacidad reservada, fabric de red, almacenamiento y TCO.

H200 vs H100 (2026): especificaciones, rendimiento real, precio por hora y cuál alquilar
NVIDIA H200 vs H100 en 2026: especificaciones oficiales, por qué 141GB importan para la inferencia de modelos de 70B, precios reales por hora de Flatkey Compute, RunPod y Lambda, alternativas Blackwell y recomendaciones según la carga de trabajo.
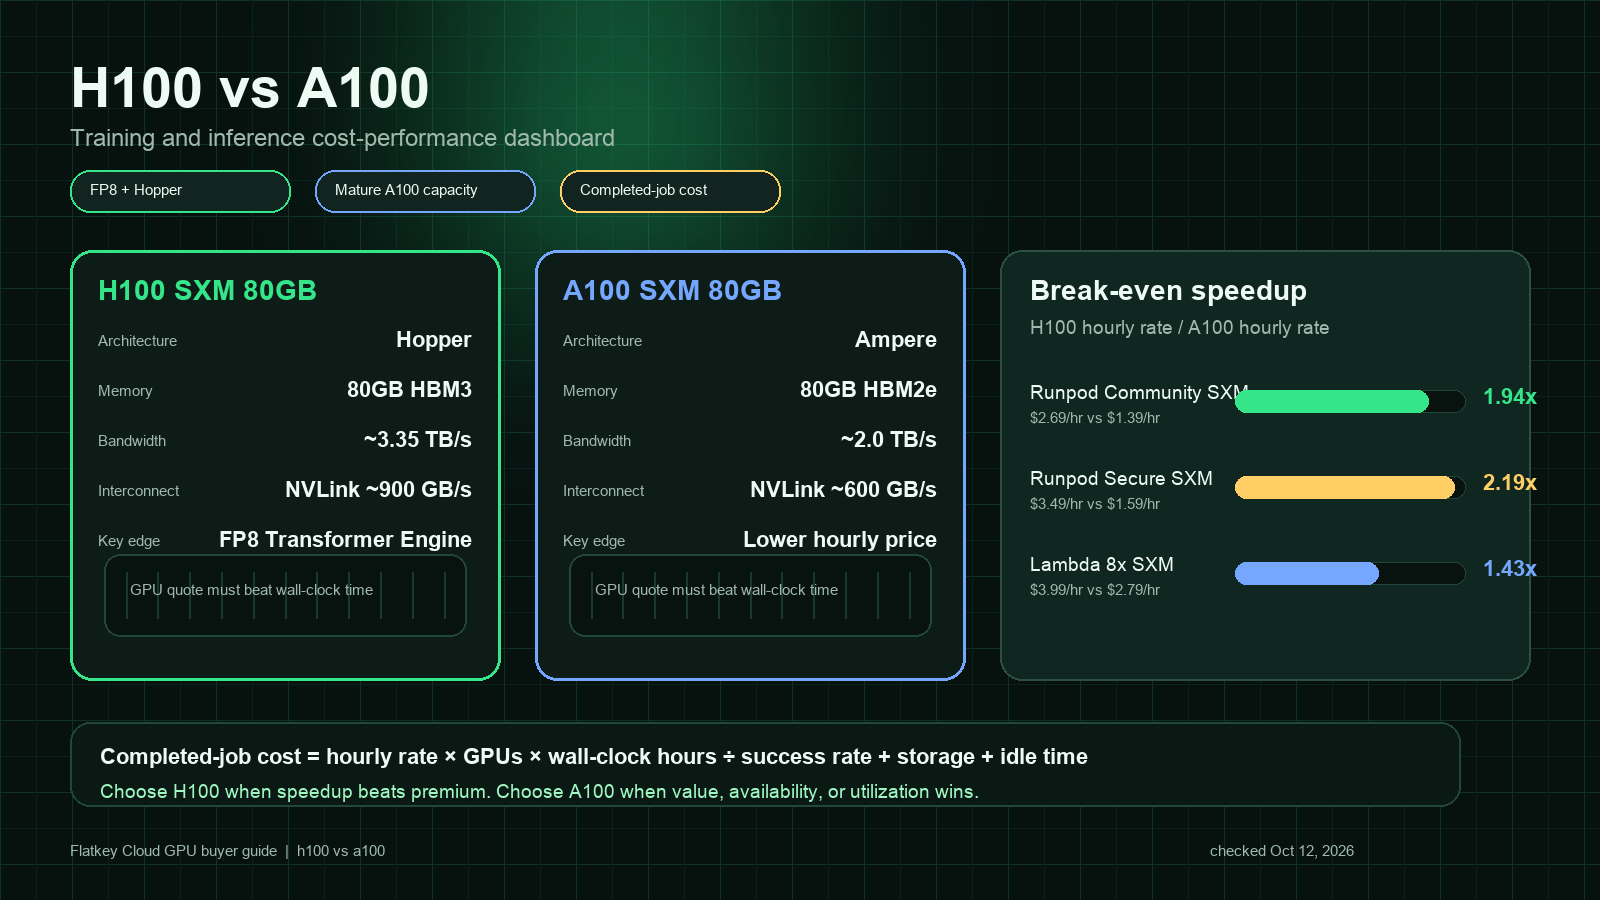
NVIDIA H100 vs A100: Rendimiento de costo en entrenamiento e inferencia
Una comparación práctica entre H100 y A100 para equipos de IA que deciden entre el rendimiento de Hopper y el valor de Ampere en entrenamiento, inferencia y alquiler de GPU en la nube.
Crea más rápido con una sola pasarela de IA.
Usa flatkey.ai para gestionar modelos, claves, facturación y observabilidad desde una plataforma API.
Empezar