
Costes, facturación y operaciones
Últimos artículos en Costes, facturación y operaciones.
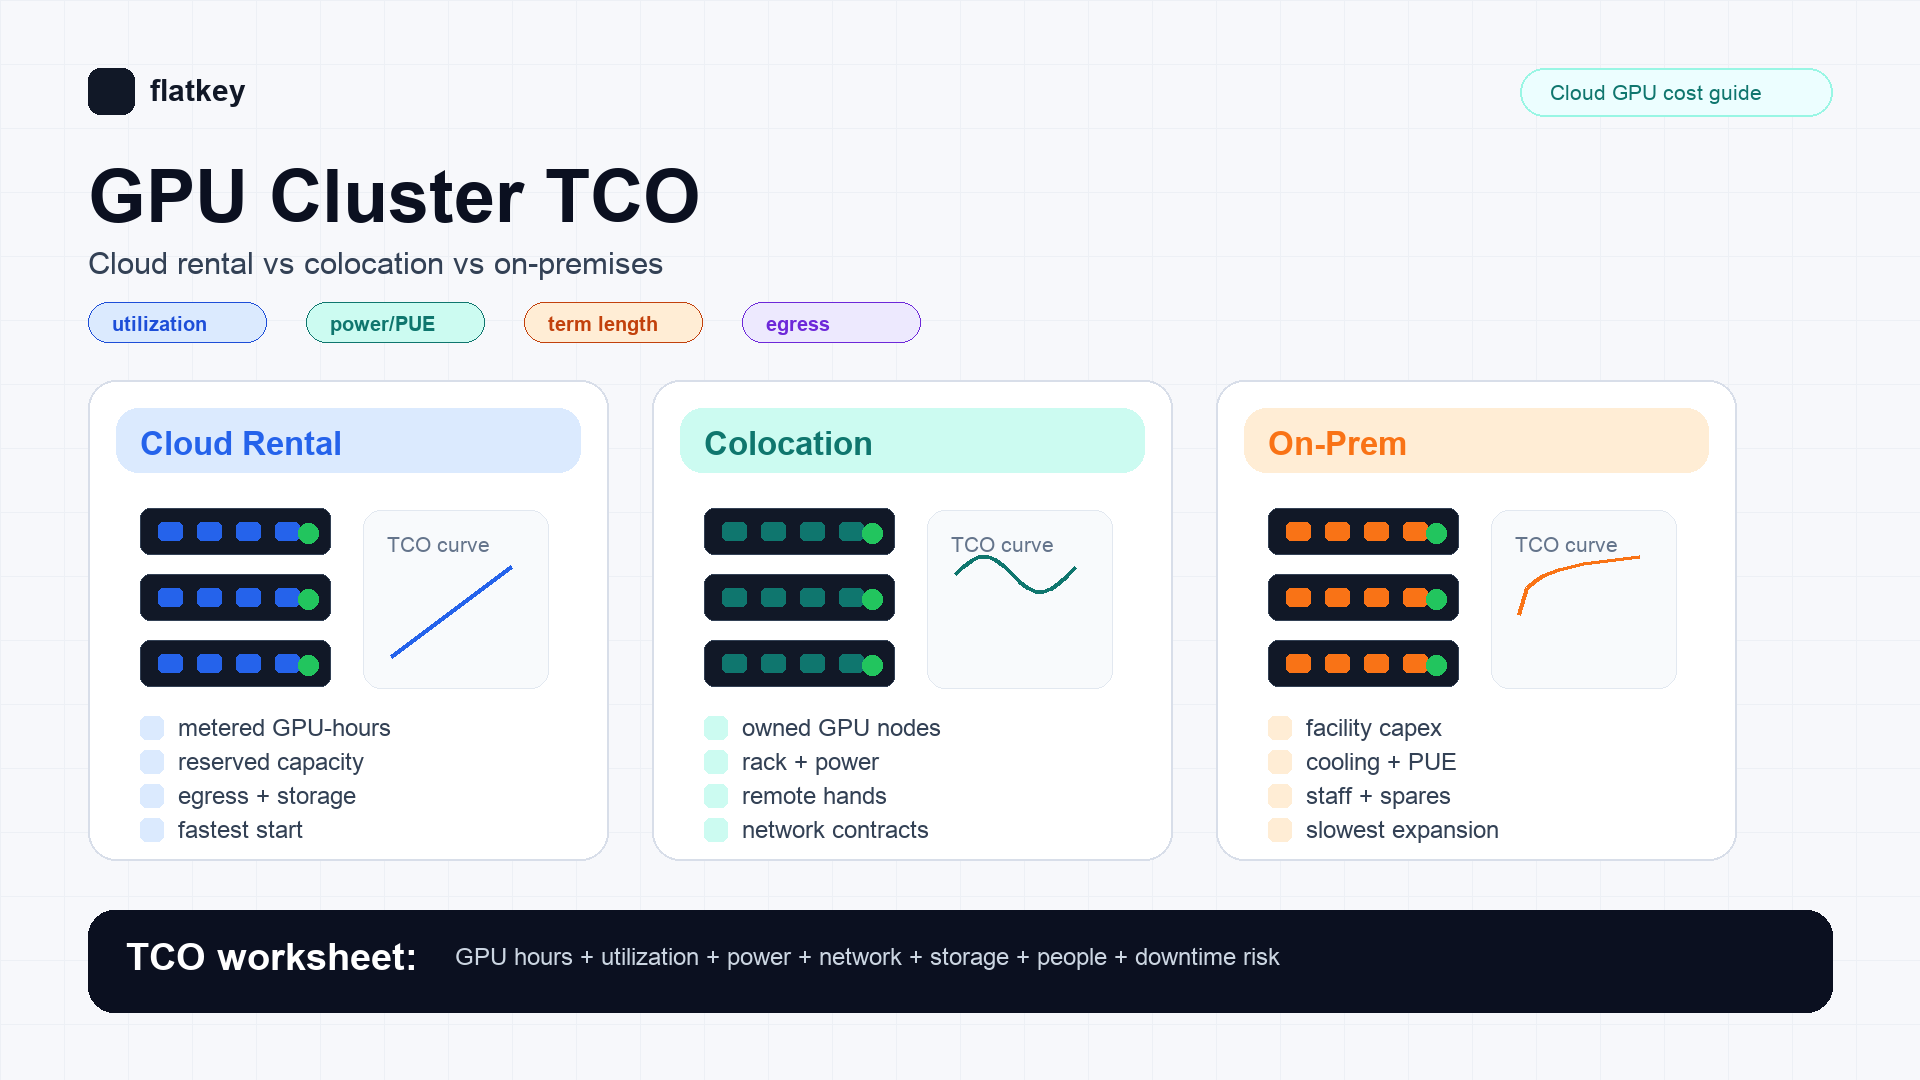
TCO de clústeres GPU: alquiler en la nube vs colocation vs on-premises
Compara el TCO de clústeres GPU entre alquiler en la nube, colocation y on-premises con una hoja de trabajo FinOps práctica para compradores de infraestructura de IA.
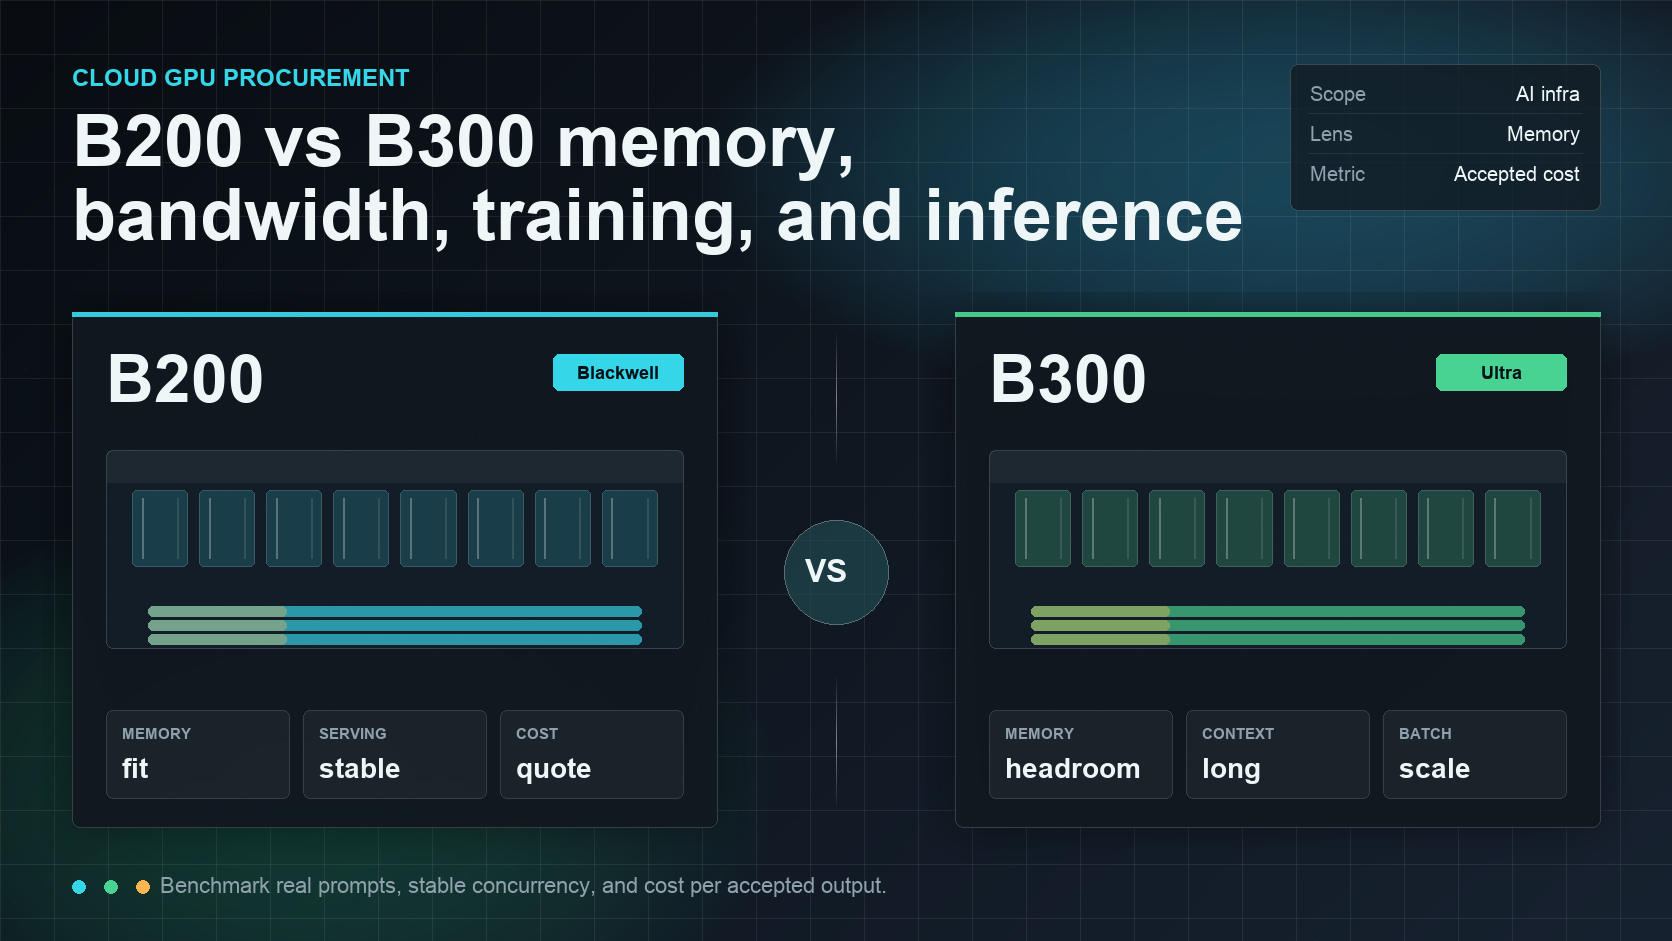
NVIDIA B300 vs B200: Memoria, ancho de banda, entrenamiento e inferencia
Una comparación práctica entre B200 y B300 para equipos de infraestructura de ML que evalúan la memoria, el ancho de banda, el entrenamiento, la inferencia y la economía de adquisición de las GPU NVIDIA Blackwell.
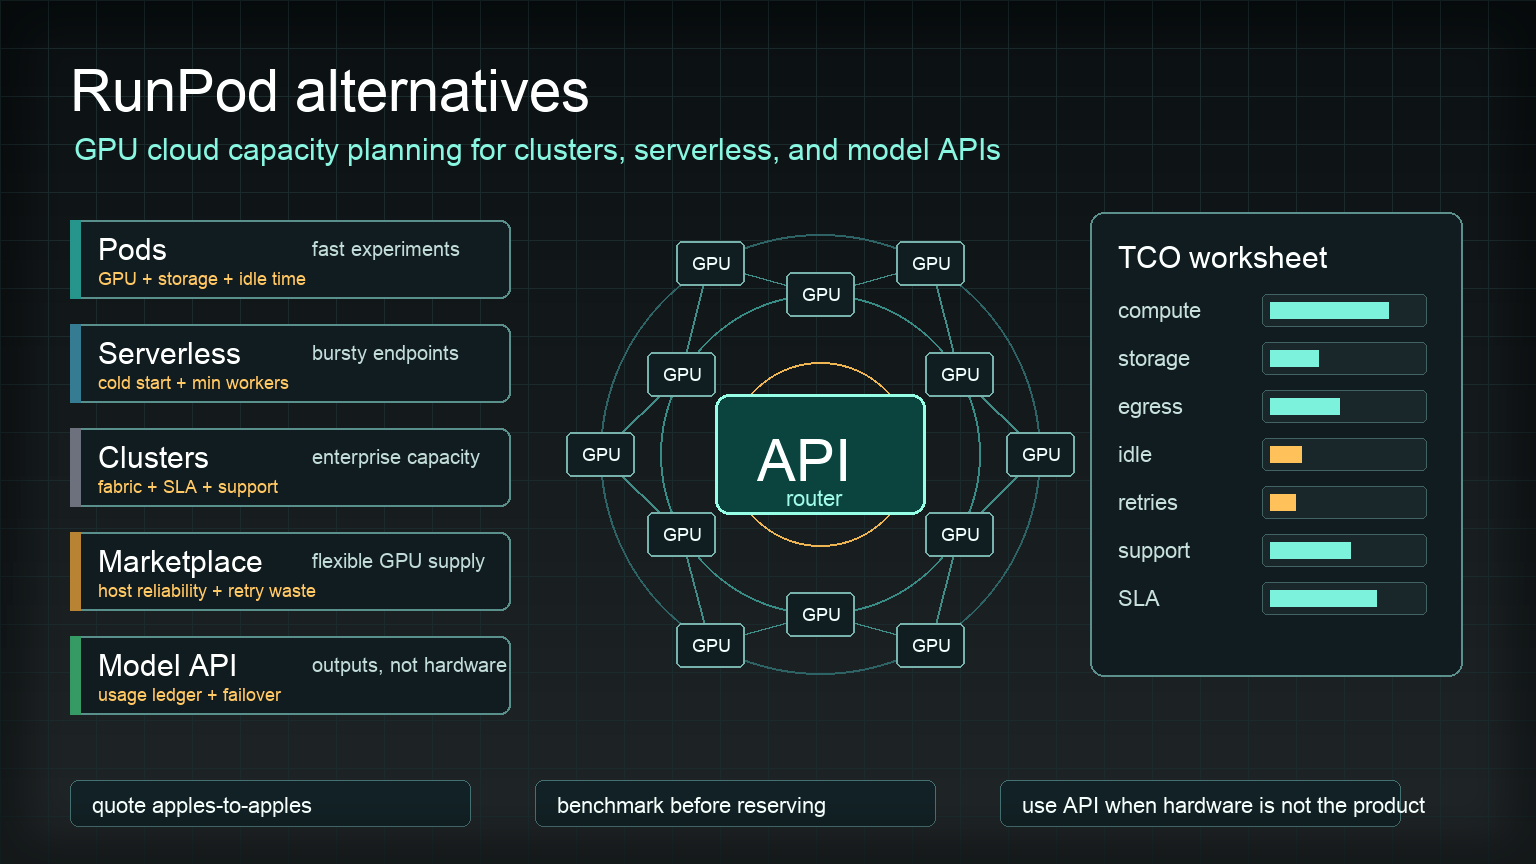
Las 10 mejores alternativas a RunPod en 2026: precios, ventajas y cuál elegir
Compara 10 alternativas a RunPod con precios de GPU de octubre de 2026: los mercados más baratos, nubes GPU estables, plataformas serverless y API de modelos, además de una comparativa de Vast.ai y RunPod, fiabilidad y una lista de pasos para migrar.
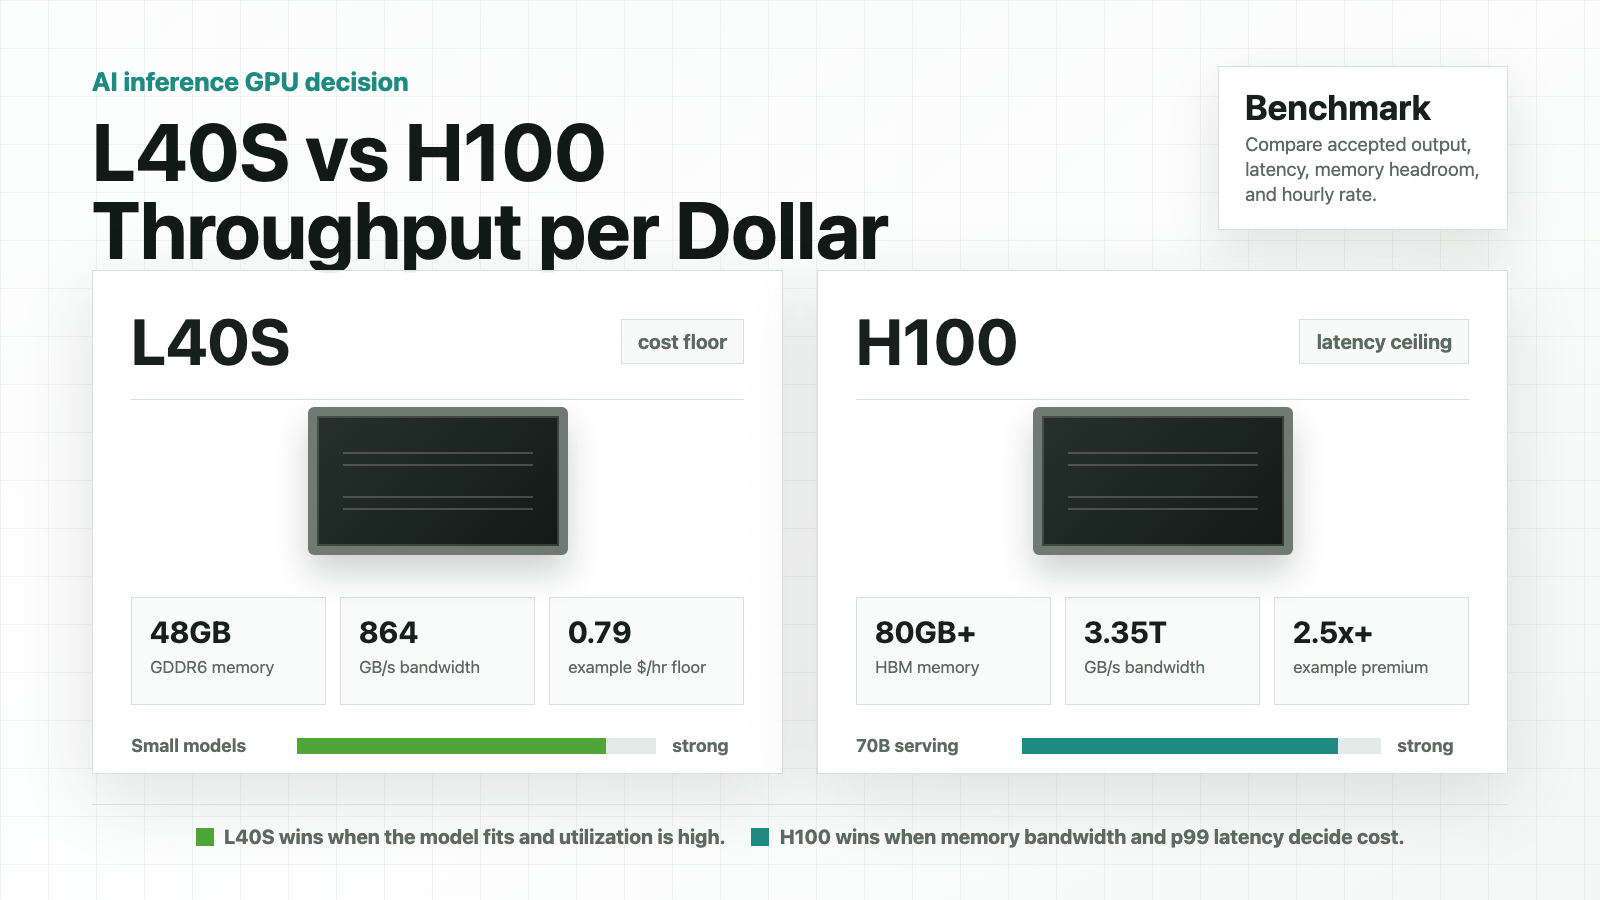
NVIDIA L40S vs H100 para inferencia de IA: rendimiento por dólar
Una comparación práctica entre L40S y H100 para equipos de IA que evalúan rendimiento de inferencia, latencia, ajuste de memoria y coste de GPU en la nube por salida aceptada.
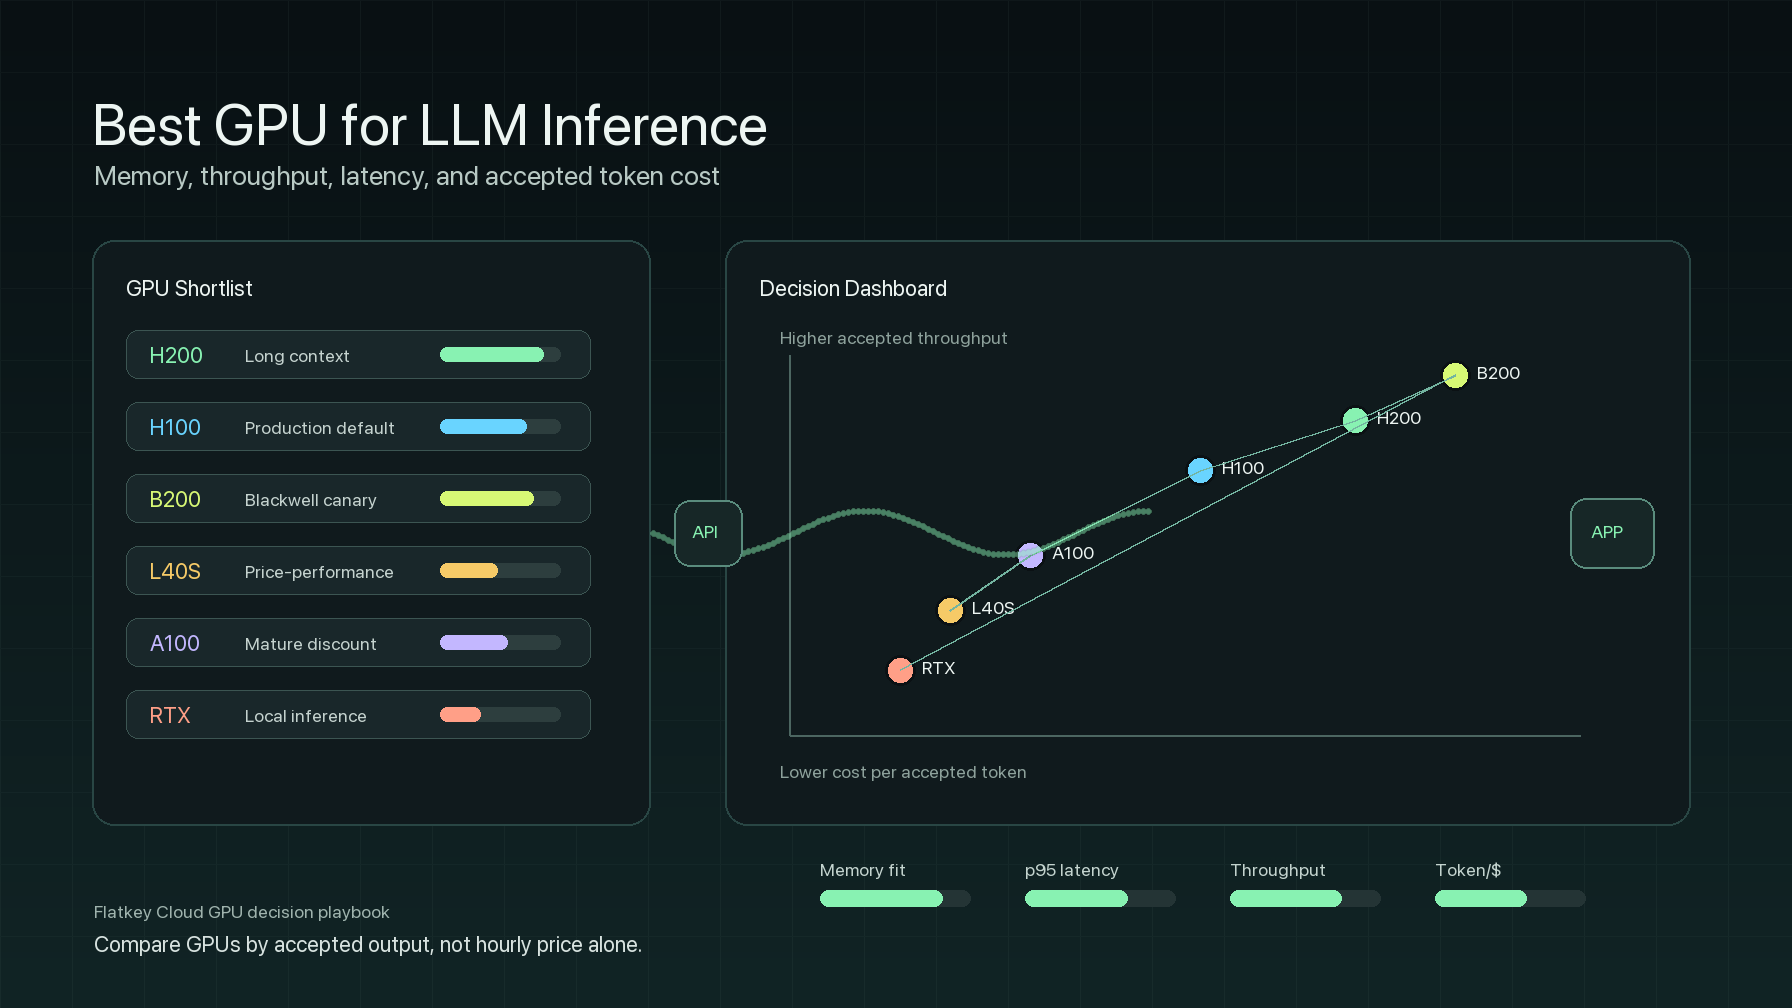
Mejor GPU para Inferencia de LLM: Memoria, Rendimento, Latencia y Costo
Una guía práctica de selección de GPU para equipos empresariales de inferencia de LLM, comparando H100, H200, B200, A100, L40S, GPUs locales de la clase RTX, tokens por dólar, latencia p95, adecuación de memoria y costo por token aceptado.
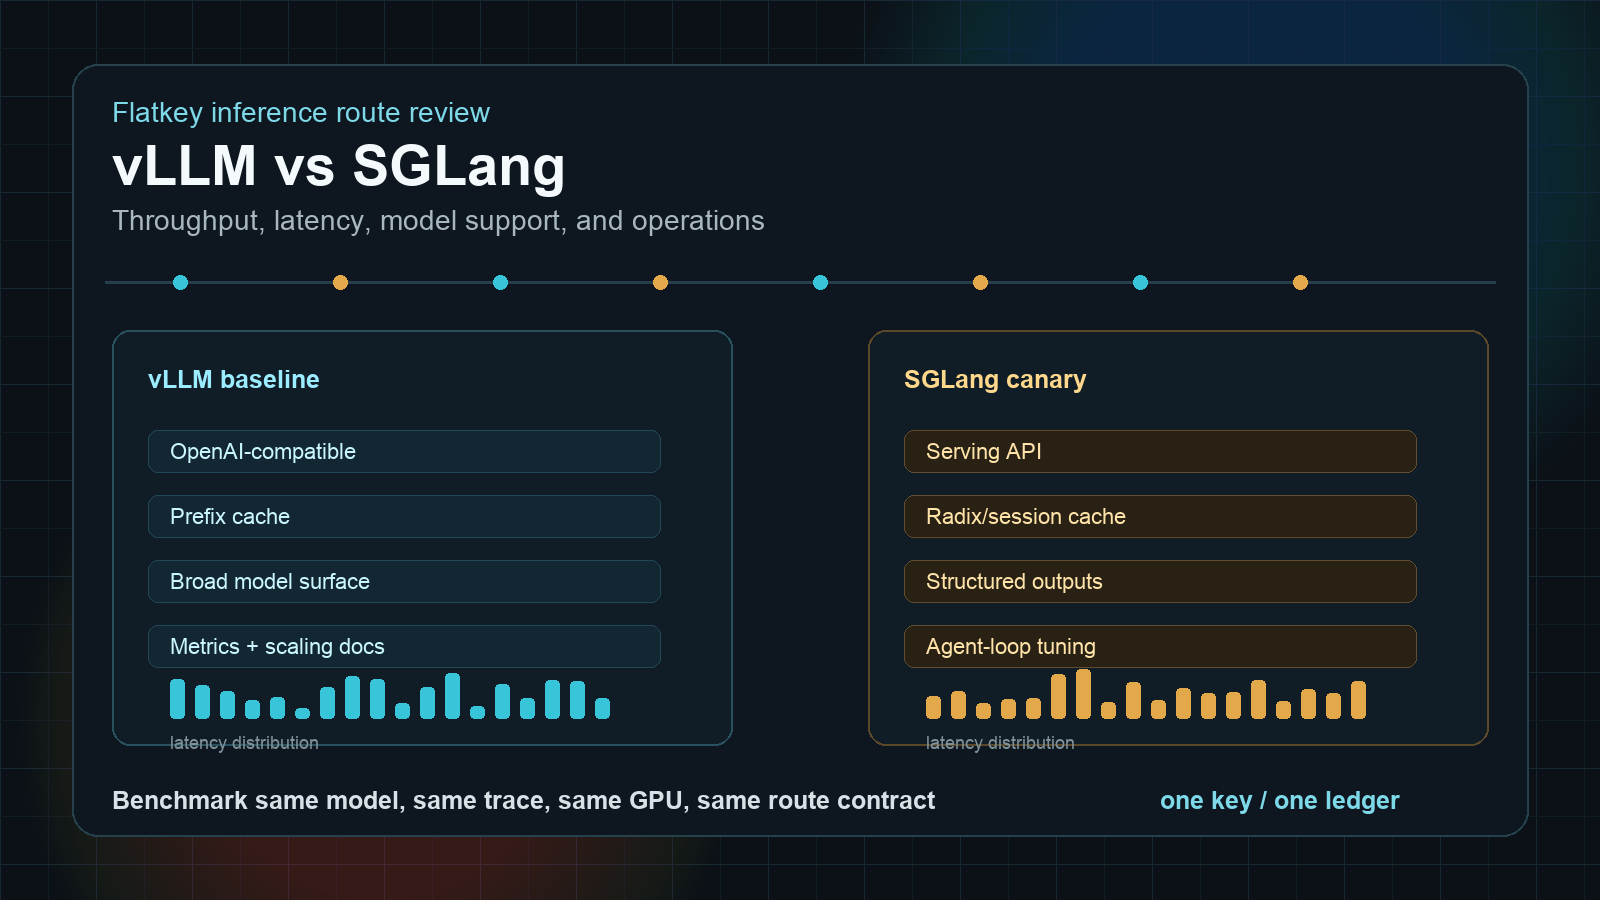
vLLM vs SGLang: rendimiento, latencia, compatibilidad de modelos y operaciones
Compara SGLang y vLLM para inferencia en GPU en la nube: rendimiento, latencia, compatibilidad de modelos, operaciones, benchmarks y cuándo Ollama encaja para pruebas locales.
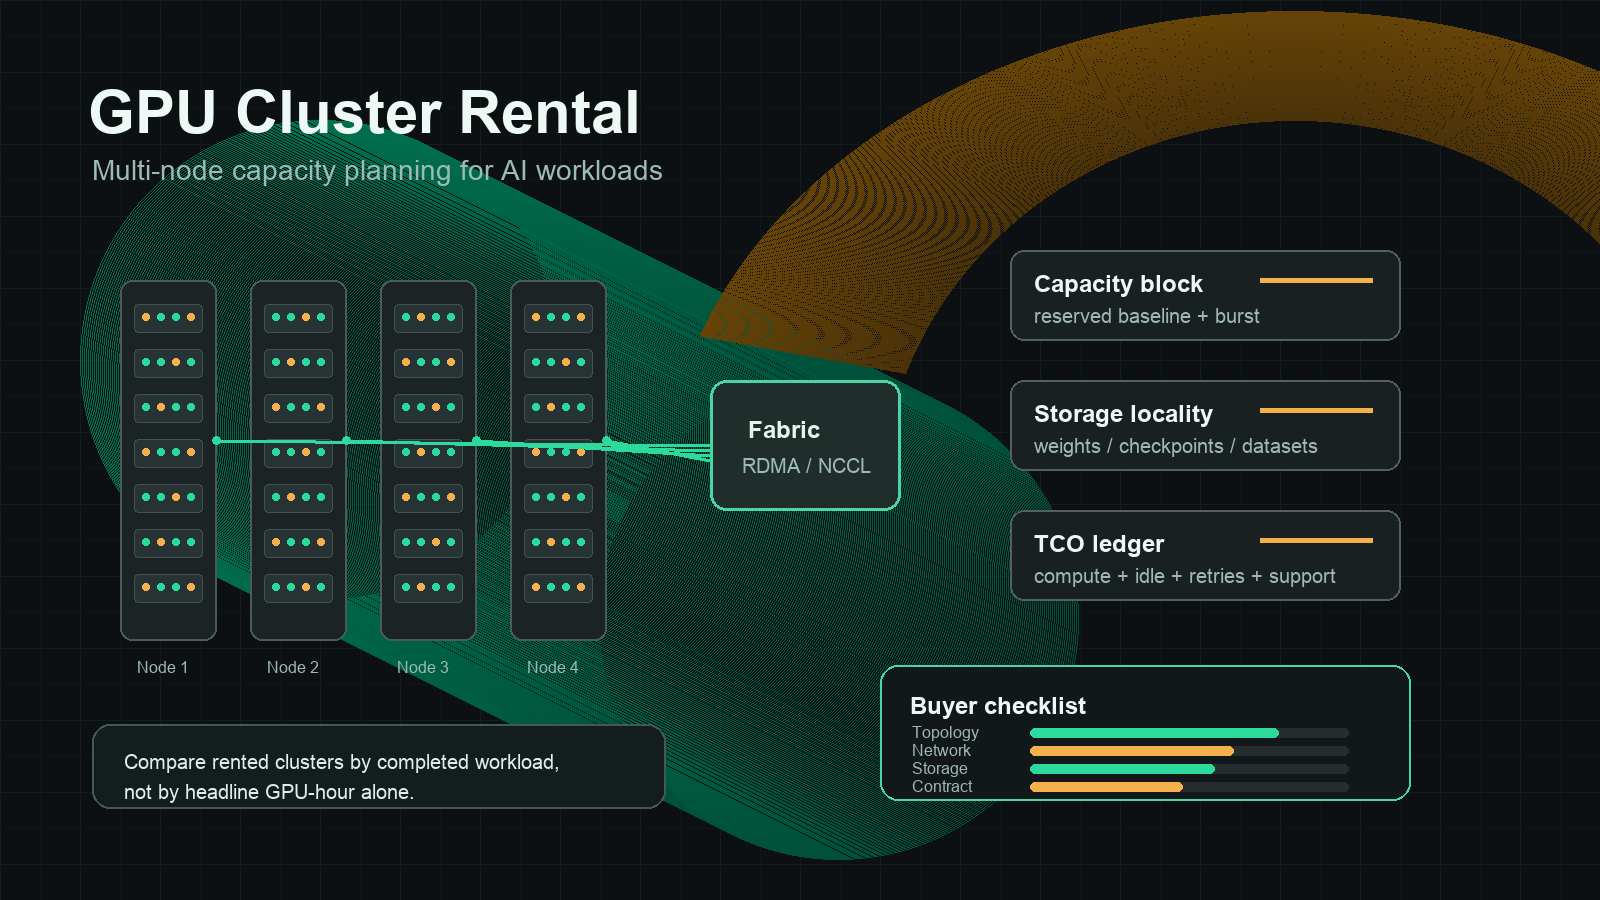
Alquiler de clústeres GPU: guía para compradores sobre capacidad de IA multinodo
Una guía para compradores dirigida a equipos de IA empresariales que evalúan el alquiler de clústeres GPU multinodo, proveedores cloud, capacidad reservada, fabric de red, almacenamiento y TCO.

H200 vs H100 (2026): especificaciones, rendimiento real, precio por hora y cuál alquilar
NVIDIA H200 vs H100 en 2026: especificaciones oficiales, por qué 141GB importan para la inferencia de modelos de 70B, precios reales por hora de Flatkey Compute, RunPod y Lambda, alternativas Blackwell y recomendaciones según la carga de trabajo.
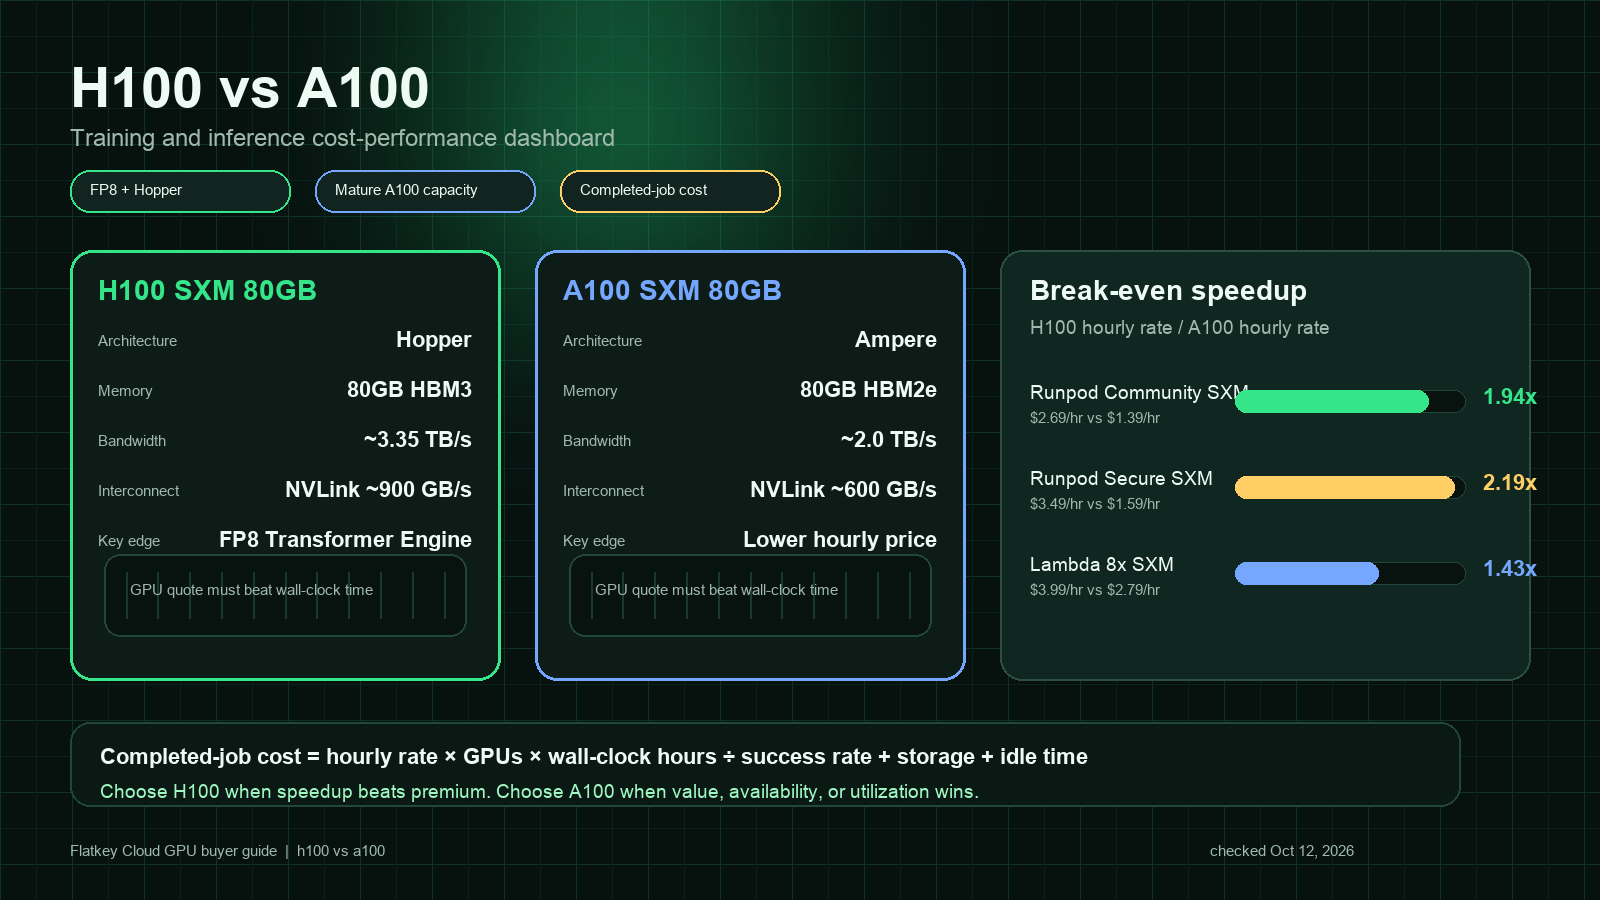
NVIDIA H100 vs A100: Rendimiento de costo en entrenamiento e inferencia
Una comparación práctica entre H100 y A100 para equipos de IA que deciden entre el rendimiento de Hopper y el valor de Ampere en entrenamiento, inferencia y alquiler de GPU en la nube.
Precios de alquiler de GPU explicados: bajo demanda, spot, reservado y costes ocultos
Una guía práctica para comparar los precios de alquiler de GPU según el coste del trabajo completado, no solo las tarifas por hora, con comprobaciones de fuentes para modelos bajo demanda, spot, reservados, de marketplace y de costes ocultos.
API de LLM gratis (2026): 10 opciones comparadas por límites reales, modelos y letra pequeña
Diez APIs de LLM gratuitas verificadas en la documentación oficial en octubre de 2026: qué es gratis, los límites exactos, la letra pequeña y código para alternar entre ellas.

Comparación de precios de modelos de IA: costos de tokens, imágenes y video en un solo panel
Compara precios de modelos de IA entre rutas de texto, imagen, video y API de varios proveedores con un panel para ver el costo por resultado aceptado.
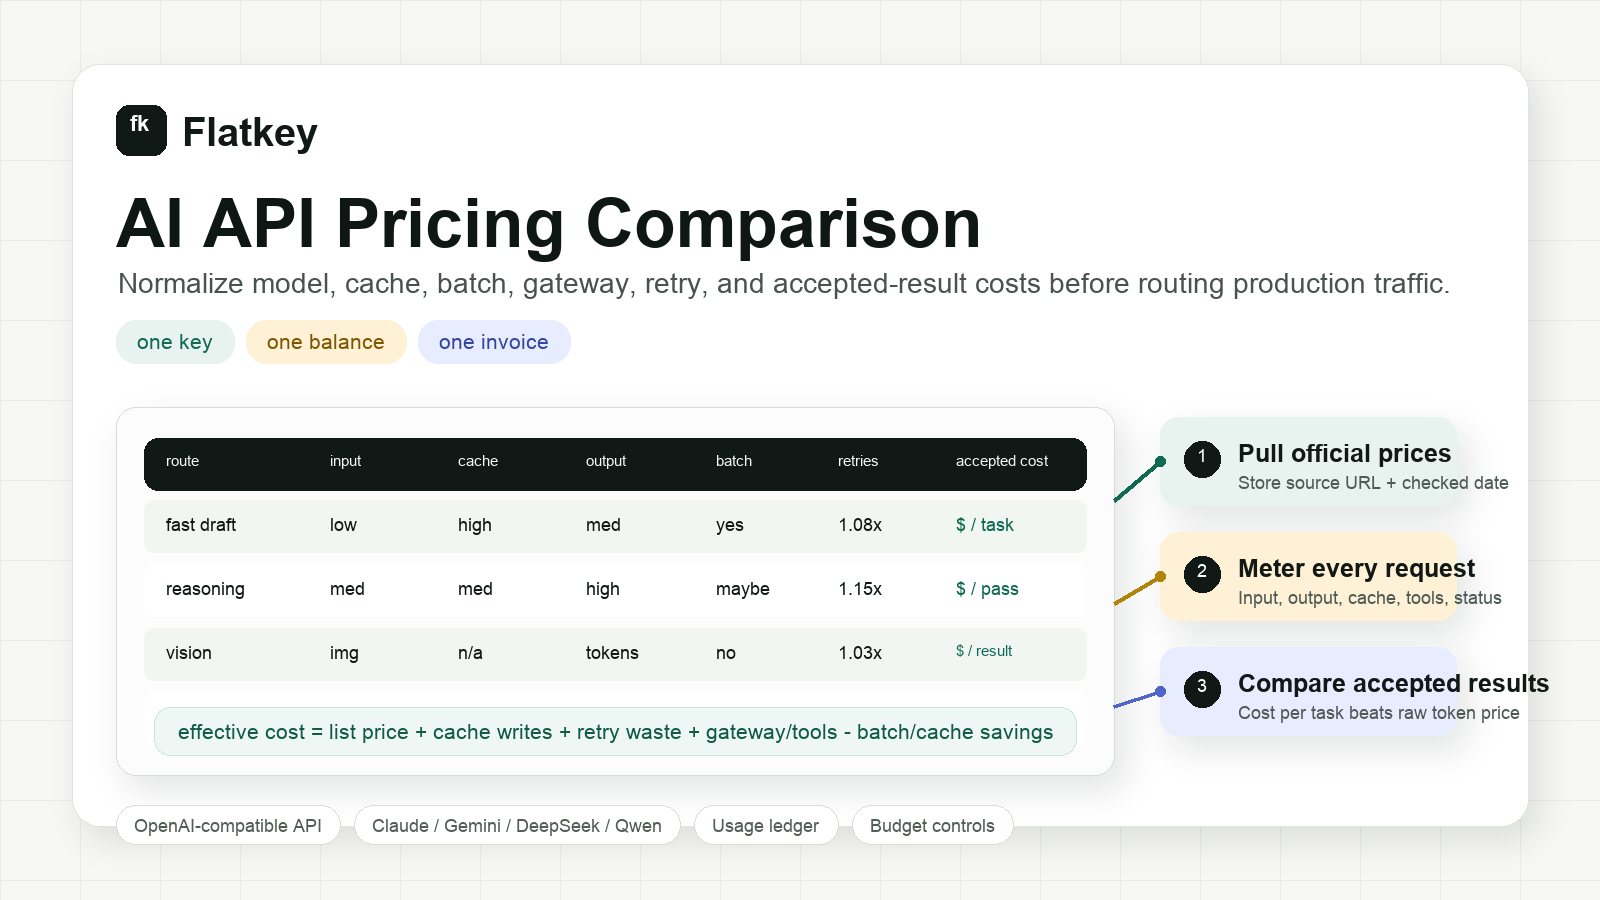
Comparación de precios de API de IA: costos de modelo, caché, lote y gateway
Un marco práctico de comparación de precios de API de IA para desarrolladores, equipos de producto y equipos de compras, que compara costos de modelo, caché, lote, gateway, reintentos y resultados aceptados.
¿Qué modelo Claude es mejor para programar? Opus 5.5 vs Sonnet 5.5 vs Haiku 5.5 vs Fable 5.1 (2026)
¿Qué modelo Claude deberías usar para programar en 2026? Una guía por tareas de Opus 5.5, Sonnet 5.5, Haiku 5.5 y Fable 5.1, con precios oficiales, cálculos del coste por sesión, alias de Claude Code y ejemplos de API listos para ejecutar.
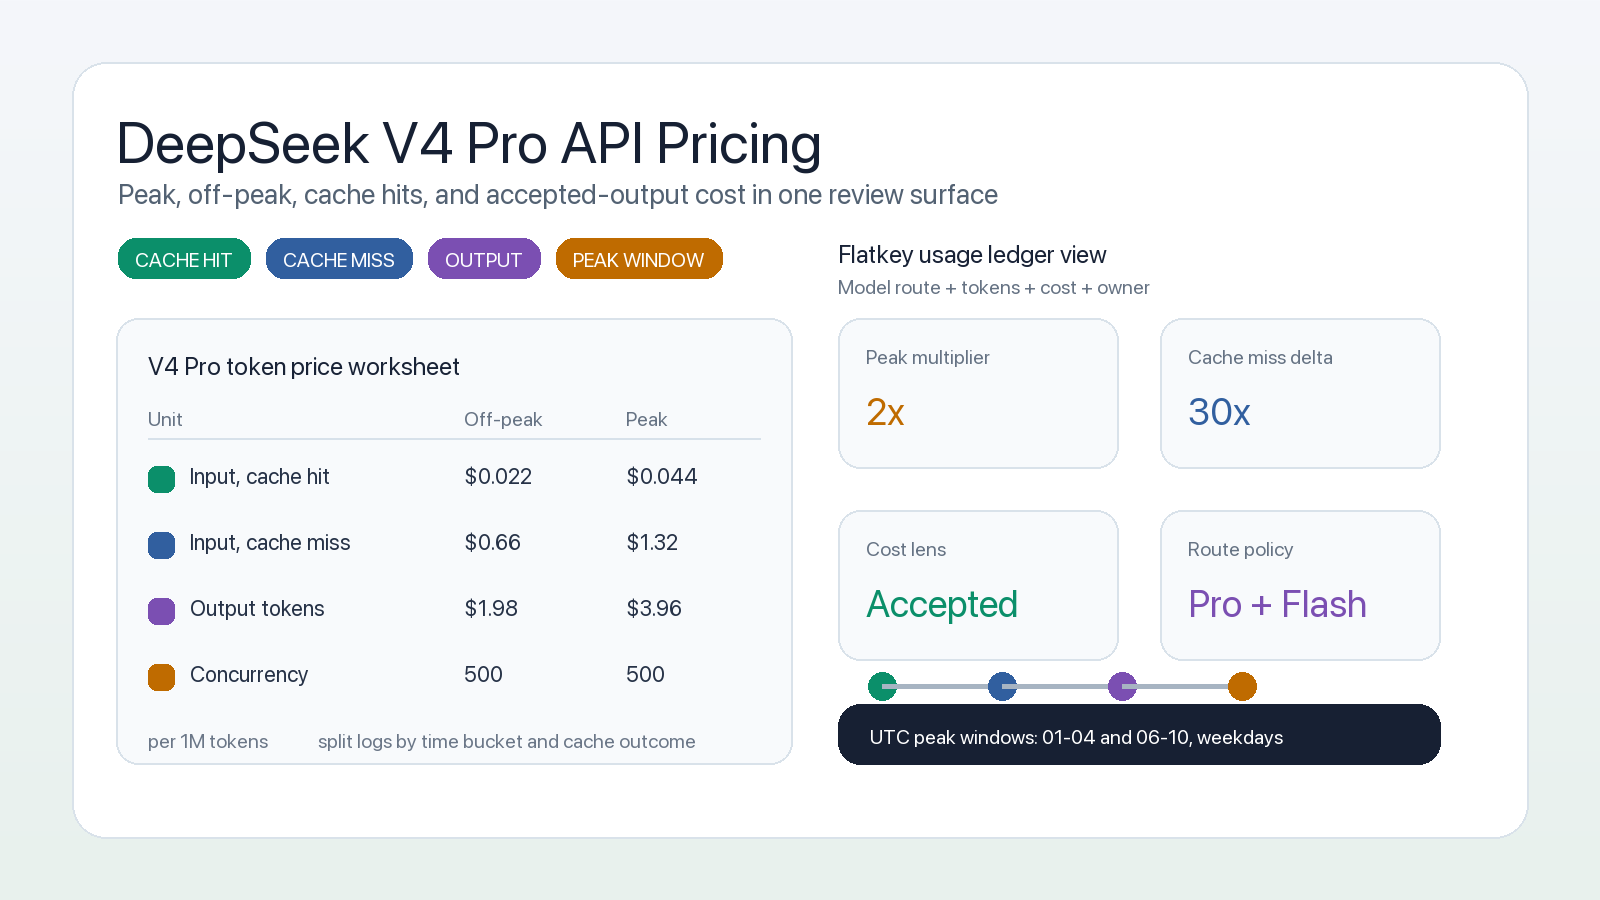
Precios de la API de DeepSeek V4 Pro: pico, valle y costes de caché
Precios actuales de la API de DeepSeek V4 Pro con tarifas en horas punta y valle, cálculo de aciertos de caché y una hoja de control de costes para equipos de desarrollo y compras.
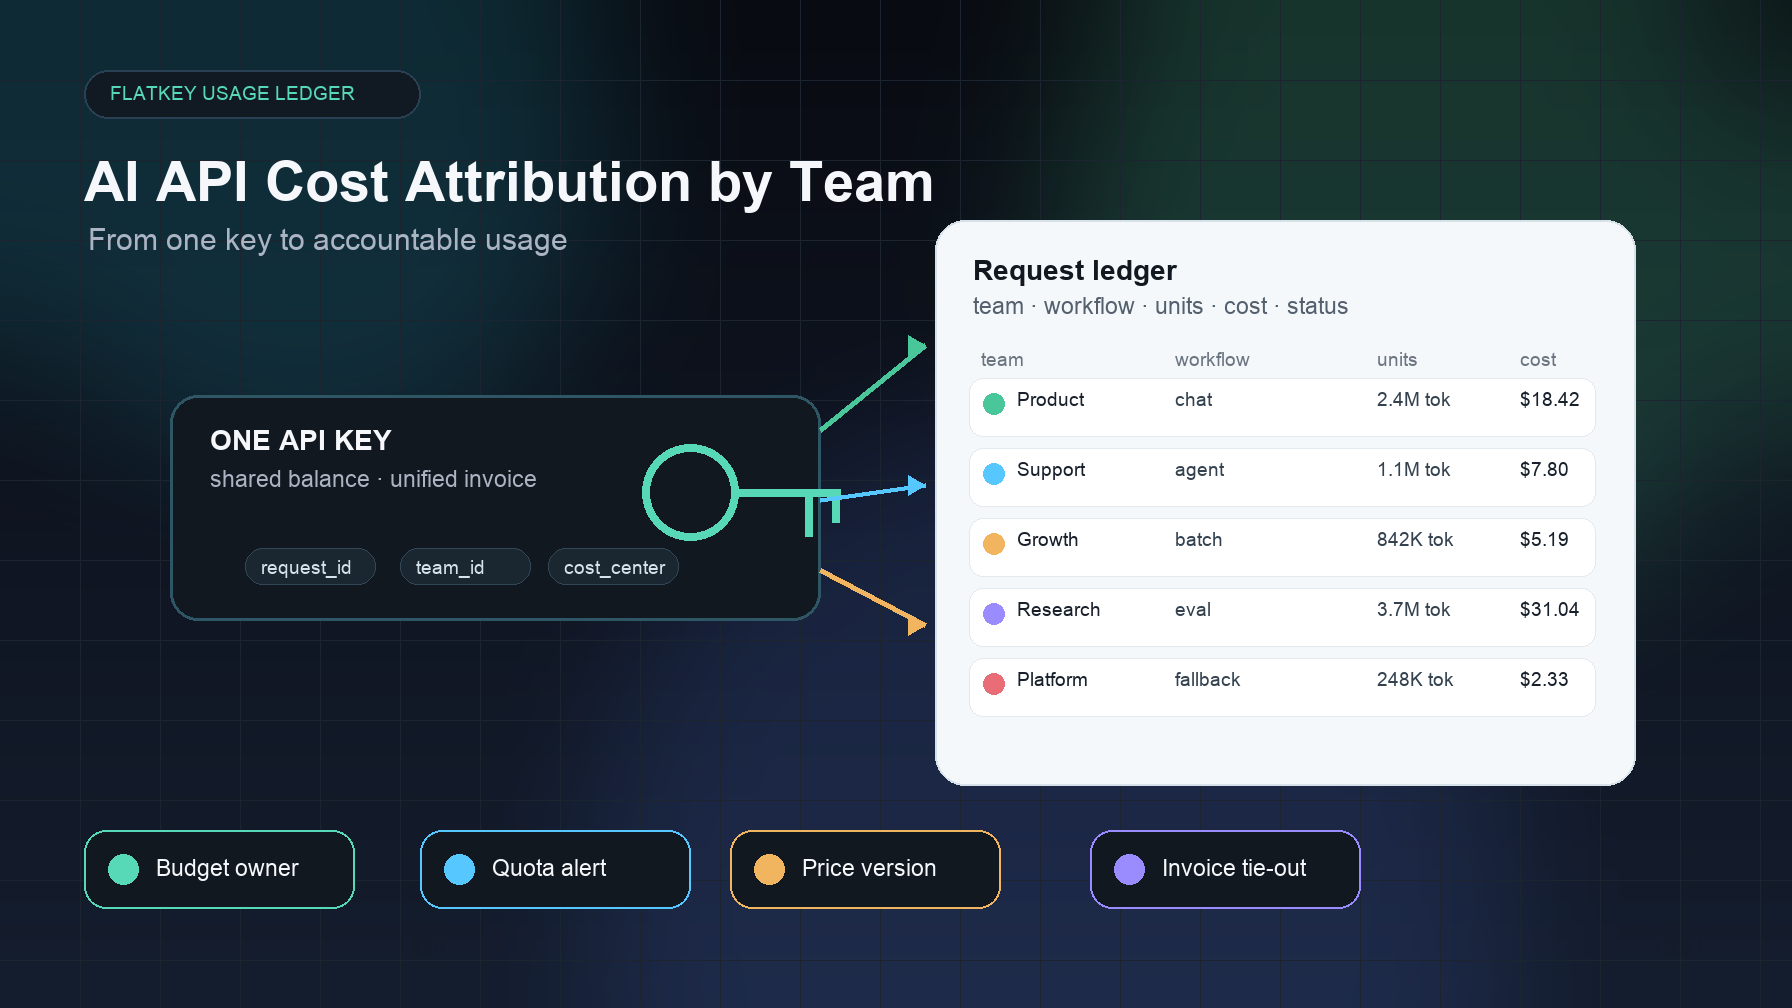
Atribución de costos de API de IA por equipo: de una sola clave al uso responsable
Implementa la atribución de costos de API de IA por equipo con etiquetas de solicitud, límites de subclaves, registros de uso, cuotas y revisión financiera mensual.
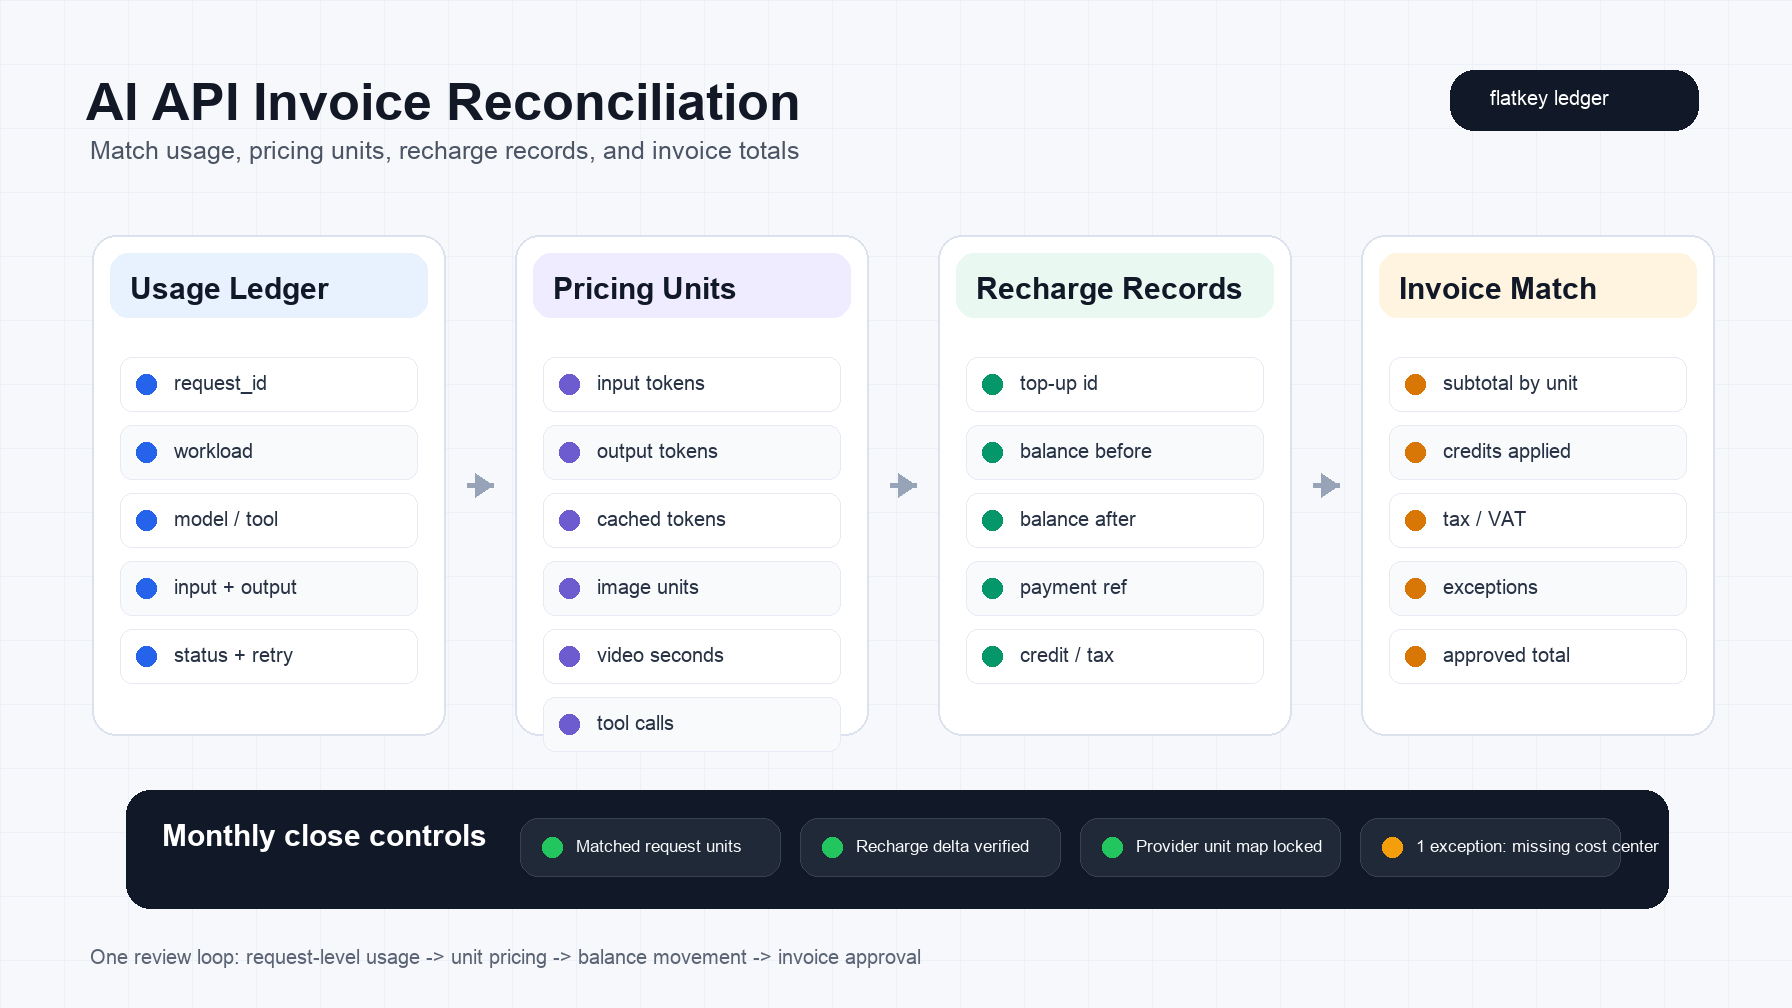
Reconciliación de facturas de API de IA: coincidir uso, unidades de precio y registros de recarga
Reconcilia facturas de API de IA cotejando libros de uso, unidades de precio, registros de recarga, movimiento de saldo, créditos, impuestos y totales de factura.

Precios de la API de Anthropic (octubre de 2026): cada modelo Claude, caché, Batch y cálculo de costes
Todos los precios de la API de Anthropic en octubre de 2026, de Haiku 5.5 a $0,10/$0,50 a Fable 5.1 a $10/$50, con caché, Batch API, residencia de datos, modo rápido, límites de gasto y presupuestos mensuales.
Crea más rápido con una sola pasarela de IA.
Usa flatkey.ai para gestionar modelos, claves, facturación y observabilidad desde una plataforma API.
Empezar